Startseite › Tests & Bewertungen › GLM Coding Plan
GLM Coding Plan: unsere Einschätzung nach dem Test
API-Zugriff auf die GLM-Modelle, konzipiert für Code-Assistenten – von dem Labor, das seine Modellgewichte als Open Weights veröffentlicht.
Derzeit das beste Preis-Leistungs-Verhältnis, um einen Codeassistenten an ein großes Modell anzubinden – gerade weil die Modellgewichte offen sind und Ihnen eine lokale Ausweichmöglichkeit bleibt. Der Vorbehalt ist ernst zu nehmen: Ein Teil der Abonnenten hält die Kontingente des Tarifs für undurchsichtig.
Was ist das genau?
GLM ist die Modellfamilie des chinesischen Labors Zhipu AI (internationale Marke: Z.ai), das seit Januar 2026 an der Börse in Hongkong notiert ist. Ihre Besonderheit und der Grund, warum diese Website seit Monaten darüber berichtet: Die Modellgewichte werden als Open Weights veröffentlicht. GLM-5, GLM-5.1 und GLM-5.2 sind mit ihren VRAM-Anforderungen in unserem Katalog aufgeführt.
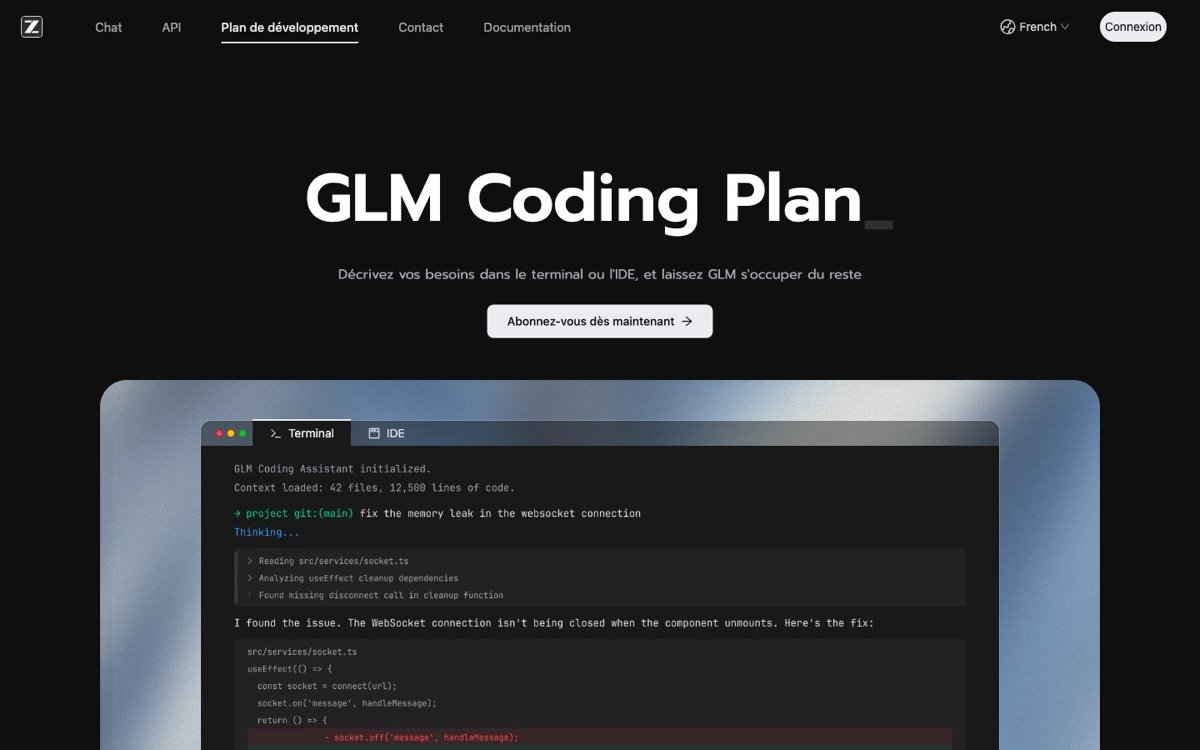
Der Coding Plan ist ein API-Abonnement mit Fokus auf Code: Er stellt die GLM-Modelle über ein mit bestehenden Assistenten (Claude Code, Cline, Roo Code) kompatibles Protokoll bereit und kostet deutlich weniger als vergleichbare amerikanische APIs. Die Idee ist einfach: Ihr Code-Tool sieht keine Unterschiede, Ihre Rechnung jedoch.
Unser Test: Wo GLM lokal auf einer Consumer-GPU an seine Grenzen stößt
Bevor wir die API beurteilt haben, haben wir die lokale Option auf unserem Testrechner (RTX 5070 Ti 12 GB + Intel Core Ultra 9 275HX, CachyOS, Ollama) bis an ihre Grenzen ausgereizt. Genau darin liegt der Vorteil einer Open-Weights-Modellfamilie: Die Frage lautet nicht „API oder nichts“, sondern „Ab wann wird die API notwendig?“. Die anhand von Messungen ermittelte Antwort, mit Zahlen belegt:
| Messung (26/08/2026) | Ergebnis |
|---|---|
| Lokal getestetes Modell | GLM-4.7-flash (quantisiert q4) |
| Speicherbedarf | 20 GB — bei 12 GB VRAM: Offloading mit 47 % auf der CPU / 53 % auf der GPU |
| Generierung (Python-Code-Aufgabe) | 35 Tokens pro Sekunde — erstaunlich flüssig |
| Promptverarbeitung (prefill) | 5,8 Tokens/s — der echte Engpass |
| Laden des Modells | 25 s |
Die Messung erzählt eine feinere Geschichte als „das hält nicht“: Selbst wenn das Modell halb auf dem CPU-System geladen ist, wird erzeugt mit einer Geschwindigkeit von 35 Tokens pro Sekunde – angenehm für Chat-Aufgaben. Aber der Promptverarbeitung erreicht höchstens 5,8 Tokens/s: Wenn Sie eine Datei mit 2.000 Tokens zur Analyse senden, vergehen bereits mehr als fünf Minuten ohne Antwort, bevor das erste Wort erscheint. Ein Code-Assistent ist aber ständig genau damit beschäftigt – Ihre Dateien bei jeder Iteration erneut zu lesen.
Eindeutiges Fazit: Auf einer Consumer-GPU mit 12 GB ist diese Modellfamilie unverwendbar als lokaler Code-Agent, nicht wegen der Generierung, sondern wegen des Prefills. Genau diese Lücke schließt der Coding Plan: dieselbe Modellfamilie, bereitgestellt mit sofortigem Prefill, während Ihre GPU frei bleibt. Und wenn Sie 24 GB VRAM oder mehr haben, rechnen Sie erneut nach – der Konfigurator liefert Ihnen das Ergebnis für Ihren Rechner.
Preise
Der Coding Plan ist in mehreren Tarifstufen verfügbar (vom Einstiegstarif für die individuelle Nutzung bis zur „Max“-Stufe für die intensive Nutzung mit mehreren Agenten). Die im August 2026 beobachteten Preise reichen von wenigen Dollar pro Monat für den Einstiegstarif bis zu einigen Dutzend Dollar für die höheren Tarifstufen – also eine Größenordnung unter vergleichbaren Abonnements von Anthropic oder OpenAI. Z.ai bietet häufig Rabattaktionen für den ersten Monat an: Prüfen Sie vor dem Abschluss eines Abonnements den aktuellen Preis, da er sich schnell ändert.
Stärken und Einschränkungen
- Offene Gewichte = keine Anbieterbindung: Ihre Prompts, Ihr Workflow und sogar das Modell bleiben lokal abrufbar
- Kompatibel mit bestehenden Codeassistenten (Claude Code, Cline, Roo Code) ohne Werkzeugwechsel
- Einstiegspreis deutlich unter den Preisen vergleichbarer US-amerikanischer APIs
- Solides Unternehmen: Zhipu AI, in Hongkong börsennotiert, eines der führenden Labore im Bereich offener Modelle
- Von einem Teil der Abonnenten als undurchsichtig empfundene Kontingente („3× Claude“ zu Spitzenzeiten umstritten) — Trustpilot 2,1/5 bei 32 Bewertungen im August 2026, behalten Sie Ihren Verbrauch in der ersten Woche im Blick
- Langsamer Kundensupport gemäß den gleichen Rückmeldungen
- Ihre Anfragen laufen über die Server von Z.ai: Für Code, der einer Geheimhaltungsvereinbarung (NDA) unterliegt, kommt das nicht infrage — das gilt für jede API, und deshalb bleibt der lokale Betrieb unser Maßstab
Häufige Fragen
Kann GLM kostenlos verwendet werden?
Ja. GLM-Modelle sind als Open-Weights veröffentlicht: Die quantisierten Varianten können kostenlos heruntergeladen und mit Ollama oder LM Studio ausgeführt werden, solange Ihre VRAM ausreicht. Die Abonnementkosten gelten nur für den API-Zugriff auf die vollständigen Varianten, die über die Infrastruktur von Z.ai bereitgestellt werden.
Funktioniert der GLM Coding Plan mit Claude Code?
Ja, das ist sein Hauptvorteil: Die API stellt ein kompatibles Protokoll bereit. Es genügt, das Tool auf den Endpunkt von Z.ai auszurichten. Cline und Roo Code werden ebenfalls unterstützt. Die Konfiguration dauert wenige Minuten.
Sind die angekündigten Nutzungskontingente zuverlässig?
Das ist der wichtigste dokumentierte Vorbehalt. Ein Teil der Abonnenten berichtet, dass das Kontingent zu Spitzenzeiten schneller als angekündigt verbraucht wird, was sich auf die Trustpilot-Bewertung des Dienstes auswirkt (2,1/5 bei einer kleinen Stichprobe von 32 Bewertungen). Unser Rat: Wählen Sie den Einstiegstarif, messen Sie eine Woche lang Ihre tatsächliche Nutzung und entscheiden Sie dann.
Wohin gelangen meine Daten bei diesem Tarif?
Ihre Anfragen werden auf den Servern von Z.ai verarbeitet. Bei proprietärem Code unter einer Geheimhaltungsvereinbarung (NDA) oder bei regulierten Daten gilt weiterhin dieselbe Regel: Bleiben Sie bei einem lokalen Modell – genau das ist mit dieser Modellfamilie möglich, da die Gewichte offen verfügbar sind.
Welche Maschine benötigt man, um GLM lokal auszuführen?
Die kleinen quantisierten Varianten laufen auf einer GPU mit 8 bis 12 GB. Neuere MoE-Varianten (GLM-4.7-flash: in q4 geladen etwa 20 GB, auf unserem Rechner gemessen) benötigen mehr – das lässt sich in unserem Konfigurator messen, der Ihnen genau sagt, was Ihr Rechner bewältigen kann.
Weitere Bewertungen aus der Auswahl
Transkription, Untertitel und Übersetzung durch KI, optional mit menschlicher Überprüfung — das europäische Unternehmen mit der besten Bewertung in unserer Auswahl.
Zur Rezension →Eine Konversation in einen wiederverwendbaren Agenten umwandeln, der mit Ihren Tools verbunden ist — ohne Code zu schreiben.
Zur Rezension →Online-Bootcamps – Data Science & KI, Cybersicherheit, UX und Webentwicklung – mit deutscher Qualitätsakkreditierung.
Zur Rezension →Transparenz. Der Link „GLM Coding Plan ansehen“ ist ein Affiliate-Link (Plattform Impact.com). Wenn Sie ein Abonnement abschließen, erhält WelchesLLM eine vom Anbieter gezahlte Provision, ohne zusätzliche Kosten für Sie. Diese Provision beeinflusst weder die Bewertung noch den Inhalt: Die kostenlose lokale Alternative wird vor dem Kauflink genannt, und die aus Kundenbewertungen hervorgehenden Vorbehalte werden unverändert veröffentlicht. Vollständige Methodik · Impressum.