MacBook Pro M5 Max 128 GB: die tatsächlichen Messwerte für lokale KI (Benchmark 2026)
Ein MacBook Pro M5 Max mit 40 GPU-Kernen und 128 GB Unified Memory, ein im Voraus verfasstes Protokoll, sechs Modelle, ein Dokument mit 16 689 Tokens: Hier sind die ersten öffentlichen Messwerte zum größten tragbaren Apple im Bereich der lokalen KI. Die Messungen wurden von Joël Ramat, einem Berater für Cybersicherheit und GRC, auf seinem eigenen Gerät, auf unsere Anfrage und nach unserem Protokoll durchgeführt. Alle Zahlen sind die unveränderten Rohdaten von Ollama.
Wählen Sie einen Rechner? Unsere Empfehlungen nach Budget →
Das MacBook Pro M5 Max ist heute auf Lager: MacBook Pro M5 Max — 36 GB / 2 TB.
Warum diese Wahl? Unsere vollständige Übersicht zu MacBook Pro M5 Max — 36 GB / 2 TB →
Alle Optionen nach Budget vergleichen, von 800 bis 3 500 € →
Unterwegs: Welcher Laptop für lokale KI →
Affiliate-Links — mögliche Provision ohne zusätzliche Kosten für Sie. Als Amazon-Partner verdient WelchesLLM an qualifizierten Käufen.
#Die Maschine und das Protokoll
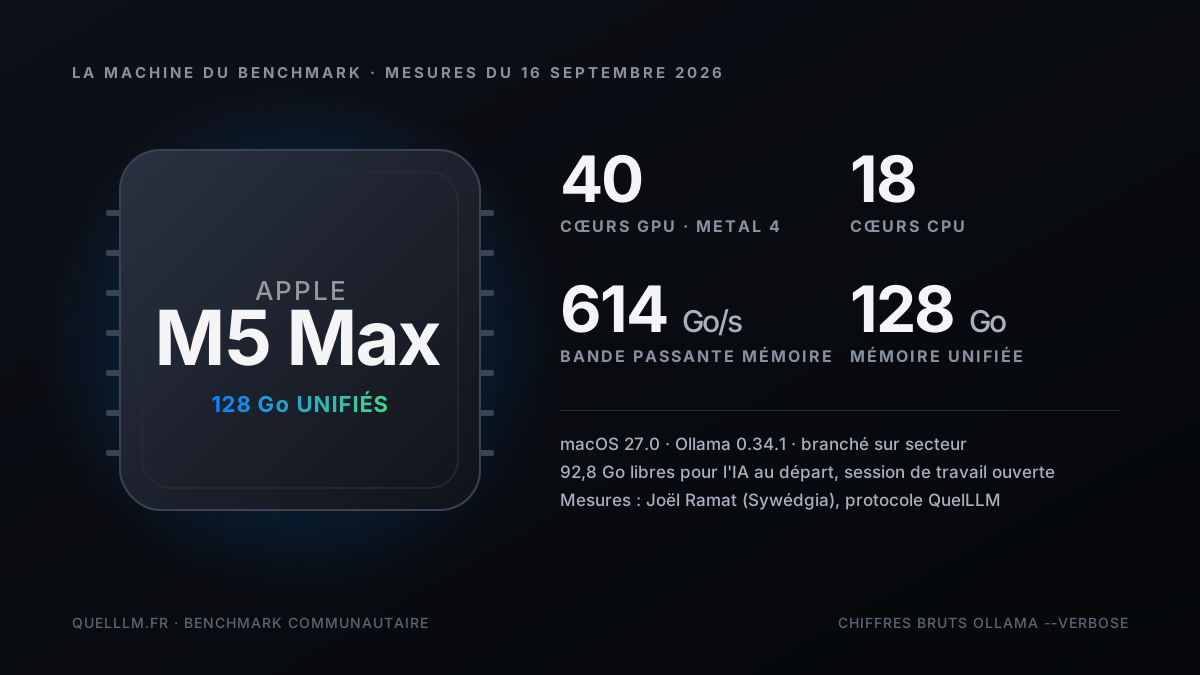
Das Gerät ist ein 16-Zoll-MacBook Pro mit dem voll ausgebauten M5-Max-Chip: 18 CPU-Kerne, 40 GPU-Kerne und 128 GB vereinheitlichter Speicher mit einer angegebenen Bandbreite von 614 GB/s. Es läuft unter macOS 27.0 mit Ollama 0.34.1. Es wurden keine Systemeinstellungen verändert: Die GPU-Speichergrenze entspricht dem Standardwert, was für den Vergleich mit Ihrem eigenen Mac wichtig ist.
Das Protokoll umfasst vier Regeln, und diese sind keineswegs bloß Beiwerk. Der Mac ist ans Stromnetz angeschlossen, weil macOS den Chip im Akkubetrieb drosselt. Ressourcenintensive Anwendungen sind geschlossen. Es ist jeweils nur ein Modell geladen. Und vor allem wird für alle Messreihen derselbe Prompt verwendet, damit die Zahlen zwischen Modellen und künftig auch zwischen Rechnern vergleichbar sind.
- Serie A, die beiden Referenzen
- Gemma 4 12B und Qwen 3.8 27B im GGUF-Format, zwei Modelle, die auch auf deutlich bescheidener ausgestatteten Macs laufen. Sie ermöglichen es, die Maschine auf einer bekannten Skala einzuordnen.
- Serie B, MLX gegenüber GGUF
- Dasselbe Qwen 3.8 27B, dieselben Modellgewichte, bereitgestellt über Ollamas MLX-Engine statt über llama.cpp. Nur die Engine ändert sich.
- Serie C: der eigentliche Schwerpunkt bei der 128-GB-Stufe
- gpt-oss 120B, 65 GB, ein Modell, das schlicht nicht in den Speicher eines PC-Laptops passt.
- Serie D: Prefill unter realer Last
- Ein Dokument mit 16.689 Tokens wurde in einem Stück an gpt-oss 120B gesendet, mit der Anweisung, eine Zusammenfassung zu erstellen. Dies ist die einzige aussagekräftige Prefill-Messung der Testkampagne.
- Zwei zusätzliche Messungen außerhalb des Testprotokolls
- Joël hatte bereits Qwen 3.6 35B-A3B in MLX und gpt-oss 20B auf seinem Gerät. Er hat sie unter den gleichen Bedingungen gemessen.
#Alle Zahlen in einer Tabelle
Lokale KI auf Ihrem Mac voll ausschöpfen: Unified Memory, MLX vs. GGUF, das passende Modell für Ihren Chip und auf Apple Silicon abgestimmte Einstellungen für Ollama und LM Studio.
- Lebenslanger Online-Zugang
- PDF + Dateien
- Lebenslange Updates
Hier sind die unveränderten Ausgaben des Befehls ollama run --verbose, so wie Joël sie nach jeder Messung kopiert hat. Jedes Modell hat eine vollständige Antwort auf den 300-Wörter-Prompt erzeugt, im Reasoning-Modus, sofern das Modell darüber verfügt. Das erklärt die 1.400 bis 3.200 generierten Tokens für 300 Wörter endgültigen Text.
| Modell | Engine | Modellgröße | Generierung | Erzeugte Tokens | Gesamtdauer |
|---|---|---|---|---|---|
| Gemma 4 12B | GGUF Q4 | 7,6 GB | 58,1 Tok/s | 1 390 | 24 s |
| Qwen 3.8 27B | GGUF Q4 | 17 GB | 36,6 Tok/s | 2 517 | 69 s |
| Qwen 3.8 27B | MLX | 18 GB | 68,0 Tok/s | 2 103 | 31 s |
| Qwen 3.6 35B-A3B (Bonus) | MLX | 23 GB | 167,2 Tok/s | 3 205 | 19 s |
| gpt-oss 20B (Bonus) | MXFP4 | 13 GB | 113,4 Tok/s | 2 199 | 19 s |
| gpt-oss 120B | MXFP4 | 65 GB | 79,1 Tok/s | 669 | 8,5 s |
| gpt-oss 120B, Wiederholung 1 | MXFP4 | 65 GB | 77,5 Tok/s | 732 | 12,5 s |
| gpt-oss 120B, Neustart 2 | MXFP4 | 65 GB | 75,5 Tok/s | 1 707 | 22,7 s |
| gpt-oss 120B, Serie D | MXFP4 | 65 GB | 67,6 Tok/s | 2 584 | 50 s |
| Serie | Prompt-Tokens | Prefill | Zeit bis zum ersten Wort |
|---|---|---|---|
| A, B, C (kurzer Prompt) | 43 à 98 | 31 bis 346 Tok/s | 0,1 bis 0,9 Sekunden: Startlatenz, kein Durchsatz |
| D, Dokument mit 16.689 Tokens | 16 689 | 1 388 Tok/s | 12,0 s |
#Generierung: sechs Modelle, eine Lesung
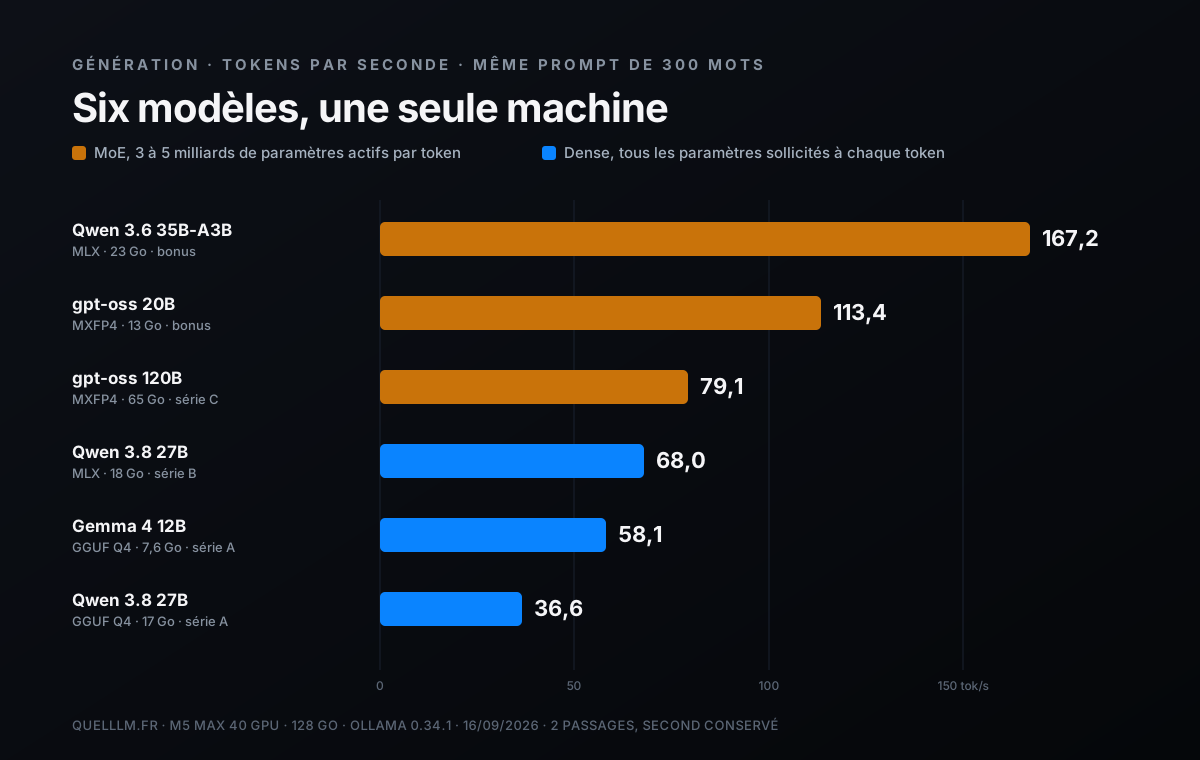
Auf den ersten Blick wirkt diese Rangliste absurd: ein Modell mit 120 Milliarden Parametern, das 79 Tokens pro Sekunde generiert und damit doppelt so schnell ist wie ein 27B-Modell im GGUF-Format. Die Erklärung steckt in drei Buchstaben. gpt-oss 120B, gpt-oss 20B und Qwen 3.6 35B-A3B sind Mixture-of-Experts-Modelle, kurz MoE. Bei jedem Token wird nur ein Bruchteil der Parameter genutzt: etwa 5 Milliarden bei gpt-oss 120B, 3,6 Milliarden bei gpt-oss 20B und 3 Milliarden bei Qwen. Die Generierungsgeschwindigkeit hängt davon ab, was bei jedem Token im Speicher bewegt wird, nicht davon, was dort schläft.
Dichte Modelle wie Gemma 4 12B und Qwen 3.8 27B nutzen bei jedem Token alle ihre Parameter. Ihre Geschwindigkeit richtet sich daher nach der Speicherbandbreite geteilt durch die Modellgröße: Diese Regel gilt für Macs seit dem M1, und auch der M5 Max bildet keine Ausnahme. Auf dieser Maschine läuft ein dichtes 27B-Modell im GGUF-Format mit 37 Tokens pro Sekunde, ein 12B-Modell mit 58.
- 167 tok/s mit Qwen 3.6 35B-A3B unter MLX
- Der höchste Wert der Messkampagne stammt von dem Modell, das beide Beschleuniger kombiniert: die MoE-Architektur und die MLX-Engine. Es bietet die Geschwindigkeit eines kleinen 8B-Modells mit dem Wissen eines 35B-Modells.
- 113 tok/s mit gpt-oss 20B
- Das beste Verhältnis von Geschwindigkeit, Qualität und Speicherbedarf für den täglichen Einsatz als Assistent: 13 GB, eine Antwort mit 2.200 Tokens in 19 Sekunden.
- 79 tok/s mit gpt-oss 120B
- Das leistungsfähigste Modell der Liste, mit der doppelten menschlichen Lesegeschwindigkeit. Dieses Ergebnis rechtfertigt die 128-GB-Stufe; darauf kommen wir weiter unten zurück.
- 58 und 37 Tok/s bei dichten Modellen
- Gemma 4 12B und Qwen 3.8 27B im GGUF-Format: gut nutzbar, aber ohne Überraschungen. Die Werte liegen in denselben Größenordnungen wie auf einem M4 Max, da sich die Bandbreite zwischen den beiden Generationen kaum verändert hat.
#MLX gegen GGUF, unter gleichen Bedingungen
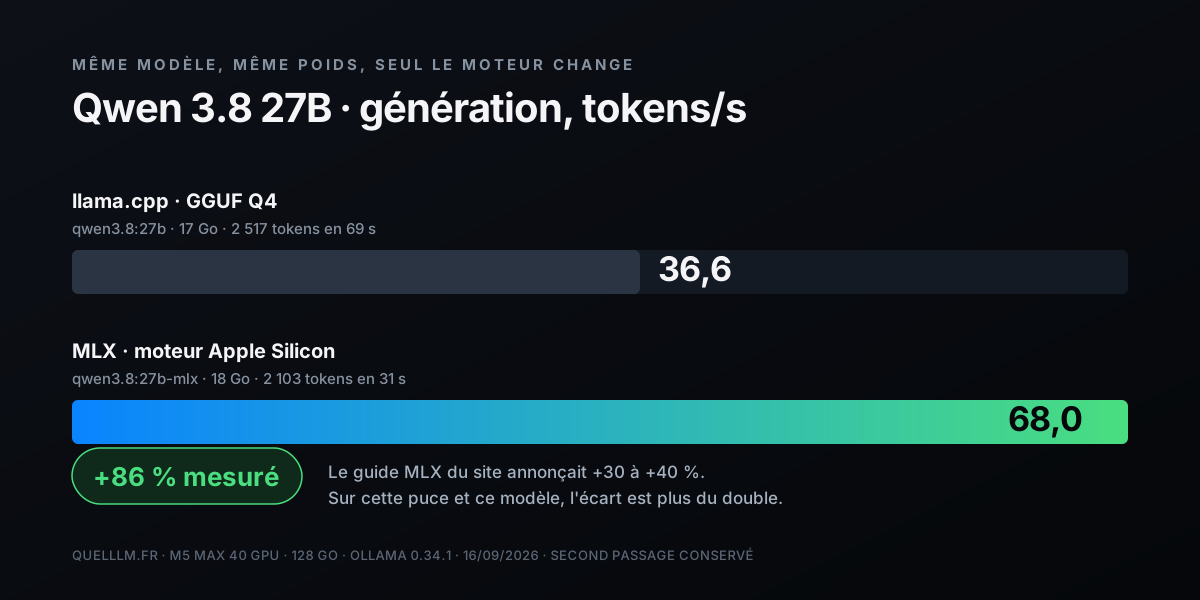
Alle behaupten, dass MLX, Apples für Apple Silicon optimierte Bibliothek, schneller als llama.cpp ist. Nur sehr wenige messen das unter exakt gleichen Bedingungen, mit demselben Modell, am selben Tag und auf derselben Maschine. Genau das tut die Messreihe B: Qwen 3.8 27B in GGUF Q4 mit 36,6 Tokens pro Sekunde, dann Qwen 3.8 27B mit MLX bei 68,0 Tokens pro Sekunde. Ein Plus von 86 %.
Unser Leitfaden zu MLX und dem Mac M5 kündigte einen Leistungszuwachs von 30 bis 40 % bei der Generierung an. Auf dem M5 Max fällt der Zuwachs mit diesem Modell tatsächlich mehr als doppelt so groß aus. Ein Teil des Unterschieds ist vermutlich auf die MLX-Optimierungen speziell für die M5-Generation und die in die GPU integrierten neuronalen Beschleuniger zurückzuführen; ihren Beitrag können wir noch nicht isolieren. Was wir sagen können: Auf einem aktuellen Mac ein dichtes Modell im GGUF-Format auszuführen, obwohl es eine MLX-Version davon gibt, ist so, als ließe man die Hälfte der Maschine in der Garage stehen.
#Was 128 GB tatsächlich bieten
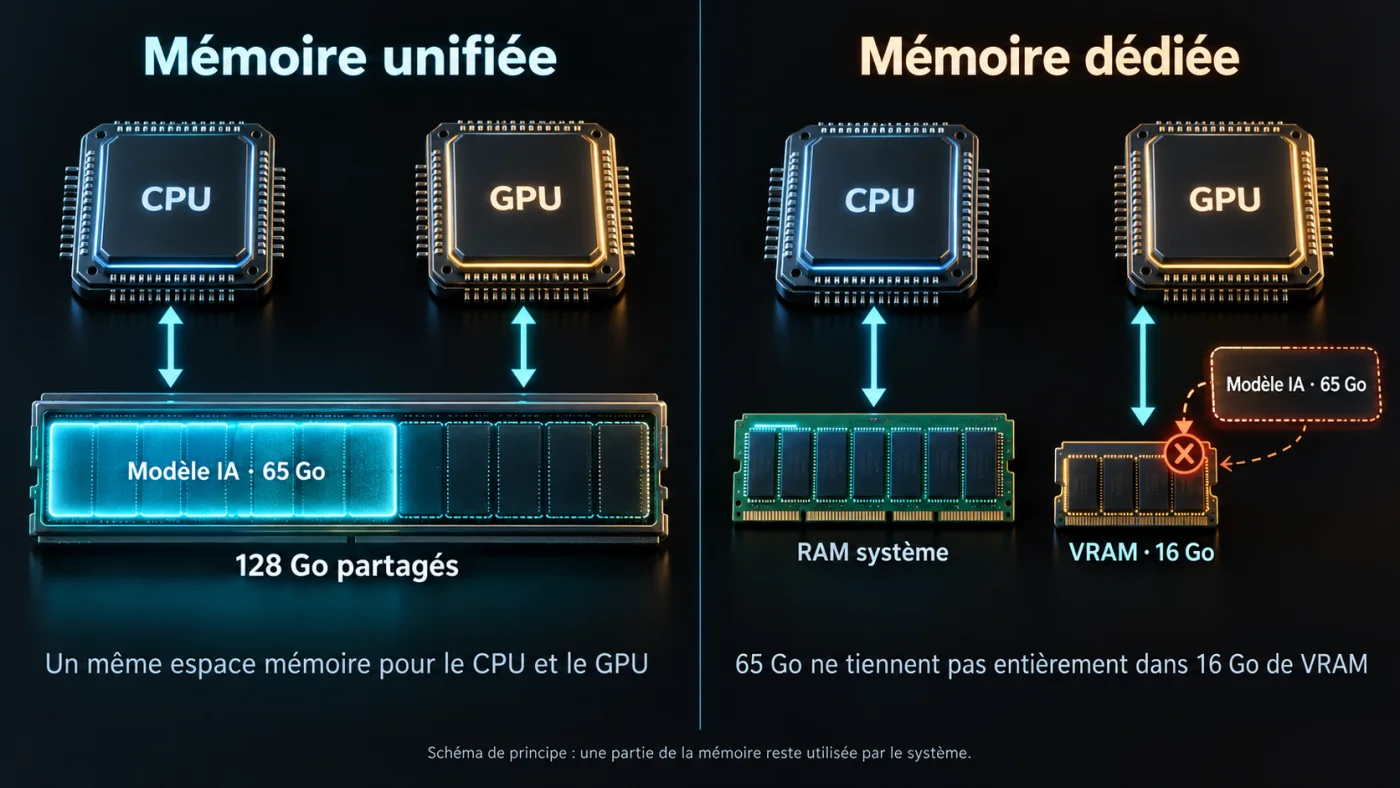
Bei der Speicherstufe von 128 GB geht es vor allem nicht um die Geschwindigkeit, sondern darum, welche Modelle hineinpassen. gpt-oss 120B belegt in MXFP4 65 GB. Kein PC-Notebook kann das Modell auf der GPU ausführen: Mobile Grafikkarten sind auf 16 oder 24 GB VRAM begrenzt. Auf dem M5 Max mit 128 GB lässt es sich laden, liefert in drei Durchläufen zwischen 75 und 79 Tokens pro Sekunde, und es bleibt noch Speicher frei.
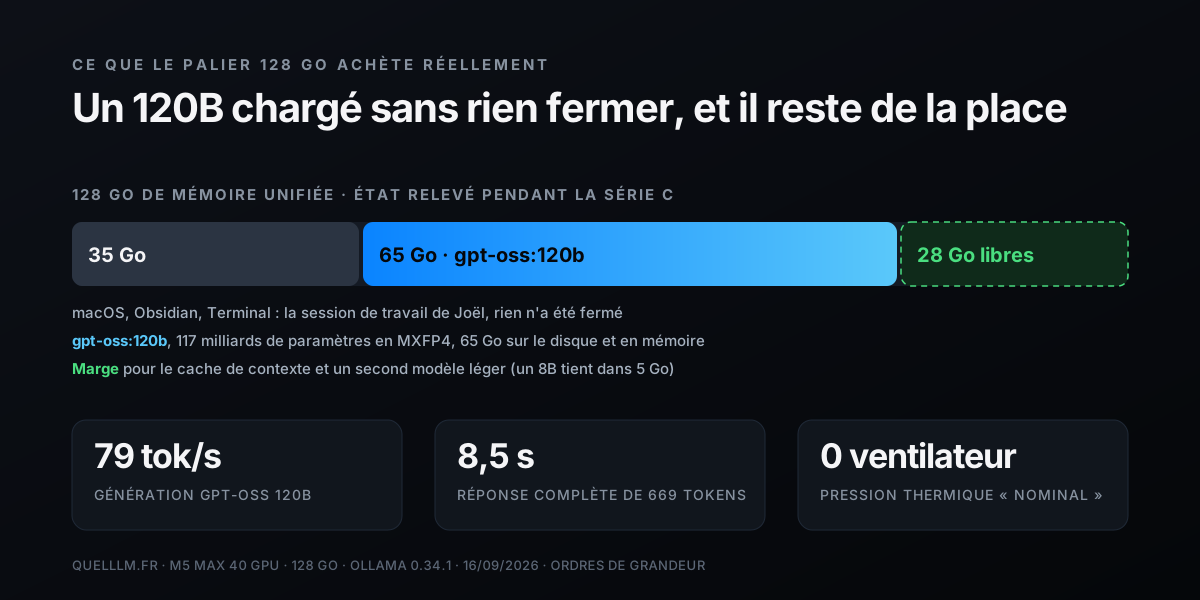
Die vor der Testkampagne erfasste Speicherbelegung ist aussagekräftig: 35 GB waren durch macOS und die Anwendungen der laufenden Arbeitssitzung belegt, 93 GB standen für die KI zur Verfügung. Das 120B-Modell passt hinein und lässt rund dreißig Gigabyte Spielraum – genug für einen langen Kontext und ein zweites kleines Modell, das parallel läuft, etwa ein 8B-Modell für die Code-Autovervollständigung. Auf einem M5 Max mit 64 GB lässt sich dasselbe Modell überhaupt nicht laden; mit 96 GB passt es, aber ohne Spielraum für den Rest.
- 8,5 bis 22,7 Sekunden
- Gesamtdauer der Antwort von gpt-oss 120B auf einen 300-Wort-Prompt bei drei Durchläufen: 669, 732 und anschließend 1.707 erzeugte Tokens. Die Geschwindigkeit bleibt konstant (79,1, 77,5 und 75,5 Tokens pro Sekunde), doch die Länge des Denkprozesses variiert von Durchlauf zu Durchlauf, je nachdem, ob das Modell seine Wörter einzeln zählt oder nicht.
- 50 Sekunden
- Dauer der Serie D: Lesen eines Dokuments mit 16.689 Tokens und Erstellen einer Zusammenfassung in zehn Punkten mit 2.584 Tokens.
- Thermische Belastung „Nominal“
- Nach jeder Messreihe erfasst. Während der gesamten Messkampagne war kein Lüfter hörbar, auch nicht bei 120B.
#Der Prefill, die Zahl, die niemand veröffentlicht
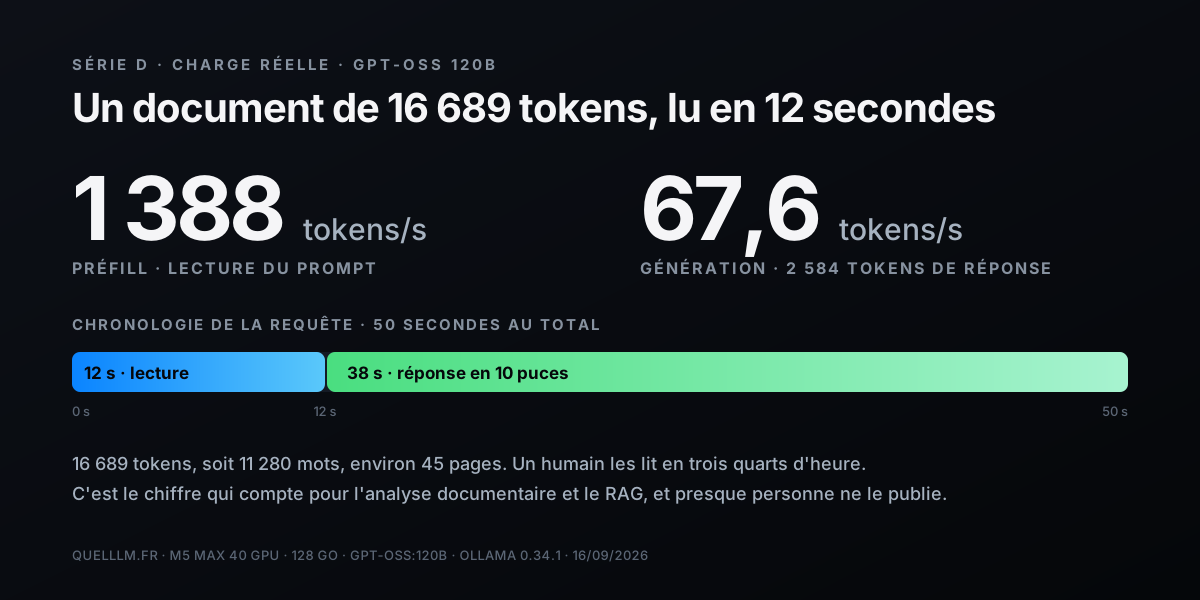
Ein Prompt mit zwanzig Wörtern sagt nichts über das Prefill aus. Um es zu messen, schickte Joël gpt-oss 120B einen Text mit 11.280 Wörtern als einen einzigen Block, also 16.689 Tokens und etwa 45 Seiten, mit der Anweisung, eine Zusammenfassung zu erstellen. Ergebnis: 1.388 Tokens pro Sekunde beim Einlesen, also zwölf Sekunden, bis das erste Wort der Antwort erschien, anschließend eine Zusammenfassung mit 2.584 Tokens bei 67,6 Tokens pro Sekunde.
Diese Zahl ist für anspruchsvolle Anwendungen aussagekräftig. Einen Vertrag analysieren, einen Auditbericht zusammenfassen, eine Dokumentenbasis per RAG abfragen: In all diesen Fällen verbringt das Modell den größten Teil seiner Zeit mit Lesen, nicht mit Schreiben. Zwölf Sekunden für 45 Seiten auf einem Laptop, ohne dass ein einziges Byte die Maschine verlässt – das macht lokale KI für einen Berater mit beruflicher Schweigepflicht oder ein Unternehmen mit Vertraulichkeitsanforderungen nutzbar.
#Wärme und Lüfter
Joël hat den thermischen Zustand nach jeder Serie mit dem macOS-Befehl zur Ermittlung des thermischen Drucks dokumentiert. Das Ergebnis war stets „Nominal“, und es waren keine Lüftergeräusche hörbar, auch nicht während der Serie D, die die GPU fünfzig Sekunden lang voll auslastet. Das stimmt mit den Beobachtungen bei den M4 Max überein, allerdings mit einer Einschränkung: Unsere Messungen bestehen aus kurzen Belastungsphasen von weniger als einer Minute. Der im Protokoll vorgesehene Throttling-Test – zehn Minuten Dauerlast und anschließend eine erneute Messung der Serie A – wurde nicht durchgeführt. Wir werden bei der nächsten Messkampagne darum bitten.
#Was diese Messungen nicht aussagen
Ein ehrlicher Benchmark listet auch das, was er nicht beweist. Hier sind die Einschränkungen in Reihenfolge der Bedeutung.
- Prefill bei kurzen Prompts
- Zwei Durchläufe pro Modell, der zweite wird für die Auswertung verwendet. Mit Prompts von 43 bis 98 Tokens wird jedoch nur die Startlatenz gemessen: Nur die Serie D mit 16.689 Tokens liefert einen echten Lesedurchsatz.
- Kein dichtes Modell mit 70 Milliarden Parametern
- Die Speicherstufe mit 128 GB ist auch für 70B-Modelle in Q4 mit langem Kontext gerechtfertigt. Hier nicht gemessen.
- Kein Test auf Throttling
- Kurze Lastphasen von weniger als einer Minute. Das Verhalten bei einer Stunde intensiver RAG-Nutzung muss noch dokumentiert werden.
- Keine Messung im Akkubetrieb
- Das Protokoll schreibt Netzbetrieb vor. Rechnen Sie im Akkubetrieb mit deutlich niedrigeren Werten, da macOS den Chip drosselt.
- Ein individuelles Dokument für die Testreihe D je Tester
- Der lange Text, der in Serie D übermittelt wird, ist vom Protokoll nicht vorgegeben: Zwei Tester lesen nicht dasselbe Dokument, was die Vergleichbarkeit der Prefill-Messungen zwischen verschiedenen Maschinen einschränkt. Auf Vorschlag von Joël stellt das Protokoll nun einen einheitlichen Referenztext mit 11.292 Wörtern bereit, der im folgenden Abschnitt heruntergeladen werden kann: Die nächsten Messungen werden untereinander vergleichbar sein. Die Messung auf dieser Seite wurde zuvor mit einem anderen Dokument vergleichbarer Größe durchgeführt.
- Ein einziger Rechner, ein einziger Bediener
- Keine Varianz gemessen. Wenn Sie dieselbe Konfiguration verwenden, sind Ihre Messwerte willkommen; siehe den folgenden Abschnitt.
- Modelle im Reasoning-Modus
- Modelle, die vor der Antwort nachdenken, erzeugen deutlich mehr Tokens als die 300 geforderten Wörter, und diese Länge variiert von einer Ausführung zur nächsten für das gleiche Modell (669 bis 1.707 Tokens auf gpt-oss 120B). Die Gesamtlaufzeiten sind daher nicht vergleichbar, nur die Geschwindigkeiten sind das.
- Prompt-Cache bei Wiederholungen
- Wenn der gleiche Prompt erneut gestartet wird, verwendet Ollama die bereits gelesenen Tokens („prompt eval cached“). Der Pre-fill bei einer identischen Wiederholung ist daher keine Messung; um den Pre-fill zu messen, benötigt man einen langen, neuen Prompt, wie bei Serie D.
#Den Benchmark bei sich zu Hause reproduzieren
Das Protokoll ist so konzipiert, dass es auf jedem Mac mit Apple Silicon, vom MacBook Air bis zum Mac Studio, unverändert wiederholt werden kann. Wenn Sie dieselben Testreihen mit demselben Prompt durchführen, sind Ihre Zahlen direkt mit denen auf dieser Seite vergleichbar.
- 01Die Maschine vorbereitenSchließen Sie das Gerät an die Stromversorgung an und schließen Sie den Browser, Docker und die virtuellen Maschinen. Notieren Sie Ihr Chipmodell, die Anzahl der GPU-Kerne und die Ollama-Version.
- 02Den Systemzustand erfassenNotieren Sie den Chip, die Anzahl der GPU-Kerne, die Versionen von macOS und Ollama, die Stromversorgung, den verfügbaren Speicher und die geöffneten Anwendungen. Joël hat ein zsh-Skript geschrieben, das diesen Bericht mit einem einzigen Befehl erstellt; es wird nach Überprüfung mit seiner Zustimmung in das Benchmark-Kapitel des Mac-Kits aufgenommen.
- 03Serie ALaden Sie gemma4:12b und qwen3.8:27b herunter, starten Sie jedes Modell mit --verbose, fügen Sie den gemeinsamen Prompt ein, lassen Sie die Antwort vollständig generieren und beenden Sie mit /bye. Führen Sie zwei Durchläufe durch und behalten Sie den zweiten.
- 04Serie BDasselbe mit qwen3.8:27b-mlx durchführen. Vergleichen Sie die Zeile eval rate mit der entsprechenden Zeile aus Serie A.
- 05Serie CWenn Sie 96 GB oder mehr haben: gpt-oss:120b. Andernfalls wählen Sie das größte Modell, das in Ihren vereinheitlichten Speicher abzüglich 10 GB passt.
- 06Serie DLaden Sie den QuelLLM-Referenztext mit 11.292 Wörtern herunter, der für alle identisch ist, und übergeben Sie ihn an ollama run, gefolgt von der Anweisung „Fasse diesen Text in 10 Stichpunkten zusammen“. Notieren Sie die angezeigte Anzahl der Prompt-Tokens: Sie hängt vom Modell ab, nicht vom Text.
#Für wen und zu welchem Preis
Der M5 Max mit 128 GB rechtfertigt sich durch einen einzigen Einsatzzweck: Modelle lokal auszuführen, die in keinen anderen Laptop passen, mit Spielraum für den Kontext und ein zweites Modell. gpt-oss 120B mit 79 Tokens pro Sekunde und ein 45-seitiges Dokument, das in zwölf Sekunden gelesen wird, ohne Lüfter – das ist eine KI-Workstation, die in eine Tasche passt.
| Sie sind | Was dieser Benchmark Ihnen sagt | Empfohlene Stufe |
|---|---|---|
| Berater, Anwalt oder Steuerberater mit beruflicher Schweigepflicht | Ein 120B-Modell liest Ihre Unterlagen lokal und fasst sie mit einer praxistauglichen Geschwindigkeit zusammen, ohne etwas nach außen zu senden | M5 Max 128 GB |
| Entwickler, der einen leistungsfähigen lokalen Copiloten möchte | gpt-oss 20B oder Qwen 3.6 35B-A3B reichen vollkommen aus und passen in 48 GB. Unsere Werte von 113 und 167 tok/s gelten für den Chip mit 40 GPU-Kernen: Der Speicher reicht aus, auf einer Variante mit geringerer Bandbreite wird die Geschwindigkeit niedriger sein | M5 Max 48 oder 64 GB |
| Täglicher Nutzer eines Schreibassistenten | Ein dichtes 12B-Modell oder ein 20B-MoE-Modell decken diesen Einsatz ab; 128 GB sind Luxus. Der Speicher reicht aus, aber der des M5 Pro ist langsamer: Rechnen Sie mit weniger als unseren 58 und 113 tok/s | M5 Pro 48 GB |
| Team, das einen gemeinsam genutzten Server möchte | Der Mac Studio M5 Max oder Ultra bietet dieselbe technische Basis mit mehr Speicher und einer Kühlung für Desktop-Rechner | Mac Studio |
Wenn Sie höchstens Modelle mit 30 Milliarden Parametern benötigen, reicht die Hälfte des Speichers aus, und vom Preisunterschied lässt sich ein sehr guter Monitor finanzieren. Wenn Ihr Bedarf erst bei Modellen mit 100 Milliarden Parametern beginnt, gibt es keine tragbare Alternative. Dieser Leitfaden liefert Ihnen die Zahlen, um diese Wahl gegenüber der Person zu begründen, die die Bestellung unterschreibt.
#Quellen und Credits
Die Messungen auf dieser Seite wurden von Joël Ramat durchgeführt. Er ist Berater für Cybersicherheit und GRC, ISO-27001-Experte, bietet durch On-Premise-KI unterstützte Beratung und Audits an und ist Mitgründer und Präsident von Sywédgia SAS. Er hat das QuelLLM-Protokoll am 16. September 2026 auf seinem eigenen Rechner ausgeführt und diesen Artikel vor der Veröffentlichung gegengelesen. Die Messdaten bleiben seine eigenen, und es steht ihm frei, sie selbst zu veröffentlichen.
- Joël Ramat auf LinkedIn
- Sywédgia, Beratung und Cybersecurity-Audit
- Unser Leitfaden zum Vergleich von MLX und llama.cpp auf dem Mac M5
- Hardware-Infos für MacBook Pro M5 Max
- Installieren Sie gpt-oss mit Ollama
Methode: Rohausgaben von ollama run --verbose nach jeder Messung unverändert kopiert; Systemzustand vor der Messkampagne per Skript erfasst; thermische Belastung nach jeder Messreihe ausgelesen. Der vollständige Bericht mit den ungekürzten Antworten der Modelle wird aufbewahrt und kann auf Anfrage bereitgestellt werden. Redaktion und Formatierung: Mohamed Meguedmi, WelchesLLM.
#FAQ
Ist der M5 Max 128 GB schneller als der M4 Max 128 GB bei lokaler KI?+
Warum ist gpt-oss 120B schneller als Qwen 3.8 27B?+
Braucht man 128 GB, um gpt-oss 120B zu betreiben?+
Gilt das auch bei Akkubetrieb?+
Warum werden die Prefills der Serien A, B und C nicht veröffentlicht?+
Kann ich meine eigenen Messungen senden?+
Wo findet man das für diesen Benchmark verwendete Vorbereitungsskript?+
Haben Sie Feedback, einen Fehler entdeckt oder möchten Sie etwas präzisieren? Geben Sie uns Bescheid – so wird der Guide für alle besser.