GIGABYTE AI TOP ATOM: Die 128-GB-GB10 im Detail gemessen
Der KI-Mini-PC von GIGABYTE: NVIDIA-GB10-Chip und 128 GB gemeinsamer Speicher in einem Liter. Wir sehen uns an, worauf es beim Ausführen von LLMs ankommt lokal : Speicher, Bandbreite, Geschwindigkeit, Preis – und für wen sich der Kauf lohnt und für wen nicht.
Aktualisiert am 09/10/2026
Wo kaufen
Die über den Button angebotene Konfiguration entspricht der beim Kauf angebotenen. Halten Sie bei Mini-PCs Speicher für das System frei und prüfen Sie die Inferenz-Engine; macOS/MLX und CUDA sind nicht austauschbar.
Affiliate-Links — QuelLLM kann bei Käufen eine Provision erhalten, ohne dass dies für Sie zusätzliche Kosten verursacht. Dies beeinflusst diese Empfehlungen (die unabhängig erstellt wurden) nicht. Als Amazon-Partner erzielt QuelLLM Einnahmen aus qualifizierten Käufen.
Technische Daten
- Speicher128 GB vereinheitlicht (LPDDR5x), 121,7 GB vom System erkannt
- Bandbreite273 GB/s
- BerechnungBlackwell-GPU und 20 Arm-Kerne; bis zu 1 PFLOP in FP4 mit Sparsity laut NVIDIA (Ankündigung, nicht von uns gemessen)
- Verbrauch240-W-USB-C-Adapter; GPU im Leerlauf mit 10,4 W und unter Last in unseren Messungen durchschnittlich mit 39 bis 53 W (nur GPU, ohne Wattmeter)
- Richtpreis6 346,27 € (ATAGB10-9001, 4 TB PCIe 4.0, offizieller AORUS-Shop, ausverkauft; bei Amazon.fr auf Lager) · 7 999,95 € (ATAGB10-9000, 4 TB PCIe 5.0, LDLC und Materiel.net, nicht verfügbar) — Erhebung vom 08.10.2026
- Größtes ModellQwen3-235B-A22B mit 3 Bit (90,5 GB belegt, 21 GB Spielraum) · Llama 3.3 70B mit etwa 5 Tokens pro Sekunde, 2,6- bis 4-mal schneller mit einem kleinen Entwurfsmodell · gpt-oss 120B mit 58 Tokens pro Sekunde; unsere 13 Modelle, von 4B bis 235B, kommen mit 32 768 Kontext-Tokens aus
Für wen?
Vorteile und Grenzen
✓ Stärken
- 128 GB gemeinsamer Speicher: Unsere 13 Modelle vom 4B- bis zum 235B-Modell (mit 3 Bit) passen mit einem Kontext von 32 768 Token hinein
- Die Geschwindigkeiten des DGX Spark von NVIDIA, höchstens 4,3 % Abweichung mit llama.cpp und 2 % mit Ollama
- Stabile Geschwindigkeit unter Dauerlast: 0,0 % Abweichung in 1 h bei 16 Nutzern, −0,6 % in 2 h bei 8 Nutzern, keine Drosselung festgestellt
- 4-TB-SSD PCIe 5.0 im ATAGB10-9000: 13 GB/s beim Lesen
- Vollständiger CUDA-Stack: llama.cpp, vLLM, TensorRT-LLM und Unsloth liefen bei uns
- Ein-Liter-Gehäuse, 1,2 kg, schlichtes Frontdesign
✗ Einschränkungen
- Höherer Preis als ein Mini-PC mit Ryzen AI Max+ 395 und 128 GB
- Ein dichtes 70B-Modell schreibt mit etwa 5 Token pro Sekunde, begrenzt durch die Bandbreite der GB10-Plattform (273 GB/s): Ein MoE-Modell oder ein kleiner Entwurf (×2,6 bis ×4) ermöglicht Gesprächsgeschwindigkeiten
Was wir gemessen haben
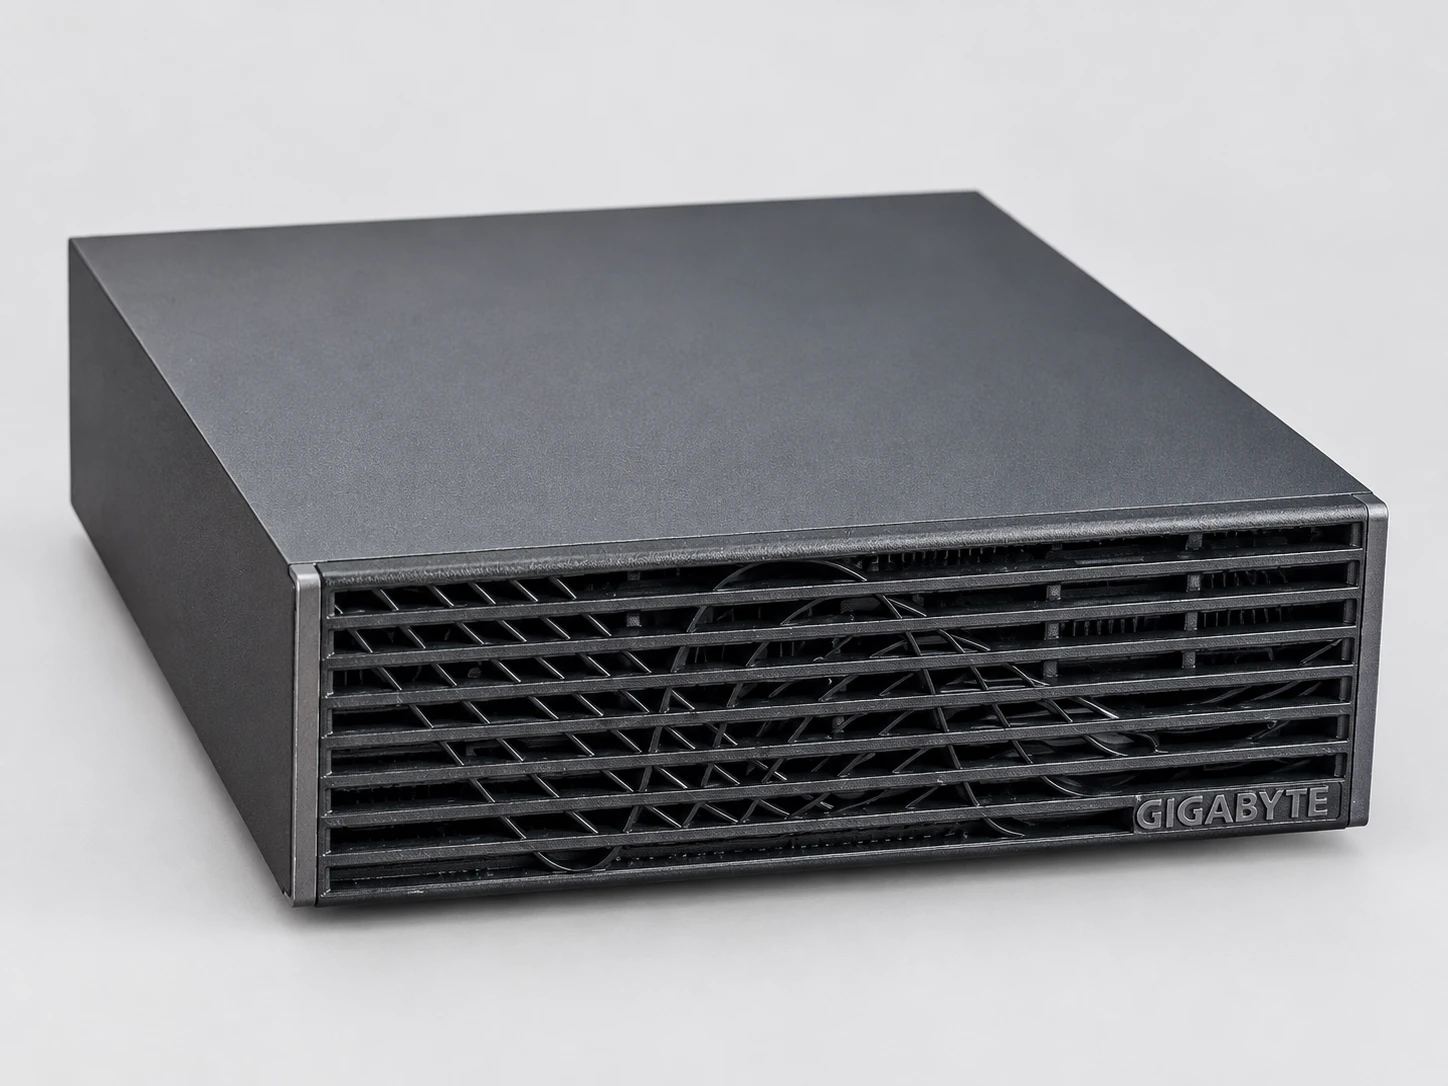
GIGABYTE hat uns unentgeltlich eine AI TOP ATOM (ATAGB10-9000: 128 GB, 4-TB-SSD PCIe 5.0) für eine Reihe von Leitfäden zur Verfügung gestellt. Die Messungen und Einschätzungen stammen von uns; GIGABYTE hat diesen Inhalt vor seiner Veröffentlichung weder redigiert noch freigegeben. Die Methodik (vor der ersten Messung festgelegtes Protokoll), die Fingerabdrücke der Modelldateien und die Daten unserer Tabellen sind auf unserer Methodikseite. Unsere Daten, Infografiken und Fotos dürfen unter Lizenz wiederverwendet werden CC BY 4.0, unter Angabe von quelllm.fr.
| Guide | Was es zeigt |
|---|---|
| Welche LLMs tatsächlich laufen | 13 Modelle von 4B bis 235B: Alle kommen mit 32 768 Kontext-Tokens aus; gpt-oss 120B mit 58 Tokens pro Sekunde |
Die Reihe umfasst 7 Anleitungen, die einmal pro Woche veröffentlicht werden: Diese Seite wird mit jeder neuen Anleitung erweitert.
Die AI-TOP-ATOM-Modelle
GIGABYTE bietet die ATOM in sechs Varianten an, von ATAGB10-9000 bis ATAGB10-9005. Die ersten drei verfügen über 128 GB: 9000 mit einer 4-TB-SSD über PCIe 5.0 (die von uns gemessene), 9001 mit 4 TB über PCIe 4.0, 9002 mit 1 TB über PCIe 4.0. Eine 64-GB-Version ist ab dem 23. Oktober 2026 angekündigt. Überprüfen Sie die genaue Modellnummer beim Händler: Einige Datenblätter beschreiben die SSD falsch.
Für wen
- Ein Team aus 5 bis 20 Personen die einen privaten KI-Assistenten für ihre Dokumente wünschen (gemessen bis zu 10 gleichzeitige Nutzer).
- Ein CUDA-Entwickler die den vollständigen NVIDIA-Stack auf ihrem Schreibtisch haben möchte.
- Lokales Fine-Tuning : LoRA eines Qwen3-8B, QLoRA eines 70B und von gpt-oss 120B mit Unsloth.
- Die großen MoE-Modelle von mehr als 100 Milliarden Parametern bei komfortabler Geschwindigkeit.
Fazit
Häufige Fragen
Kann der GIGABYTE AI TOP ATOM ein 70B-LLM lokal ausführen?
Qwen3-235B-A22 in 3 Bit (90,5 GB belegt, 21 GB Spielraum) · Llama 3.3 70B mit etwa 5 Tokens pro Sekunde, 2,6- bis 4-mal schneller mit einem kleinen Entwurfsmodell · gpt-oss 120B mit 58 Tokens pro Sekunde; unsere 13 Modelle, vom 4B- bis zum 235B-Modell, passen mit einem Kontext von 32 768 Tokens hinein.
Wie viel kostet der GIGABYTE AI TOP ATOM?
Rechnen Sie mit 6 346,27 € (ATAGB10-9001, 4 TB PCIe 4.0, offizieller AORUS-Shop, ausverkauft; bei Amazon.fr auf Lager) · 7 999,95 € (ATAGB10-9000, 4 TB PCIe 5.0, LDLC und Materiel.net, nicht auf Lager) — Stand vom 08.10.2026 (64-GB-Version von NVIDIA ab 4 999 $ (Vereinigte Staaten) angekündigt, ab dem 23.10.2026 verfügbar; GIGABYTE hat am 05.10.2026 eine AI TOP ATOM mit 64 GB bestätigt). Die Preise ändern sich schnell — überprüfen Sie den Tagespreis über die Kauflinks.
Für wen ist der GIGABYTE AI TOP ATOM gedacht?
CUDA-Entwickler, Teams, die einen privaten KI-Assistenten wünschen, lokales Fine-Tuning, große MoE-Modelle mit mehr als 100B.