GB10 128 GB: Welche LLMs laufen wirklich? (mesures)
Auf einem GIGABYTE AI TOP ATOM (NVIDIA GB10, 128 GB) laufen die 13 gemessenen Modelle vom 4B bis zum 235B mit 32 768 Kontext-Tokens und mindestens 20 GB Spielraum. Die großen MoE-Modelle, die bei jedem Token nur einen Teil ihrer Parameter aktivieren, sind deutlich schneller als ein gleich großes dichtes Modell: gpt-oss 120B schreibt 58 Tokens pro Sekunde. Ein dichtes 70B-Modell schreibt mit 4,8 Tokens pro Sekunde: Die Speicherdatenrate und nicht der Platz bestimmt die Geschwindigkeit.
Einhundertachtundzwanzig Gigabyte Unified Memory: Das ist der Vorteil der GB10-Rechner gegenüber Grafikkarten. Aber was lässt sich tatsächlich darauf laden, mit welchem Spielraum und mit welcher Geschwindigkeit? Wir haben 13 Modelle vom 4B bis zum 235B auf einem uns freundlicherweise von GIGABYTE bereitgestellten AI TOP ATOM mit einem vor der ersten Messung festgelegten Testprotokoll gemessen. Hier erfahren Sie, was passt, was sich im Alltag angenehm nutzen lässt und für wen der Kauf sinnvoll ist.
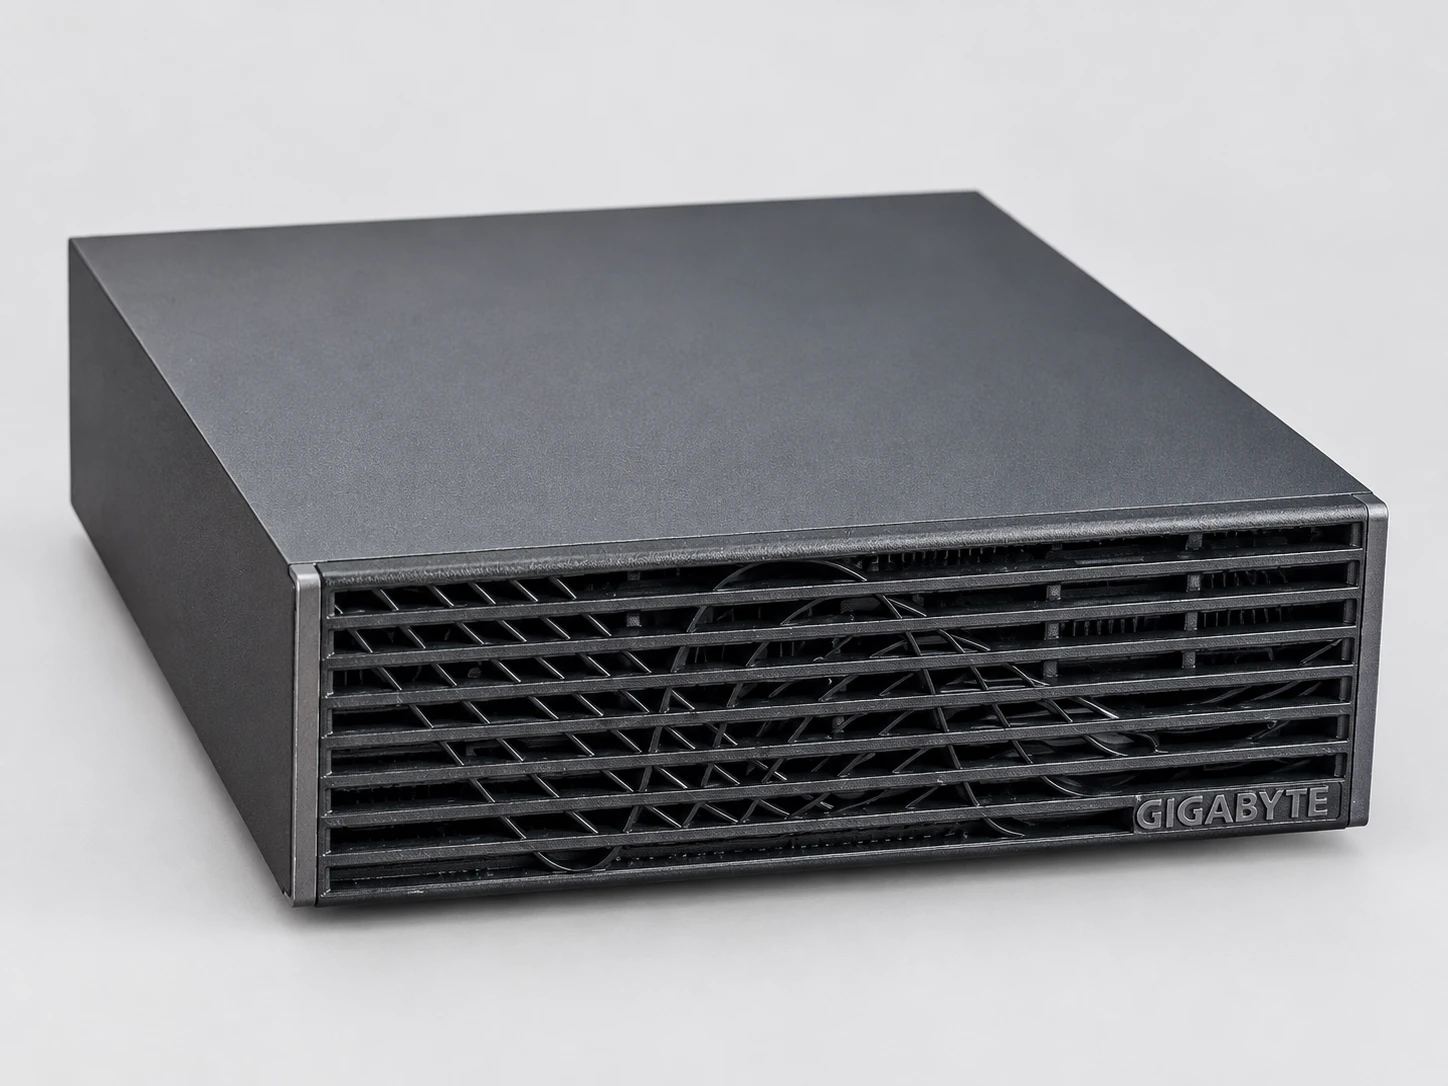
#Die getestete Maschine
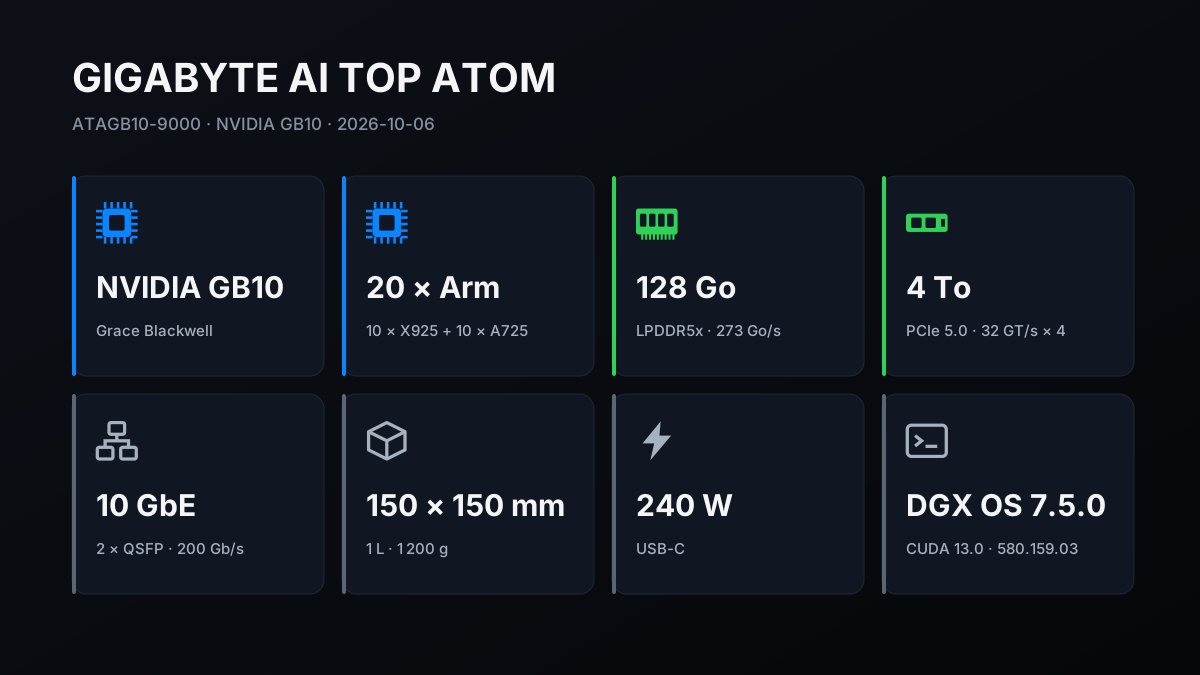
Bei dem Rechner handelt es sich um einen GIGABYTE AI TOP ATOM, Referenz ATAGB10-9000: NVIDIA-GB10-Chip (20 Arm-Kerne und eine Blackwell-GPU, die sich 128 GB Speicher mit angekündigten 273 GB/s teilt), 4-TB-SSD über PCIe 5.0. Er läuft mit DGX OS 7.5.0, dem auf Ubuntu basierenden System von NVIDIA (Treiber 580.159.03, CUDA 13.0).
Drei Softwareprogramme kamen zum Einsatz. llama.cpp, eine weit verbreitete Open-Source-Engine zum lokalen Ausführen von Modellen, die vor Ort für den GB10-Chip kompiliert wurde, liefert die Haupttabelle. Ollama 0.34.1 dient zum Vergleich mit einem MacBook Pro M5 Max, das mit derselben Version gemessen wurde. vLLM 26.09, ein Server, der für die gleichzeitige Beantwortung mehrerer Personen ausgelegt ist, läuft im von NVIDIA bereitgestellten Container.
#Wie wir gemessen haben
Die Geschwindigkeiten von llama.cpp stammen aus fünf Wiederholungen mit einer Standardabweichung (der Streuung zwischen den Wiederholungen) von höchstens 3 %. Die Ladezeiten, das Lesen eines Dokuments mit 30 000 Tokens und die Speicherspielräume sind Einzelmessungen; die Tests mit mehreren Nutzern werden dreimal wiederholt. Vor der ersten Messung wurde in einem dreiminütigen Test überprüft, ob die GPU ihre Rechenleistung halten konnte.
Die Dateien der 13 Modelle haben einen SHA-256-Fingerabdruck (eine digitale Signatur der Datei), der mit dem von Hugging Face, der Website, auf der diese Modelle gehostet werden, veröffentlichten Fingerabdruck identisch ist. Das am 5. Oktober verfasste Protokoll wurde am 6. um 13:30 Uhr, vor der ersten Messung, eingefroren.
Ein Nachtrag vom selben Tag gegen 16:50 Uhr zog die erneute Kaltmessung auf den Abend vor und ergänzte die hier aufgegriffenen Tests: offizielles Skript von Ollama, spekulatives Decoding, Dauerlast und Llama 3.3 70B in NVFP4. Die Methode, die Dateifingerabdrücke und die Daten unserer Tabellen sind auf unserer Methodenseite veröffentlicht.
Die wichtigsten Werte wurden am selben Abend nach 20 Minuten Ruhezeit und geleertem Cache unter identischen Bedingungen erneut gemessen: höchstens 2,6 % Abweichung, unter dem Protokollgrenzwert von 3 %.
#Fast dieselbe Geschwindigkeit wie ein DGX Spark
Soweit wir wissen, teilen sich die GB10-Maschinen mit 128 GB denselben NVIDIA-Chip und denselben Speicher; ihr Aufbau, ihre Kühlung und ihr Speicher können sich unterscheiden. Um den ATOM einzuordnen, haben wir zwei veröffentlichte Referenzwerte für den DGX Spark von NVIDIA mit derselben Softwareversion und denselben Einstellungen erneut ermittelt.
Mit llama.cpp (Build 7941, dem des vom Projekt veröffentlichten Tabellenblatts; unsere Haupttabelle verwendet den neueren Build 11430) ist die Lesegeschwindigkeit bei sechs gemeinsamen Modellen auf 2,3 % genau gleich; die Schreibgeschwindigkeit liegt im Median um 2,8 % und höchstens um 4,3 % darunter. Mit dem offiziellen Skript von Ollama (Version 0.12.6, der Version seiner veröffentlichten Messungen) liegen unsere drei Messungen beim Lesen wie beim Schreiben innerhalb von 2 %: gpt-oss 20B, gpt-oss 120B und Llama 3.1 70B.
Die Geschwindigkeiten aus diesem Leitfaden sollten daher, bis auf wenige Prozent, auch für die anderen GB10-Rechner mit 128 GB gelten; wir haben nur den ATOM gemessen. Sein Aufbau und sein Verhalten unter Last (Temperaturen, Stabilität nach 1 h und 2 h) werden im nächsten Leitfaden der Reihe ausführlich behandelt, sein Stromverbrauch in einem eigenen Leitfaden.
#13 Modelle, von 4B bis 235B: belegter Platz und Geschwindigkeit
Die Tabelle fasst die Testkampagne zusammen. „Belegter Speicher“ ist der Rückgang des verfügbaren Speichers, sobald das Modell mit reserviertem Kontext von 32.768 Tokens geladen ist. „Laden“ ist die Ladezeit bei kaltem Start und geleertem Festplatten-Cache. Die Geschwindigkeiten stammen aus dem Messwerkzeug llama-bench (llama.cpp, Build 11430 vom 5. Oktober 2026), zunächst bei leerem Kontext und anschließend mit bereits vorhandenen 32.768 Tokens; die tatsächlichen Zeiten für ein langes Dokument stehen weiter unten.
| Modell | Typ | Belegter Speicher | Chargement | Schreiben (leer → 32k) | Lesen (leer → 32k) | Nutzung |
|---|---|---|---|---|---|---|
| Gemma 3 4B (Q4_0) | dense | 4,6 GB | 3 s | 80,8 → 63,6 | 6 239 → 5 409 | sehr flüssig |
| Qwen2.5-Coder 7B (Q8_0) | dense | 10,2 GB | 3 s | 30,0 → 23,3 | 3 746 → 2 138 | fluide |
| gpt-oss 20B (MXFP4) | MoE, 3,6 Mrd. aktive | 13,0 GB | 4 s | 81,4 → 62,5 | 4 950 → 3 316 | sehr flüssig |
| Qwen3.8 27B (Q4_K_XL) | dense | 19,1 GB | 5 s | 11,8 → 10,6 | 865 → 717 | correct |
| Qwen3.6 35B-A3B (Q4_K_XL) | MoE, 3 Md aktiv | 22,4 GB | 5 s | 66,0 → 55,6 | 2 987 → 2 429 | sehr flüssig |
| GLM-4.7-Flash (Q8_0) | MoE, 3 Md aktiv | 32,6 GB | 6 s | 51,4 → 35,5 | 2 392 → 608 | sehr flüssig |
| Qwen3-Coder 30B-A3B (Q8_0) | MoE, 3,3 Mrd. aktive | 34,3 GB | 6 s | 62,6 → 33,2 | 3 377 → 1 603 | sehr flüssig |
| Llama 3.3 70B (Q4_K_M) | dense | 51,1 GB | 8 s | 4,8 → 3,9 | 405 → 269 | ideal für die Stapelverarbeitung |
| gpt-oss 120B (MXFP4) | MoE, 5,1 Mrd. aktive | 61,7 GB | 10 s | 58,0 → 42,2 | 2 609 → 1 832 | sehr flüssig |
| Qwen3.5 122B-A10B (Q4_K_XL) | MoE, 10 Mrd. aktive | 74,5 GB | 12 s | 23,1 → 21,4 | 1 126 → 945 | fluide |
| Nemotron-3 Super 120B-A12B (Q4_K_XL) | MoE, 12 Mrd. aktive | 80,4 GB | 12 s | 16,9 → 16,5 | 851 → 809 | correct |
| Qwen3.8-Flash-Next 125B (IQ4_XS) | MoE, etwa 6 Mrd. aktive | 89,5 GB | 21 s | 27,3 → 25,2 | 1 073 → 917 | fluide |
| Qwen3-235B-A22B (Q2_K_XL) | MoE, 22 Mrd. aktive | 90,5 GB | 12 s | 17,7 → 11,8 | 588 → 331 | korrekt; starke Kompression (Q2) |
So lesen Sie die Tabelle: Ein dichtes Modell verarbeitet bei jedem Token alle seine Parameter, ein MoE-Modell („mixture of experts“) dagegen nur einen Bruchteil, angegeben in Milliarden (Mrd.). Das Kürzel in Klammern bezeichnet die Komprimierung der Gewichte. In unseren Dateien belegt Q8 8,5 Bit pro Parameter, die Formate Q4 und MXFP4 4,3 bis 5,6 Bit und Q2_K_XL 3 Bit: Das ist die stärkste Komprimierung der Tabelle.
Die Spalte „Nutzung“ wendet unsere Richtwerte auf die Schreibgeschwindigkeit bei leerem Kontext an: oberhalb von 40 Tokens pro Sekunde sehr flüssig, von 20 bis 40 flüssig, von 10 bis 20 akzeptabel. Darunter reservieren wir das Modell für Stapelverarbeitungen.
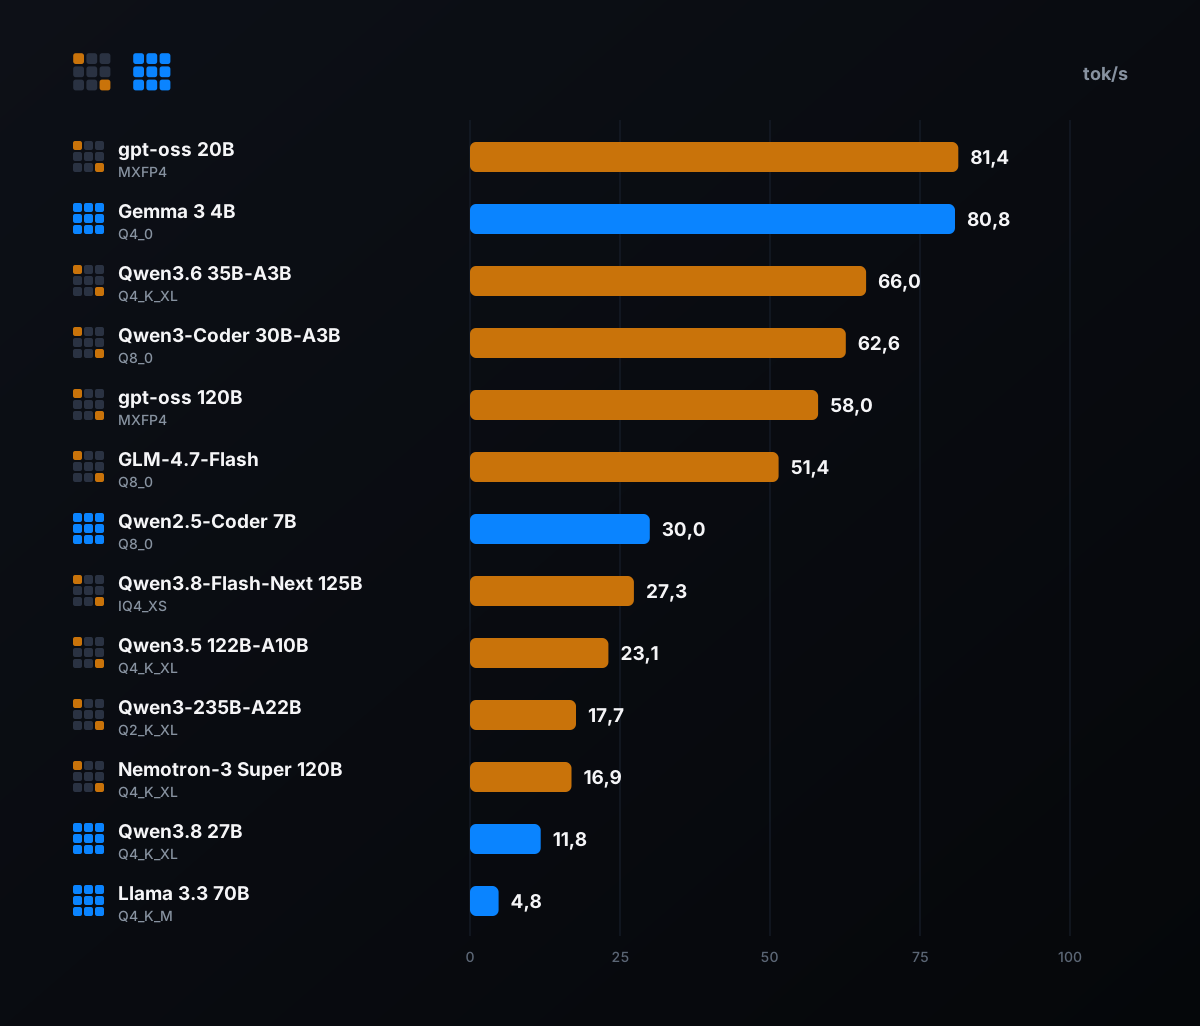
Erste Erkenntnis: Nichts in dieser Tabelle bringt die Maschine in Schwierigkeiten; selbst Qwen3-235B lässt bei 30 000 Kontexttokens 21 GB frei. Zweite, für die Auswahl nützlichere Erkenntnis: Der Speicherplatz ist fast nie der begrenzende Faktor; die Modellwahl bestimmt die Geschwindigkeit – von 4,8 bis 81,4 Tokens pro Sekunde.
#Was die Geschwindigkeit bestimmt: die aktiven Parameter, nicht die Größe
Um jeden Token zu schreiben, muss der Chip die für diesen Token verwendeten Gewichte erneut aus dem Speicher lesen. Bei einer Bandbreite von 273 GB/s lässt sich die maximale Geschwindigkeit einfach berechnen: 273 geteilt durch das Gewichtvolumen, das für jeden Token gelesen wird. Ein dichtes Modell liest jedes Mal alle seine Gewichte; ein MoE-Modell liest nur einen Teil davon, nämlich die für diesen Token ausgewählten „Experten“.
Das erklärt das Paradoxon in der Tabelle. Die Datei von gpt-oss 120B ist 59 GB groß, aber das Modell aktiviert pro Token nur 5,1 Milliarden Parameter: Es schreibt mit 58,0 Tokens pro Sekunde. Qwen3.8 27B, dessen Datei mit 16 GB mehr als dreimal kleiner ist, ist ein dichtes Modell: Es aktiviert bei jedem Token seine 27 Milliarden Parameter und schreibt mit 11,8 Tokens pro Sekunde. Das große Modell ist fast fünfmal schneller als das kleine.
| Modell | Aktive Parameter | Theoretisches Maximum | Gemessen | Anteil des Grenzwerts |
|---|---|---|---|---|
| Qwen2.5-Coder 7B (dicht) | 7,6 Mrd. | 33,7 | 30,0 | 89 % |
| Llama 3.3 70B (dicht) | 70,6 Mrd. | 6,4 | 4,8 | 74 % |
| Qwen3.8 27B (dicht) | 27,3 Mrd. | 15,6 | 11,8 | 76 % |
| Qwen3-Coder 30B-A3B (MoE) | 3,3 Mrd. | 77,8 | 62,6 | 81 % |
| gpt-oss 120B (MoE) | 5,1 Mrd. | 98,7 | 58,0 | 59 % |
| Qwen3.6 35B-A3B (MoE) | 3 Mrd. | 141,1 | 66,0 | 47 % |
Die Tabelle berücksichtigt sechs Modelle, bei denen die Anzahl der aktiven Parameter veröffentlicht oder von llama.cpp ermittelt wurde. Dichte Modelle erreichen 74 bis 89 % dieses Höchstwerts: Die GB10 nutzt fast ihren gesamten Speicher.
Bei allen dreizehn Modellen erreichen die acht MoE-Modelle außerhalb von Qwen3.8-Flash-Next 47 bis 81 %, sechs davon zwischen 52 und 62 %; die Auswahl der Experten und zusätzliche Berechnungen verursachen wahrscheinlich bei jedem Token einen festen Zeitaufwand. Qwen3.8-Flash-Next ist in dieser Berechnung nicht enthalten: Zusätzlich zu seinen 125 Milliarden Parametern verfügt es über 51 Milliarden Parameter für Lookup-Tabellen, wodurch die Schätzung ungeeignet wird.
Bei vergleichbarer Größe bleiben MoE jedoch deutlich schneller. Daher unser wichtigster Rat: Bevorzugen Sie auf einer GB10-Maschine für ein großes Modell ein MoE. Ein kleines dichtes Modell wie Gemma 3 4B schreibt ebenfalls sehr schnell (80,8 Tokens pro Sekunde), ist aber deutlich kleiner und für andere Anwendungsfälle gedacht.
#Modelle mit mehr als 100 Milliarden Parametern
Das ist der Grund für die 128 GB. NVIDIA gibt für die Plattform Modelle mit bis zu 200 Milliarden Parametern an; unsere Messungen bestätigen dieses Versprechen, und ein auf 3 Bit komprimiertes 235B-Modell passt sogar darüber hinaus. Fünf Modelle mit mehr als 100 Milliarden Parametern passen auf den ATOM, alle mit mindestens 20 GB Spielraum bei einem Kontext von 30 000 Tokens.
- gpt-oss 120B, der beste Kompromiss zwischen Geschwindigkeit und Platz
- 58,0 Tokens pro Sekunde, 61,7 GB belegt mit seinem Kontext, in 10 Sekunden geladen. OpenAI veröffentlicht es direkt im MXFP4-Format: Es passt ohne zusätzliche Komprimierung.
- Qwen3.8-Flash-Next 125B, das schnellste der riesigen Qwen
- 27,3 Tokens pro Sekunde mit etwa 6 Milliarden aktiven Parametern, 89,5 GB belegt in IQ4_XS. Auch die weniger stark komprimierte Version Q4_K_XL passt hinein, allerdings mit knappem Spielraum (siehe weiter unten).
- Qwen3.5 122B-A10B
- 23,1 Tokens pro Sekunde, 74,5 GB; seine zehn Milliarden aktiven Parameter setzen es hinter gpt-oss.
- Nemotron-3 Super 120B-A12B (NVIDIA)
- 16,9 Tokens pro Sekunde, 80,4 GB. Mit zwölf Milliarden aktiven Parametern schreibt es langsamer als gpt-oss; zugleich ist es das Modell, dessen Schreibgeschwindigkeit bei längerem Kontext am stabilsten bleibt: 16,5 statt 32 768 Tokens, etwa 3 % weniger.
- Qwen3-235B-A22B, separat
- Es passt in Q2_K_XL, die stärkste Komprimierung der Tabelle (durchschnittlich 3 Bits pro Parameter): 17,7 Tokens pro Sekunde, 90,5 GB. Eine derart starke Komprimierung verringert im Allgemeinen die Qualität der Antworten; wir haben sie nicht gemessen.
#Wo der Speicher endet: bei etwa 100 bis 105 GB Modellgewicht
Das System erkennt 121,7 GB Speicher: Ein Teil der 128 GB ist bereits beim Start reserviert. Sobald die Maschine gestartet war und sich sonst nichts im Speicher befand, waren je nach Zeitpunkt 108 bis 113 GB verfügbar. Um die Obergrenze zu ermitteln, haben wir zwei schwerere Versionen der größten Modelle geladen, mit demselben Kontext von 32 768 Token und einer Schutzvorrichtung, die den Ladevorgang abbricht, wenn der freie Speicher unter 3 GB fällt.
| Modell | Datei | Belegter Speicher | Verbleibende Kapazität | Schreiben (nach dem Lesen von 4 000 → 30 000 Tokens) | Place |
|---|---|---|---|---|---|
| Qwen3.8-Flash-Next 125B (Q4_K_XL) | 103,7 GB | 107,0 GB | 6,0 GB | 24,9 → 21,9 Tok/s | genau |
| Qwen3-235B-A22B (Q3_K_XL, 3,5 Bit) | 97,0 GB | 104,7 GB | 8,2 GB | 13,9 → 10,4 Tok/s | genau |
Keines der Modelle ist beim Laden fehlgeschlagen, aber diese beiden lassen nur wenig Spielraum: kaum Platz für ein zweites Modell, einen deutlich längeren Kontext oder eine anspruchsvolle Anwendung daneben. Die praktische Grenze liegt daher bei etwa 100 bis 105 GB Modellgewicht. Ausgeschlossen sind beispielsweise die NVFP4-Gewichte (ein komprimiertes Format von NVIDIA) von Qwen3.8-Flash-Next: laut dem Kubesimplify-Blog (27. August 2026) etwa 135 GB; dort wird darauf hingewiesen, dass dafür zwei Rechner erforderlich sind.
Dieser Beitrag zeigte das Modell bereits auf einer einzigen Maschine im GGUF-Format (dem Format von llama.cpp), damals existierte jedoch nur die am stärksten komprimierte Version. Auf dem ATOM laufen die Versionen IQ4_XS und Q4_K_XL mit 21 bzw. 6 GB Spielraum.
#Der Preis des langen Kontexts
Ein langes Dokument, eine Codebasis oder eine sich hinziehende Unterhaltung: Jeder Token, der bereits im Kontext vorhanden ist, verlangsamt den weiteren Verlauf. Bei 32 768 Tokens im Speicher sinkt die Schreibgeschwindigkeit je nach Modell um 3 bis 47 %. Wir haben außerdem die tatsächliche Zeit gemessen, die benötigt wird, um ein Dokument mit 30 000 Tokens, etwa fünfzig Seiten, am Stück zu lesen.
| Modell | Lesen von 30 000 Tokens | Danach schreiben |
|---|---|---|
| Gemma 3 4B | 4,7 s | 60,8 Tok/s |
| gpt-oss 20B | 8,1 s | 61,6 Tok/s |
| Qwen2.5-Coder 7B | 12,7 s | 23,3 Tok/s |
| Qwen3.6 35B-A3B | 14,2 s | 54,4 Tok/s |
| Qwen3-Coder 30B-A3B | 17,4 s | 33,3 Token/s |
| gpt-oss 120B | 21,8 s | 42,8 Tok/s |
| GLM-4.7-Flash | 32,7 s | 35,6 Tok/s |
| Qwen3.8 27B | 39,4 s | 10,6 Tok/s |
| Qwen3.8-Flash-Next 125B | 42,9 s | 23,0 Tok/s |
| Qwen3.5 122B-A10B | 43,6 s | 21,2 Tok/s |
| Nemotron-3 Super 120B-A12B | 55,4 s | 16,2 Tok/s |
| Qwen3-235B-A22B | 1 Min. 33 Sek. | 12,1 Tok./s |
| Llama 3.3 70B | 1 Min. 44 Sek. | 4,0 Tok/s |
Bei den meisten Modellen sind diese Zeiten länger, als die Spalte „Lesen“ der ersten Tabelle vermuten lässt. Der wahrscheinliche Grund: llama-server, der praktisch verwendete Server, verarbeitet Text standardmäßig in Stapeln von 512 Tokens statt 2.048 wie in unserer llama-bench-Konfiguration.
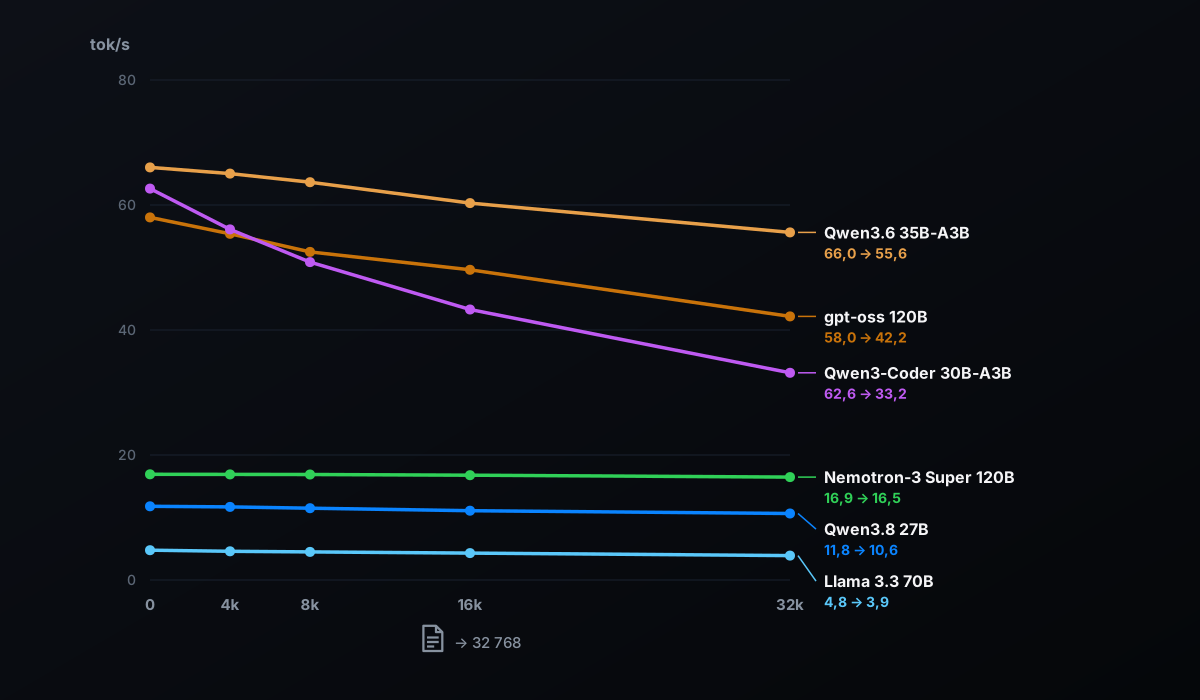
Das Lesen ist eine Stärke der GB10: Im Vergleich zum weiter unten getesteten Mac liest sie gpt-oss 120B 31 % schneller. Wenn Sie einen Bericht mit etwa fünfzig Seiten ablegen, beginnt die Antwort mit gpt-oss 120B 22 Sekunden später und mit einem dichten 70B-Modell 1 min 44 s später. Für die Dokumentenanalyse und Code-Agenten ist dieses Kriterium von großer Bedeutung.
#Bis zu 16 Nutzer gleichzeitig: Was die Maschine bewältigt
Mit vLLM haben wir 1, dann 8 und anschließend 16 gleichzeitige Benutzer simuliert. Jeder sendet eine Anfrage mit 1 024 Tokens und erhält eine Antwort mit 512 Tokens; jeder Punkt wird dreimal mit unterschiedlichen Anfragen gemessen, und wir veröffentlichen den Median.
| Modell | Benutzer | Total | Pro Person | Erstes Wort (Durchschnitt) | Erstes Token (langsamste Fälle) |
|---|---|---|---|---|---|
| gpt-oss 120B | 1 | 35,6 Tok/s | 36,4 Tok/s | 0,34 s | 0,35 s |
| gpt-oss 120B | 8 | 113,9 Tok/s | 14,5 Tok/s | 0,97 s | 1,62 s |
| gpt-oss 120B | 16 | 160,3 Tok/s | 10,2 Tok/s | 1,07 s | 3,71 s |
| gpt-oss 20B | 1 | 49,1 Tok/s | 50,0 Tok/s | 0,16 s | 0,16 s |
| gpt-oss 20B | 8 | 205,9 Tok/s | 26,5 Tok/s | 0,49 s | 0,81 s |
| gpt-oss 20B | 16 | 322,4 Tok/s | 20,7 Tok/s | 0,52 s | 1,73 s |
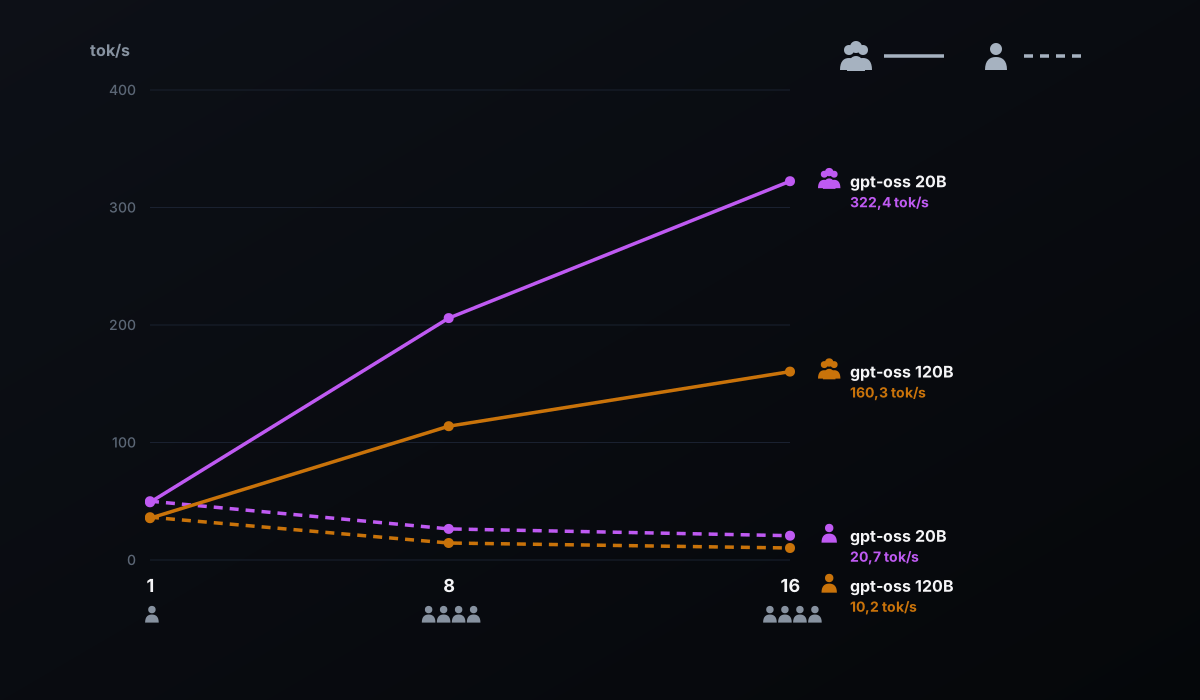
Bei 1 bis 16 Nutzern wird der Gesamtdurchsatz mit gpt-oss 120B um das 4,5-Fache und mit gpt-oss 20B um das 6,6-Fache erhöht: Wenn mehrere Anfragen dieselben Gewichtungen gemeinsam nutzen, schöpft der Chip seine Rechenleistung voll aus.
Bei 16 Personen sieht jede einzelne ihre Antwort mit gpt-oss 120B weiterhin mit 10 Tokens pro Sekunde entstehen, mit gpt-oss 20B mit 21. Beim Modell mit 120 Milliarden Parametern kommt das erste Wort im Durchschnitt nach etwas mehr als einer Sekunde, in den langsamsten Fällen nach fast 4 Sekunden.
Für eine einzelne Person ist vLLM dagegen nicht am schnellsten: Ohne besondere Leistungsoptimierung schreibt es mit 36,4 Tokens pro Sekunde auf gpt-oss 120B, gegenüber 54,4 für llama.cpp bei langen Antworten. Die Protokolle zeigen, dass es auf der GB10 den Marlin-Rechenkern für das MXFP4-Format auswählt, was den Unterschied wahrscheinlich erklärt. vLLM lohnt sich, sobald mehrere Personen oder mehrere Agenten die Maschine gemeinsam nutzen.
#Allein vor dem Rechner: Ollama oder llama.cpp?
Ollama ist der einfachste Einstieg und funktioniert ohne Anpassungen auf der GB10. Auf gpt-oss ist es jedoch nicht das schnellste. Bei langen Antworten schreibt Version 0.34.1 mit 42,3 Tokens pro Sekunde auf gpt-oss 120B, gegenüber 54,4 für llama.cpp im selben MXFP4-Format, also 22 % weniger. Auf gpt-oss 20B: 58,8 gegenüber 78,8, also 25 % weniger.
Bei den Qwen-Modellen ist es umgekehrt. Auf Qwen3.8 27B schreibt Ollama je nach Abschnitt zwischen 22,9 und 30,5 Tokens pro Sekunde, gegenüber 11,8 bei llama.cpp mit Standardeinstellungen; auf Qwen3.6 35B-A3B zwischen 90,5 und 94,9, gegenüber 66,0. Der wahrscheinliche Grund: Ollama aktiviert dort standardmäßig eine spekulative Dekodierung, bei der mehrere Tokens im Voraus vorgeschlagen werden, die das Modell auf einmal bestätigt (die Einstellung draft_num_predict erscheint in der Konfiguration dieser Modelle).
Unser Test bestätigt dies. Auf llama-server (sechs Texte mit 400 Tokens, Prosa und Code) steigert das spekulative Decoding von llama.cpp (MTP, das mehrere Tokens gleichzeitig vorhersagt) Qwen3.8 27B bei Prosa von 11,7 auf 21,5 Tokens pro Sekunde und bei Code von 11,6 auf 27,2.
In der Praxis: Ollama zum Starten und für die Modelle Qwen, die es standardmäßig beschleunigt; llama.cpp, um das Maximum aus gpt-oss herauszuholen oder bei aktiviertem spekulativem Dekodieren aus Qwen3.8. Die beste Wahl hängt stärker von den Einstellungen als von der Maschine ab.
#Im Vergleich zum MacBook Pro M5 Max 128 GB
Ein Leser hat sein MacBook Pro M5 Max mit 128 GB (GPU mit 40 Kernen) am 16. September mit Ollama 0.34.1 in einem einzigen Durchlauf pro Modell vermessen; seine Messwerte sind in unserem speziellen Leitfaden veröffentlicht. Wir haben dieselben Serien auf dem ATOM in zwei Durchläufen erneut ausgeführt: dieselbe Version von Ollama, dieselben Modelle, derselbe Prompt.
| Messung | ATOM, 1. Durchlauf | ATOM, 2. Durchlauf | MacBook Pro M5 Max | Abweichung |
|---|---|---|---|---|
| Schreiben, gemma4:12b | 45,9 | 54,1 | 58,1 | Mac +7 bis +27 % |
| Schreiben, qwen3.8:27b | 30,5 | 22,9 | 36,6 | Mac +20 bis +59 % |
| Schreiben, gpt-oss:20b | 58,1 | 58,8 | 113,4 | Mac +93 bis +95 % |
| Schreiben, gpt-oss:120b | 42,2 | 42,3 | 79,1 | Mac +87 % |
| Lektüre, gpt-oss:120b | 1 816 | — | 1 388 | ATOM +31 % |
Der Mac schreibt bei allen vier Modellen schneller, bei den beiden gpt-oss-Modellen fast doppelt so schnell, deren Durchläufe übereinstimmen: Sein Chip verfügt über eine Bandbreite von 614 GB/s, mehr als das Doppelte der GB10. Bei gemma4 und qwen3.8 variiert der Abstand von einem Durchlauf zum nächsten; spekulatives Dekodieren, dessen Gewinn vom generierten Text abhängt, ist eine mögliche Erklärung.
Die ATOM liest wahrscheinlich dank der Rechenleistung ihrer GPU schneller, und zwar bei ähnlichen, aber nicht identischen Texten (16 850 und 16 689 Tokens). Mit llama.cpp verringert sich der Abstand bei der Ausgabe: 54,4 Tokens pro Sekunde auf gpt-oss 120B gegenüber 79,1 beim Mac unter Ollama.
#Für wen der ATOM die richtige Wahl ist
Das Folgende stammt aus unseren Messungen auf dem ATOM.
- ATOM ist die richtige Wahl, wenn Sie große Modelle zu Hause ausführen möchten
- Fünf Modelle mit mehr als 100 Milliarden Parametern finden mit Reserve Platz. Nach unserem Kenntnisstand kommt keine Grafikkarte für den Massenmarkt diesen 128 GB nahe.
- … wenn Sie an langen Dokumenten oder Code arbeiten
- 30 000 gelesene Tokens in 22 Sekunden mit gpt-oss 120B.
- … wenn mehrere Personen oder Agenten sie gemeinsam nutzen
- Insgesamt 160 Tokens pro Sekunde für 16 Benutzer auf gpt-oss 120B.
- … wenn Sie das NVIDIA-Ökosystem möchten
- CUDA 13, vLLM im Container von NVIDIA und für den GB10-Chip kompiliertes llama.cpp haben bei uns unter DGX OS 7.5.0 funktioniert.
- Wenn Sie allein arbeiten und zunächst auf Schreibgeschwindigkeit abzielen
- Vergleichen Sie mit dem MacBook Pro M5 Max: Dank seiner 614 GB/s schreibt es schneller auf gpt-oss, während der ATOM ein langes Dokument auf gpt-oss 120B 31 % schneller liest. Vergleichen Sie auch die Preise.
- Wenn Ihre Modelle unter 35 GB bleiben
- Die für den 23. Oktober 2026 angekündigte 64-GB-Version der ATOM sollte ausreichen (Berechnung aus unseren Messungen, auf dieser Version nicht gemessen).
#64 oder 128 GB?
Am 2. Oktober 2026 kündigte NVIDIA DGX-Spark-Geräte mit 64 GB für Modelle mit bis zu 100 Milliarden Parametern an, die ab dem 23. Oktober bei Acer, ASUS, Dell, GIGABYTE, HP und MSI ab 4.999 Dollar erhältlich sein sollten. GIGABYTE bestätigte am 5. Oktober eine AI TOP ATOM 64 GB im selben Design. Wir haben sie nicht gemessen.
Unsere Messwerte ermöglichen eine Berechnung. Modelle bis Qwen3-Coder 30B-A3B belegen mit 32 768 Kontext-Token weniger als 35 GB und würden passen; Llama 3.3 70B (51 GB) läge an der Grenze. gpt-oss 120B (62 GB) und größere Modelle würden nicht passen. Bei gleicher Bandbreite – was noch überprüft werden muss – sollten die Geschwindigkeiten ähnlich sein.
Für ein Modell mit mehr als 100 Milliarden Parametern auf einer einzigen Maschine ist die 128-GB-Version die richtige Wahl. Laut NVIDIA teilen sich auch zwei miteinander verbundene Maschinen mit jeweils 64 GB ihren Speicher; wir haben das nicht getestet.
#Die erhobenen Preise
Am 8. Oktober 2026 wurde die 4-TB-Version mit PCIe 4.0 (ATAGB10-9001, derselbe GB10-Chip und dieselben 128 GB) im offiziellen AORUS-Shop für 6 346,27 € inklusive Mehrwertsteuer angezeigt, war jedoch ausverkauft; auf Amazon.fr war sie auf Lager und wurde von Amazon UK verkauft (ein Exemplar). Die getestete Version, 4 TB mit PCIe 5.0 (ATAGB10-9000), kostete bei LDLC und Materiel.net 7 999,95 € und war nicht verfügbar.
Preise und Lagerbestände dieser Geräte ändern sich schnell: Überprüfen Sie sie vor dem Kauf.
#Unser Urteil
Der ATOM ist eine ausgezeichnete Wahl, um zu Hause ein Modell mit 120 Milliarden Parametern zu betreiben, es mit einem Team zu teilen oder lange Dokumente schnell zu lesen. Er lieferte uns die Referenzleistung der Plattform, ohne dass unsere Messungen eine thermische Begrenzung zeigten, auch nicht während einer Stunde Dauerlast mit 16 Benutzern. Wenn das Budget eine Rolle spielt, behält die PCIe-4.0-Version denselben Chip und denselben Speicher.
#Was wir nicht gemessen haben
- Die Qualität der Antworten
- Dieser Leitfaden misst, was funktioniert und wie schnell, nicht, wie gut jedes Modell ist.
- Temperaturen, Geräuschpegel und Stromverbrauch
- Der nächste Leitfaden der Reihe behandelt die Temperaturen bei längerer Belastung; der Stromverbrauch hat einen eigenen Leitfaden und wird am Chip abgelesen (nur GPU). Beim Geräuschpegel zitieren wir die Messungen von Hardware & Co.
- Kontexte mit mehr als 32.768 Tokens
- Mehrere Modelle akzeptieren deutlich längere Kontexte; dieser Leitfaden endet bei 32 768 Tokens, und das 70B-Tutorial der Reihe reicht für Llama 3.3 70B und gpt-oss 120B bis 131 072 Tokens.
- Die anderen GB10-Maschinen und die 64-GB-Version
- Unsere Zahlen entsprechen den für den DGX Spark von NVIDIA veröffentlichten Werten, aber wir haben nur den ATOM 128 GB gemessen.
Aktualisierungen und Korrekturen: Diese Seite wird überarbeitet, falls eine neue Version von DGX OS, llama.cpp oder Ollama diese Ergebnisse verändert; jede Korrektur wird datiert.
#FAQ
Welches ist das größte Modell, das man auf einem 128-GB-GB10-System ausführen kann?+
Ist ein 70B-Modell im Alltag auf einer GB10 nutzbar?+
Gelten die Geschwindigkeiten dieses Leitfadens für einen DGX Spark von NVIDIA oder eine andere Marke?+
Sollten Sie die Version mit 64 GB oder 128 GB wählen?+
Ist Ollama die beste Wahl auf einer GB10?+
Haben Sie Feedback, einen Fehler entdeckt oder möchten Sie etwas präzisieren? Geben Sie uns Bescheid – so wird der Guide für alle besser.