70B-LLM lokal auf GB10: das Tutorial complet
Auf einem GIGABYTE AI TOP ATOM (Chip NVIDIA GB10, 128 GB) passt Llama 3.3 70B mit Reserve: 43,6 GB bei einem Kontext von 8 192 Tokens, 82 GB bei 131 072. Es schreibt zwischen 4,6 und 5,3 Tokens pro Sekunde, auf drei Wegen: Ollama, llama.cpp oder vLLM. Ein Entwurfsmodell Llama 3.2 1B bringt llama.cpp auf 12 Tokens pro Sekunde bei Prosa und 19 bei Code. Bei acht Nutzern hält vLLM über zwei Stunden durchschnittlich insgesamt 38,6 Tokens pro Sekunde.
Ein Modell mit 70 Milliarden Parametern wie Llama 3.3 70B ist „dicht“ (dense): Es nutzt alle seine Parameter, um jedes Wort zu schreiben, und benötigt viel Speicher. Die 128 GB einer GB10-Maschine bieten dafür reichlich Platz. Dieses Tutorial liefert die Befehle für drei Installationswege, getestet auf einer von GIGABYTE kostenlos zur Verfügung gestellten AI TOP ATOM, und anschließend die Messwerte, die bei der Wahl helfen: Geschwindigkeit, kleines Draft-Modell, Kontextspeicher, Stabilität über zwei Stunden und Betrieb mit mehreren Nutzern.
#Die Maschine, die Methode und die Einheiten
Zunächst etwas Vokabular. Ein Token ist ein Wortteil: Im Französischen entspricht ein Token etwa zwei Dritteln eines Wortes. Der Kontext ist der Text, den das Modell während eines Austauschs im Gedächtnis behält: Ihre Fragen, Ihre Dokumente und seine Antworten. Die Schreibgeschwindigkeit ist das Tempo, in dem die Antwort angezeigt wird, in Tokens pro Sekunde (tok/s). Die Lesegeschwindigkeit ist das Tempo, mit dem die Maschine Ihren Text aufnimmt, bevor sie antwortet.
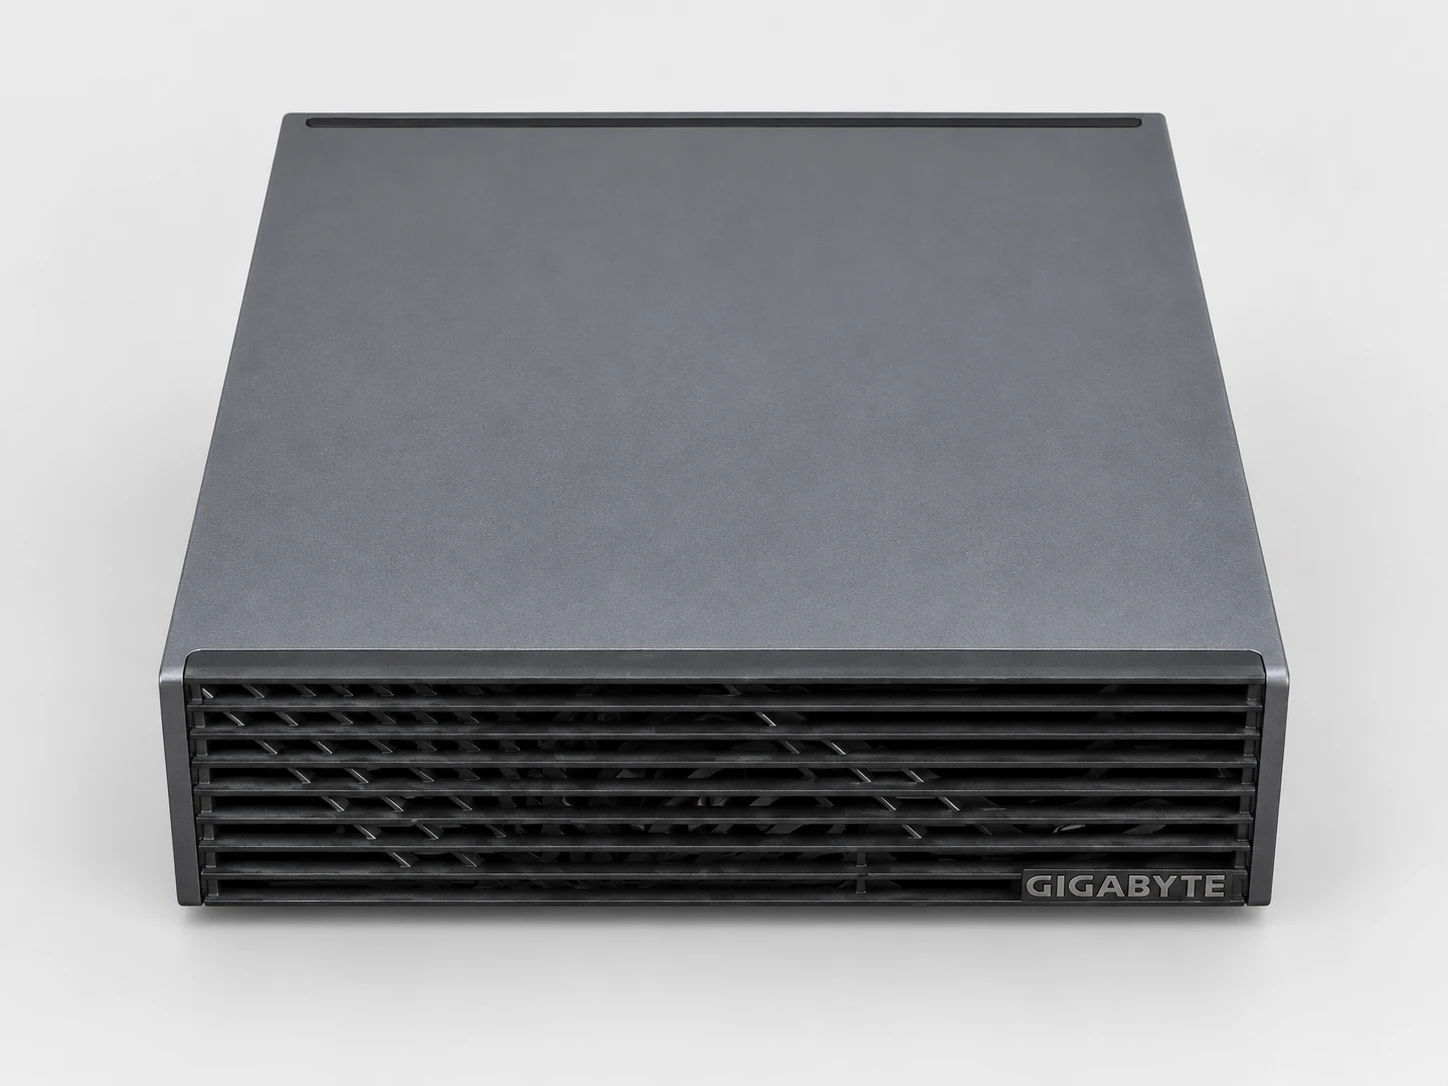
Die Maschine ist ein GIGABYTE AI TOP ATOM, Modellnummer ATAGB10-9000. Sein Chip NVIDIA GB10 vereint 20 Arm-Kerne und eine Blackwell-GPU, die sich 128 GB Speicher mit 273 GB/s teilen. Die SSD fasst 4 TB mit PCIe 5.0. Er läuft unter DGX OS 7.5.0, dem auf Ubuntu basierenden System von NVIDIA (Treiber 580.159.03, CUDA 13.0). Das System erkennt 121,7 GB Speicher.
- Was von der Plattform NVIDIA GB10 stammt
- Der Chip, seine 128 GB mit 273 GB/s und DGX OS bestimmen die Geschwindigkeiten in diesem Leitfaden. Beim Nachstellen zweier veröffentlichter Referenzwerte für den DGX Spark von NVIDIA, mit llama.cpp und mit Ollama, weichen unsere Geschwindigkeiten um höchstens 4,3 % ab. Unseres Wissens sollten sie daher auch für andere GB10-Maschinen mit 128 GB gelten. Die Messwerte in diesem Leitfaden beziehen sich auf den AI TOP ATOM.
- Was von GIGABYTE kommt
- Das Gehäuse mit rund einem Liter Volumen und seine Kühlung, die Verarbeitung, die Ausstattungsvarianten (die 9000 hat eine 4-TB-SSD mit PCIe 5.0) und die Händlergarantie. Während unserer zwei Stunden Dauerbetrieb überschritt die GPU nie 72 °C, und es trat keine Drosselung auf.
Die Messungen stammen vom 6. und 7. Oktober 2026 (der private Assistent mit Open WebUI vom 7. und 8. Oktober). Das Protokoll wurde am 6. Oktober um 13:30 Uhr festgeschrieben, vor der ersten Messung. Datierte Nachträge, die vor den jeweils beschriebenen Tests verfasst wurden, haben das spekulative Decoding und das Speicherbudget ergänzt. Methode und Daten unserer Tabellen sind auf unserer Methodikseite veröffentlicht.
Die Schreibgeschwindigkeiten von llama.cpp und TensorRT-LLM stammen aus sechs Texten mit 400 Tokens: drei französische Fließtexte und drei Code-Anfragen. Die von Ollama (ein Text mit 300 Wörtern) und von vLLM (zufällige Anfragen mit 1.024 Tokens Eingabe und 256 Tokens Ausgabe) folgen den in ihren Abschnitten beschriebenen Protokollen. Die Temperatur ist auf 0 festgelegt: Das Modell wählt stets das wahrscheinlichste Wort, was die Tests vergleichbar macht. Wir veröffentlichen den Median der drei Texte jedes Typs.
Speichergrößen sind in GB angegeben (1 GB = 1.024 MB, wie von Linux angezeigt); die Bandbreiten in GB/s sind die Herstellerangaben in Dezimaleinheiten. Verwendet wurden llama.cpp b11430 (Build vom 5. Oktober 2026), Ollama 0.34.1, vLLM 26.09 und TensorRT-LLM 1.3.0rc12, die beiden letzteren in den Containern von NVIDIA. Unser erster Leitfaden der Reihe liefert die Messwerte von 13 Modellen, darunter Llama 3.3 70B; dieser hier zeigt, wie Sie es installieren und beschleunigen.
#Weg 1: Ollama, der einfachste
Ollama ist der einfachste Einstieg: ein Archiv zum Entpacken, ein Befehl zum Herunterladen des Modells, ein weiterer, um mit ihm zu chatten. Wir haben Version 0.34.1 aus dem offiziellen Archiv für Linux Arm installiert, in einem Ordner und ohne Systemdienst. Wenn Sie den üblichen Installer bevorzugen, finden Sie ihn in unserer Installationsanleitung für Linux beschrieben.
Die Option --verbose lässt am Ende der Antwort die Statistiken anzeigen. Bei uns schreibt Llama 3.3 70B (in Q4_K_M, einer Komprimierung der Gewichte) im ersten Durchlauf mit 4,97 tok/s und im zweiten mit 4,95 tok/s. Der Befehl ollama ps zeigt 85 GB geladen an, in Dezimaleinheiten: Ollama hat von sich aus einen Kontext von 131 072 Tokens geöffnet. Bei einem Text mit 18 823 Tokens dauert das Lesen 55,6 s, also 338,7 tok/s, und das anschließende Schreiben bleibt bei 4,38 tok/s.
Zur Einordnung dieser Zahlen: Ollama veröffentlicht 4,423 tok/s für Llama 3.1 70B Q4_K_M auf einem DGX Spark von NVIDIA (Version 0.12.6, 23. Oktober 2025). Mit derselben Version, demselben Skript und demselben Modell (Llama 3.1 70B) erreicht unser ATOM 4,34 tok/s, also eine Abweichung innerhalb von 2 %. Um den Kontext und den belegten Speicher zu verringern, setzen Sie die Variable OLLAMA_CONTEXT_LENGTH, bevor Sie den Server starten; diese Variante haben wir nicht gemessen.
#Weg 2: llama.cpp, der Weg mit den meisten Einstellungsmöglichkeiten
llama.cpp ist eine sehr verbreitete Open-Source-Engine. Sie liest Modelle im GGUF-Format, einer einzelnen Datei, die die Gewichte enthält. Sie muss einmal für den GB10-Chip kompiliert werden, bietet dafür aber Zugriff auf alle Einstellungen: Kontextgröße, Format des Kontext-Caches, Entwurfsmodell. Die Kompilierung folgt der Anleitung von NVIDIA, mit der CUDA-Architektur 121a-real, der des GB10, jedoch ohne libcurl (-DLLAMA_CURL=OFF) und ohne RPC.
Die gewählte Datei ist Llama 3.3 70B in Q4_K_M, veröffentlicht von bartowski: 39,6 GB. Bei geleertem Festplatten-Cache lädt llama.cpp sie in 8 s von der SSD. Der Befehl hf stammt aus der Bibliothek huggingface_hub (Installation: pip install -U huggingface_hub). Falls Hugging Face Sie auffordert, die Llama-Lizenz zu akzeptieren, akzeptieren Sie sie auf der Website und melden Sie sich dann mit hf auth login an.
- -ngl 99
- Legt alle Schichten des Modells auf die GPU.
- -fa on
- Aktiviert Flash Attention, wodurch das Einlesen des Kontexts sparsamer wird.
- -lm dio
- Liest die Datei per Direktzugriff auf die Festplatte, ohne den Umweg über den System-Cache (mmap). Das ist der Modus der Referenztabelle, die das llama.cpp-Projekt für den DGX Spark veröffentlicht hat.
- -c 16384 -np 1
- Ein Kontext von 16.384 Tokens für einen einzelnen Nutzer. Der angeforderte Kontext wird auf die gleichzeitigen Nutzer aufgeteilt.
- --host 127.0.0.1
- Der Server ist nur vom Rechner selbst aus erreichbar.
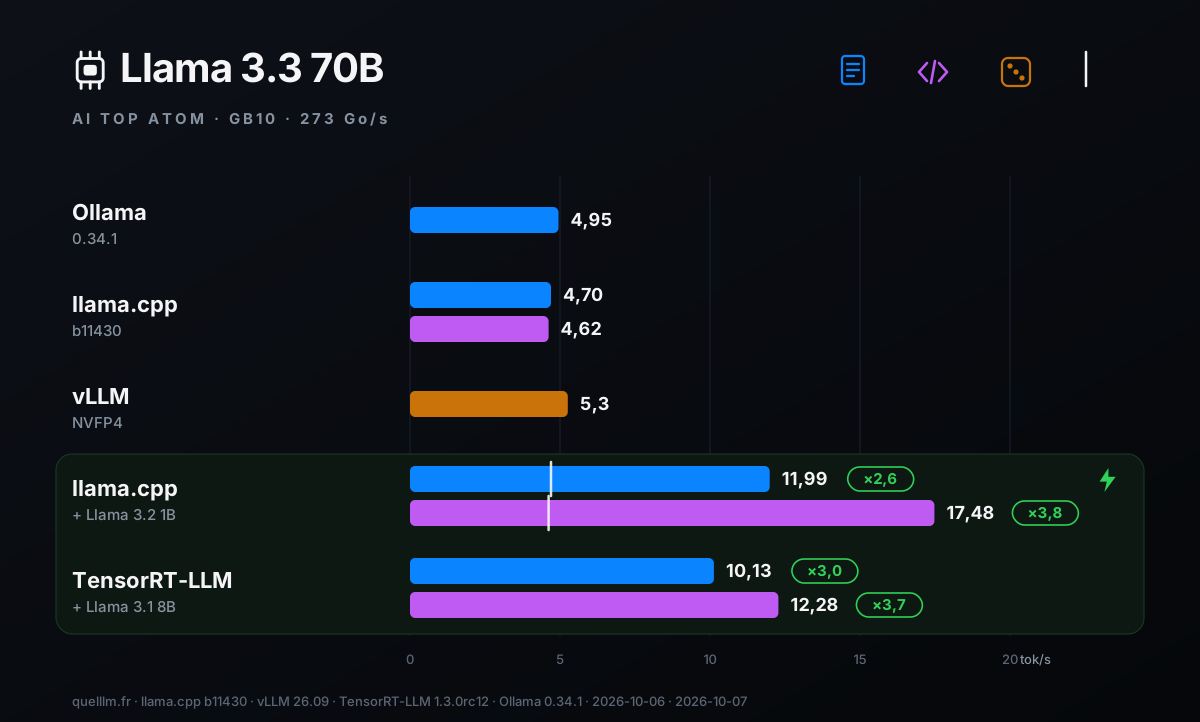
Bei unseren sechs Texten schreibt llama-server mit 4,70 tok/s bei Prosa und 4,62 bei Code. Das Messwerkzeug llama-bench ergibt 4,8 tok/s beim Schreiben (32 Tokens) und 405 tok/s beim Lesen (2 048 Tokens). Das Modell belegt 43,6 GB bei einem Kontext von 8 192 Tokens.
Zur Orientierung: Der Speicher liest höchstens 273 Milliarden Bytes pro Sekunde, und für jedes Token müssen die Modellgewichte erneut gelesen werden, also 42,5 Milliarden Bytes: Das theoretische Maximum liegt bei 6,4 tok/s, die Messung erreicht etwa drei Viertel davon.
#Weg 3: vLLM in NVFP4, für mehrere Nutzer
vLLM ist ein Server, der dafür ausgelegt ist, mehreren Personen gleichzeitig zu antworten. NVIDIA stellt ihn in einem Container bereit, also einem isolierten Programm, das Docker startet. Das Modell ist Llama 3.3 70B in NVFP4, einem 4-Bit-Format von NVIDIA, das Blackwell-Chips direkt berechnen: Es belegt 39,9 GB Speicher. Die Matrix der unterstützten Modelle im vLLM-Leitfaden von NVIDIA für DGX Spark führt dieses Modell auf.
Die Einstellungen --max-model-len 8192 und --max-num-seqs 16 begrenzen den Kontext auf 8 192 Tokens und auf 16 gleichzeitig verarbeitete Anfragen. Die Einstellung --gpu-memory-utilization 0.85 legt den Anteil des Speichers fest, den vLLM reserviert: hier 103 GB, davon 59,6 GB Cache. Dieser Cache hält gleichzeitig 390 352 Tokens, was fast 48 gleichzeitigen Anfragen mit je 8 192 Tokens entspricht. Der erste Start dauert etwa 7 Minuten: 4 min 20 s zum Einlesen des Modells, dann etwa 2 Minuten Vorbereitung.
Für einen Nutzer schreibt vLLM 5,3 tok/s (5,26, 5,27 und 5,26 in drei Durchläufen), und das erste Wort erscheint im Durchschnitt nach 0,73 s. Bei acht gleichzeitigen Nutzern schreibt die Maschine insgesamt 37,7 tok/s, einschließlich der Wartezeit auf das erste Wort; sobald die Antwort begonnen hat, erhält jeder Nutzer 5,0 tok/s.
Das erste Wort erscheint im Durchschnitt nach 2,8 s und in den langsamsten Fällen nach weniger als 4,8 s. Die Anfragen dieses Tests haben 1 024 Tokens Eingabe und 256 Tokens Ausgabe; jeder Messpunkt wird dreimal gemessen.
#Die drei Wege im Vergleich
| Weg | Schreiben | Speicher | Einstellungen | Geeignet für |
|---|---|---|---|---|
| Ollama 0.34.1 (Q4_K_M) | 4,95 | 85 GB laut Anzeige von Ollama (in Dezimaleinheiten, also etwa 79 GB im Sinne dieses Leitfadens) mit dem Kontext von 131.072 Tokens, den es ohne weitere Einstellung bereitstellt | peu | schnell starten |
| llama.cpp b11430 (Q4_K_M) | 4,70 bei Prosa, 4,62 bei Code | 43,6 GB bei 8 192 Tokens, 51,3 GB bei 32 768 | alle: Kontext, Cache, Draft-Modell | ein Nutzer, mit einem Entwurfsmodell |
| vLLM 26.09 (NVFP4) | 5,3; insgesamt 37,7 für 8 Nutzer | 103 GB reserviert mit der Einstellung 0,85 | die eines Servers | mehrere Nutzer |
Die drei Wege schreiben gleich schnell, mit weniger als 15 % Abweichung. Der Grund ist einfach: Für jedes Token liest der Chip die Modellgewichte erneut, und bei einem dichten Modell bestimmt die Bandbreite von 273 GB/s das Tempo. Ein 70B schreibt daher mit etwa 5 tok/s, also etwa 200 Wörter pro Minute – das Tempo eines ruhigen Lesens.
Dieses Tempo eignet sich für Aufgaben, bei denen Warten kein Problem ist: Zusammenfassungen, Extraktionen, Korrekturlesen, Antwortentwürfe. Für ein flüssiges Gespräch gibt es zwei Hebel, die in den folgenden Abschnitten vorgestellt werden: das Draft-Modell und ein MoE-Modell (Mixture of Experts), das pro Token nur einen Teil seiner Parameter nutzt.
#Ein 70B mit einem kleinen Entwurfsmodell beschleunigen
Spekulatives Decoding nutzt ein kleines Modell, das Entwurfsmodell, das mehrere Wörter im Voraus vorschlägt (genauer gesagt Tokens; der Einfachheit halber sprechen wir von „Wörtern“). Das große Modell prüft diese Wörter in einem einzigen Durchgang: Das kostet ungefähr so viel Zeit wie das Schreiben eines einzigen, denn die Zeit entfällt vor allem auf das Lesen der Gewichte.
Die richtigen Wörter werden übernommen, die anderen verworfen. Das Entwurfsmodell bestimmt den Text nicht: Es ist immer das große Modell, das bestätigt. NVIDIA beschreibt das Prinzip in seiner Anleitung für den DGX Spark, und der LMSYS-Blog merkt an, dass diese Technik die Bandbreitenbegrenzung der Maschine teilweise abmildert.
#Mit llama.cpp: ein Entwurfsmodell Llama 3.2 1B
Das Entwurfsmodell muss dieselbe Sprache sprechen wie das große Modell, also dieselbe Tokenisierung verwenden. Die Familie Llama eignet sich: Llama 3.2 1B in Q8_0 begleitet Llama 3.3 70B. Vier Optionen genügen: -md bezeichnet das Entwurfsmodell, --spec-type draft-simple wählt die Methode, --spec-draft-n-max legt die Anzahl der im Voraus vorgeschlagenen Tokens fest (in diesem Leitfaden nennen wir sie „Wörter“), und -ngld 99 legt das Entwurfsmodell auf die GPU.
| Konfiguration | Französischer Fließtext | Code | Akzeptanz (Fließtext / Code) |
|---|---|---|---|
| 70B allein | 4,70 | 4,62 | — |
| + Entwurfsmodell Llama 3.2 1B, 8 Wörter Vorlauf | 11,99 (×2,6) | 17,48 (×3,8) | 33 % / 50 % |
| + Entwurfsmodell Llama 3.2 1B, 16 Wörter im Voraus | 10,84 (×2,3) | 18,65 (×4,0) | 19 % / 34 % |
Das Entwurfsmodell mit 1 Milliarde Parametern macht das 70B 2,6- bis 4-mal schneller: 12 tok/s bei Prosa und bis zu 19 tok/s bei Code. Der Gewinn hängt vom Text ab. Bei drei Code-Texten reicht die Geschwindigkeit von 13,2 bis 18,0 tok/s mit 8 Wörtern im Voraus. Dem Entwurfsmodell wird bei Code häufiger gefolgt (50 % übernommene Wörter) als bei Prosa (33 %).
Unsere Texte sind bei Prosa auf Französisch und bei Code auf Englisch; andere Texte führen zu anderen Gewinnen. Bei Prosa liefern 8 Wörter im Voraus bessere Ergebnisse als 16 (11,99 gegenüber 10,84). Bei Code bringen 16 etwas mehr (18,65 gegenüber 17,48), bei einer Streuung zwischen den Texten in derselben Größenordnung. Beginnen Sie mit 8.
Dasselbe Prinzip funktioniert ohne zweite Datei, wenn das Modell ein eigenes Modul zur Vorhersage mehrerer Tokens (MTP) mitbringt. Mit Qwen3.8 27B und der Option --spec-type draft-mtp steigert sich llama.cpp bei Prosa von 11,71 auf 21,48 tok/s (×1,8) und bei Code von 11,59 auf 27,23 tok/s (×2,3).
#Mit TensorRT-LLM: das Draft-Target-Rezept von NVIDIA
TensorRT-LLM ist die Bibliothek von NVIDIA, um Modelle optimiert bereitzustellen. Ihr Leitfaden für DGX Spark schlägt die Draft-Target-Methode vor: Llama 3.3 70B in FP4 wird von Llama 3.1 8B in FP4 als Entwurfsmodell begleitet. Beide Modelle werden von NVIDIA bereitgestellt. In Version 1.3.0rc12 des Containers wird der Wert der Einstellung Draft_Target geschrieben, mit Unterstrich.
| Konfiguration | Französischer Fließtext | Code |
|---|---|---|
| + Draft-Modell Llama 3.1 8B FP4, 4 Wörter Vorlauf | 10,13 (×3,0 gegenüber derselben Engine ohne Entwurfsmodell) | 12,28 (×3,7) |
Mit TensorRT-LLM steigert das Draft-Modell die Geschwindigkeit um den Faktor 3,0 bei Fließtext und 3,7 bei Code, verglichen mit derselben Engine ohne Draft-Modell: Das 70B-Modell schreibt dann 10,1 Tokens pro Sekunde bei Fließtext und 12,3 bei Code.
Beide Wege, llama.cpp und TensorRT-LLM, bringen also eine Beschleunigung in derselben Größenordnung, um das 2,6- bis 4-Fache. Für einen einzelnen Nutzer bleibt llama.cpp am einfachsten: eine Draft-Modelldatei und vier Optionen. TensorRT-LLM ist der richtige Weg, wenn Sie dem offiziellen Rezept von NVIDIA folgen möchten, mit von NVIDIA bereitgestellten FP4-Modellen.
#Das Speicherbudget des Kontexts, von 8 192 bis 131 072 Tokens
Der Kontext kostet Speicher: den KV-Cache. Das ist der Speicher, in dem das Modell festhält, was es bereits gelesen hat, damit es dies nicht neu berechnen muss. Er wächst mit der Kontextlänge. llama.cpp reserviert diesen gesamten Cache bereits beim Laden, daher entspricht der nach dem Laden belegte Speicher schon dem endgültigen Speicherbedarf.
Wir messen ihn am Rückgang des verfügbaren Speichers (MemAvailable unter Linux), nachdem der Festplatten-Cache geleert wurde. Die Option -ctk q8_0 -ctv q8_0 legt den Cache mit 8 Bit statt 16 (f16) ab, was ihn verkleinert. In den Tabellen und Diagrammen steht 8k für einen Kontext von 8 192 Tokens, 32k für 32 768, 64k für 65 536 und 128k für 131 072.
| Modell | Cache | 8 192 | 32 768 | 65 536 | 131 072 |
|---|---|---|---|---|---|
| Llama 3.3 70B Q4_K_M | f16 | 43,6 | 51,3 | 61,4 | 81,9 |
| Llama 3.3 70B Q4_K_M | q8_0 | 42,3 | 46,4 | 52,2 | 63,1 |
| gpt-oss 120B MXFP4 | f16 | 61,0 | 61,9 | 63,0 | 65,6 |
| gpt-oss 120B MXFP4 | q8_0 | 60,7 | 61,3 | 62,1 | 63,2 |
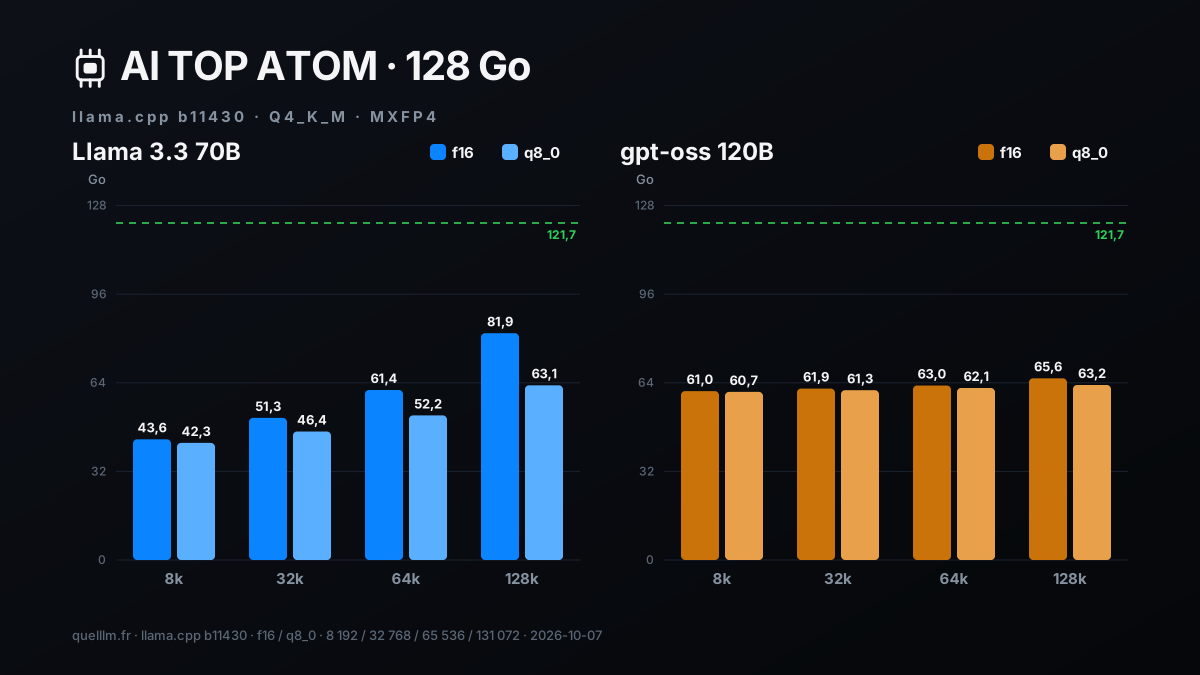
Alles passt in die 121,7 GB, selbst das 70B mit einem Kontext von 131 072 Tokens in f16: 81,9 GB. Der Kontext fügt dem 70B zwischen 8k und 128k in f16 38 GB hinzu, in q8_0 21 GB, also fast die Hälfte weniger. gpt-oss 120B fügt nur 4,6 GB hinzu: Es wechselt zwischen Schichten, die den gesamten Text betrachten, und Schichten, die nur ein kurzes Fenster davon betrachten. Das Format q8_0 wird mit einer etwas geringeren Geschwindigkeit erkauft, 9 bis 11 % bei 128k für das 70B (folgende Tabelle).
Wir haben den Kontext außerdem zu 90 % mit Praxisleitfäden von Service-Public gefüllt, um Lesen und Schreiben bei vollem Kontext zu messen. Bei 128k umfasst der Text 117 605 Tokens für das 70B und 117 889 für gpt-oss 120B, also etwa 200 Seiten.
| Modell | Cache | Gelesener Text (Tokens) | Speicher (GB) | Lecture | Schreiben |
|---|---|---|---|---|---|
| Llama 3.3 70B | f16 | 29 214 (32k) | 51,4 | 286,1 (102 s) | 4,22 |
| Llama 3.3 70B | q8_0 | 29 214 (32k) | 46,5 | 271,1 (108 s) | 4,02 |
| Llama 3.3 70B | f16 | 117 605 (128k) | 82,0 | 181,9 (646 s) | 2,86 |
| Llama 3.3 70B | q8_0 | 117 605 (128k) | 63,2 | 164,6 (715 s) | 2,54 |
| gpt-oss 120B | f16 | 29 227 (32k) | 61,7 | 1 443 (20 s) | 43,81 |
| gpt-oss 120B | q8_0 | 29 227 (32k) | 61,2 | 1 401 (21 s) | 43,96 |
| gpt-oss 120B | f16 | 117 889 (128k) | 65,4 | 1 073 (110 s) | 26,93 |
| gpt-oss 120B | q8_0 | 117 889 (128k) | 63,4 | 993 (119 s) | 24,97 |
Alles funktioniert bei vollem Kontext. gpt-oss 120B liest einen 200-seitigen Text in 110 Sekunden und schreibt weiterhin mit fast 27 tok/s. Das 70B liest die 117 605 Tokens mit 182 tok/s. Für sehr lange Dokumente ist ein MoE-Modell schneller, beim Lesen wie beim Schreiben.
#Zwei Stunden Betrieb mit acht Nutzern
Ein Server muss auf Dauer durchhalten. Wir haben vLLM 26.09 mit Llama 3.3 70B in NVFP4 gestartet und zwei Stunden lang Anfragen gesendet: acht Nutzer im Dauerbetrieb, Blöcke von 32 Anfragen mit 1 024 Tokens Eingabe und 256 Tokens Ausgabe. Eine Aufzeichnung des Chips mit einer Messung pro Sekunde erfasste Leistungsaufnahme, Taktfrequenz und Temperatur der GPU.
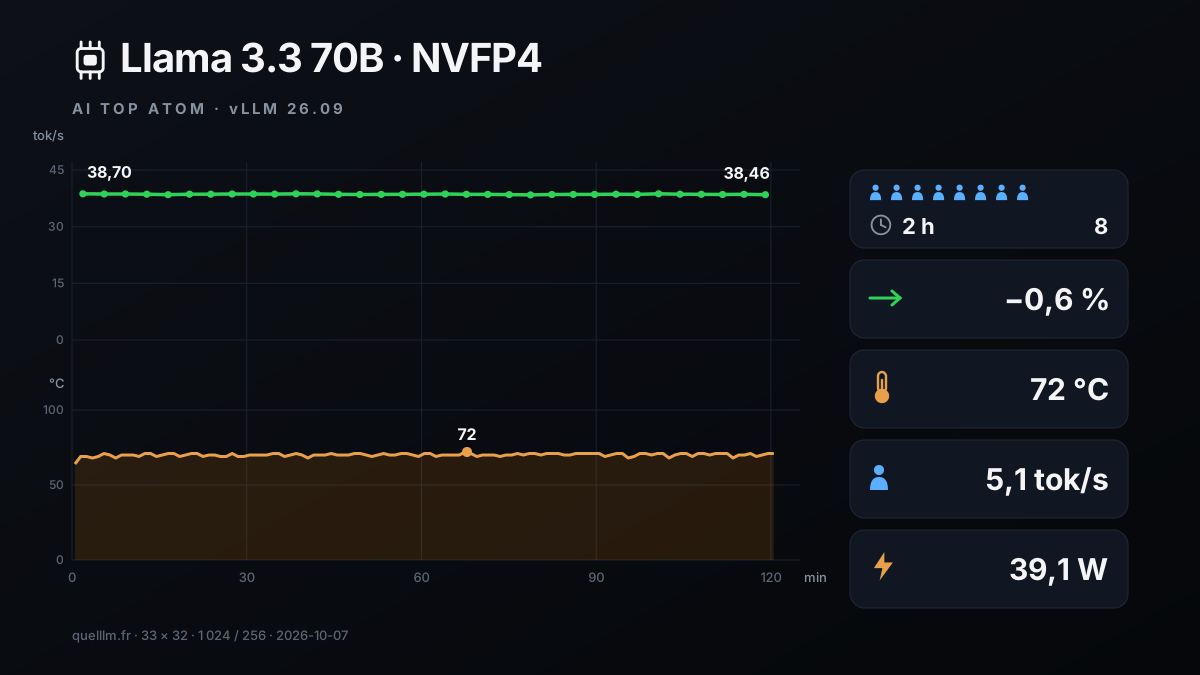
Das Ergebnis ist eindeutig: Die Geschwindigkeit hat sich nicht verändert. Der Gesamtdurchsatz reicht von 38,70 tok/s im ersten Abschnitt bis 38,46 im letzten, mit einem Minimum von 38,40 und einem Maximum von 38,70: Die Abweichung beträgt −0,6 %. Jeder Nutzer erhält 5,1 tok/s. Das erste Wort kommt im Median nach 2,8 s an, je nach Abschnitt zwischen 2,4 und 2,9 s.
Insgesamt hat die Maschine 1.056 Anfragen bedient, 1.081.344 Tokens gelesen und 270.336 Tokens geschrieben, ohne einen einzigen Fehler. Die GPU blieb bei höchstens 72 °C. Ihre mediane Taktfrequenz lag bei 2.528 MHz, und während der zwei Stunden Aufzeichnung wurde kein Drosselungsgrund festgestellt.
Die durchschnittliche Leistungsaufnahme der GPU lag bei 39,1 W, mit einer Spitze von 95,0 W. Diese Wattangaben beziehen sich nur auf die GPU und wurden vom Chip ausgelesen: Prozessor, Arbeitsspeicher, SSD und Netzteil sind nicht enthalten. Die zwei Stunden entsprechen 78,8 Wh für die GPU, also 1,6 Cent zum Tarif EDF Tarif Bleu Base (6 kVA) bei 20,01 Cent pro kWh.
#Als Server betreiben: OpenAI-API, Schlüssel und Open WebUI
Eine OpenAI-API ist ein Anfrageformat, das viele Tools beherrschen: Code-Editoren, Chat-Oberflächen, Skripte. llama-server und vLLM bieten es beide an. Zum Schutz akzeptiert llama-server einen Schlüssel über die Option --api-key: Ohne Schlüssel antwortet er mit einem 401-Fehler. Wir haben diese drei Aufrufe mit gpt-oss 20B validiert; für das 70B ist es derselbe Befehl mit einer anderen Datei.
Der erste Aufruf liefert 401, der zweite die Liste der bereitgestellten Modelle, der dritte eine Antwort im OpenAI-Format. Die Option --jinja wendet die Chat-Vorlage an, die in der Modelldatei enthalten ist.
Für eine Chat-Oberfläche wird Open WebUI an diese API angebunden. Hier ist der Stack unseres Tests eines privaten Assistenten (ein weiterer Leitfaden der Reihe), mit gpt-oss 120B. Der Modellserver befindet sich in einem internen Docker-Netzwerk ohne Internetzugang. Open WebUI 0.11.4 ist mit diesem Netzwerk und mit einem Zugangsnetzwerk verbunden.
So hat das Modell keine Verbindung nach außen. Der Server hat keinen Schlüssel, da nur das interne Netzwerk ihn erreichen kann; der Wert local von OPENAI_API_KEY dient lediglich dazu, Open WebUI zufriedenzustellen. Um stattdessen das 70B bereitzustellen, ersetzen Sie den Dateipfad durch den von Llama-3.3-70B-Instruct-Q4_K_M.gguf und passen Sie -c und -np an das weiter oben beschriebene Speicherbudget an.
Öffnen Sie anschließend http://127.0.0.1:3100 in einem Browser auf dem Rechner: Das Modell erscheint in der Liste. In unserem Test des privaten Assistenten war der komplette Stack, zusätzlich mit einem Embedding-Server (bge-m3), nach 66 Sekunden einsatzbereit. Laut dem llama.cpp-Leitfaden von NVIDIA lassen sich Open WebUI, Continue.dev und weitere Clients an diese API anbinden, die dem Format der OpenAI-API folgt (Serveradresse gefolgt von /v1).
#Die schnelle Alternative: ein MoE-Modell mit 120B
Ein MoE-Modell (Mixture of Experts) enthält viele Parameter, nutzt pro Token aber nur einen Bruchteil davon. gpt-oss 120B umfasst 117 Milliarden Parameter, davon 5,1 Milliarden aktiv, und OpenAI veröffentlicht es direkt im MXFP4-Format.
Auf der GB10 schreibt es mit dem Messwerkzeug llama-bench 58,0 tok/s (Generierung von 32 Tokens) und bei langen Antworten auf llama-server 54,4 tok/s, bei Prosa wie bei Code. Das ist mehr als die 11-fache Geschwindigkeit des dichten 70B, bei einem Speicherbedarf von 61,0 GB bei 8 192 Tokens und 65,6 GB bei 131 072.
Die Geschwindigkeit sagt nichts über die Qualität aus: Wir haben die Antworten der beiden Modelle nicht verglichen. So treffen Sie Ihre Wahl: Nehmen Sie gpt-oss 120B für Konversation, Agenten und lange Dokumente, bei denen die Geschwindigkeit zählt. Nehmen Sie Llama 3.3 70B, wenn Sie genau dieses Modell benötigen, zum Beispiel ein darauf basierendes feinabgestimmtes Modell, oder für Stapelverarbeitungen, bei denen 5 tok/s ausreichen. Die Messungen der 13 Modelle, vom 4B bis zum 235B, finden Sie in unserem ersten Leitfaden der Reihe.
#Was dieser Guide nicht misst
- Die Qualität der Antworten
- Wir messen Geschwindigkeit und Speicherbedarf, nicht die Qualität der einzelnen Modelle.
- Die Gewinne des Draft-Modells bei anderen Texten
- Unsere sechs Texte sind beim Fließtext auf Französisch und beim Code auf Englisch. Die Gewinne hängen von Text und Sprache ab.
- Kontexte über 131 072 Tokens
- Wir haben weder ihren Speicherbedarf noch ihre Geschwindigkeit gemessen.
- Die anderen GB10-Maschinen und die 64-GB-Version
- Unsere Messungen auf dem ATOM 128 GB decken sich mit den veröffentlichten Referenzwerten für den DGX Spark.
- Der Verbrauch des gesamten Geräts
- Die angegebenen Watt beziehen sich auf die GPU und werden vom Chip ausgelesen.
Aktualisierungen und Korrekturen: Diese Seite wird überarbeitet, falls eine neue Version von DGX OS, llama.cpp, Ollama, vLLM oder TensorRT-LLM diese Ergebnisse verändert; jede Korrektur wird datiert.
#Für wen der ATOM die richtige Wahl ist
Das Folgende stammt aus unseren Messungen auf dem ATOM, einer GB10-Maschine mit 128 GB.
- Der ATOM ist die richtige Wahl, wenn Sie ein Modell mit 70 Milliarden Parametern bei sich vor Ort betreiben möchten
- Es passt mit Reserve: 43,6 bis 82 GB von 121,7 GB bei einem Kontext von 8 192 bis 131 072 Tokens, und drei Installationswege funktionieren.
- … wenn sich mehrere Personen oder Agenten das Modell teilen
- Acht Nutzer erreichen bei einer kurzen Serie insgesamt 37,7 tok/s und über zwei Stunden durchschnittlich 38,6 tok/s, ohne einen einzigen Fehler.
- … wenn Sie schneller werden möchten, ohne die Maschine zu wechseln
- Ein kleines Entwurfsmodell steigert die Geschwindigkeit des 70B um das 2,6- bis 4-Fache, mit llama.cpp oder mit dem Rezept von NVIDIA.
- … wenn Sie eine schnelle Unterhaltung oder lange Dokumente wünschen
- gpt-oss 120B schreibt mit 54,4 tok/s und liest 200 Seiten in 110 Sekunden.
- … wenn Ihre Arbeit über das NVIDIA-Ökosystem läuft
- CUDA 13, vLLM und TensorRT-LLM in den Containern von NVIDIA sowie für den GB10 kompiliertes llama.cpp liefen bei uns unter DGX OS 7.5.0.
Auf Seiten von GIGABYTE hielt das rund einen Liter große Gehäuse die GPU während zwei Stunden Dauerlast bei höchstens 72 °C, ohne Drosselung. Die Preise der GB10-Rechner ändern sich wöchentlich: Prüfen Sie sie vor dem Kauf auf der Produktseite des Rechners.
#FAQ
Kann man ein 70B-Modell auf einem GB10-Rechner mit 128 GB ausführen?+
Wie schnell schreibt ein 70B-Modell auf dem AI TOP ATOM?+
Sollte man Ollama, llama.cpp oder vLLM wählen?+
Wie macht man ein 70B-Modell schneller, ohne den Rechner zu wechseln?+
Kann ein 70B-Modell mehrere Personen stundenlang bedienen?+
Ist ein MoE-Modell mit 120B besser als ein dichtes 70B-Modell?+
Haben Sie Feedback, einen Fehler entdeckt oder möchten Sie etwas präzisieren? Geben Sie uns Bescheid – so wird der Guide für alle besser.