GB10, Ryzen AI Max+ 395 oder Mac: Wer ist am schnellsten?
Mit identischer Engine (llama.cpp) liest der AI TOP ATOM mit seinem Chip NVIDIA GB10 Prompts 2,1- bis 2,8-mal so schnell wie der Ryzen AI Max+ 395 und 23 % schneller als der Mac M5 Max beim veröffentlichten Referenzmodell. Beim Schreiben liegt er auf dem Niveau des Ryzen (je nach Modell 4 bis 15 % vorn). Der Mac M5 Max schreibt bei einem kleinen dichten Modell etwa doppelt so schnell: 119,9 gegenüber 59,4 tok/s (Tokens pro Sekunde).
Drei Gerätefamilien bieten 128 GB Speicher für lokale KI: der GB10 von NVIDIA, von dem der AI TOP ATOM von GIGABYTE eine Variante ist, AMDs Ryzen AI Max+ 395 (Codename Strix Halo) und der Mac M5 Max von Apple. Wir haben unseren AI TOP ATOM, den uns GIGABYTE kostenlos zur Verfügung gestellt hat, mit denselben Befehlen gemessen wie bei den veröffentlichten Messungen der beiden anderen, jeweils mit Softwareversion und Datum als Beleg. Hier erfahren Sie, worin jedes Gerät glänzt und welcher Kauf zu welchem Einsatzzweck passt.
#Wie haben wir drei Rechner verglichen?
Um die veröffentlichten Referenzwerte des Ryzen AI Max+ 395 und des Mac mit den Messungen des ATOM zu vergleichen, haben wir exakt das Format bereits veröffentlichter Messungen übernommen. Der erste Test lässt das Gerät 512 Tokens lesen (ein Token ist ein Wortteil) und danach 128 schreiben („pp512“ und „tg128“ in llama-bench, dem Messwerkzeug von llama.cpp, einer weit verbreiteten Open-Source-Engine für lokale Modelle).
Dieser Test wurde für einen Mac M5 Max in der Diskussion Nr. 4167 von llama.cpp veröffentlicht und von kyuz0, einem unabhängigen Mitwirkenden, für einen Framework Desktop mit Ryzen AI Max+ 395 und 128 GB. Der zweite Test misst die Geschwindigkeit, wenn sich bereits 32 768 Tokens im Speicher befinden. Er stammt aus der Diskussion Nr. 16578 von llama.cpp, und kyuz0 veröffentlicht ihn ebenfalls für den Ryzen.
Unser Protokoll wurde am 6. Oktober 2026 um 13:30 Uhr festgeschrieben, vor der ersten Messung. Ein Nachtrag vom selben Tag um 23:45 Uhr hat dieses Vergleichsformat hinzugefügt.
Die Messungen zum Einlesen von 512 Tokens und zum Schreiben von 128 Tokens stammen vom 7. Oktober um 22:38 Uhr: fünf Wiederholungen pro Modell, llama.cpp-Build 11430, schnelle Attention (Flash Attention) aktiviert wie bei den Messungen von kyuz0, Gerät ohne andere laufende Last. Die Messungen bei 32 768 Tokens stammen vom 6. Oktober. Die Methode, die Prüfsummen der Dateien und die Daten unserer Tabellen sind auf unserer Methodenseite veröffentlicht.
Die Geschwindigkeiten sind in Tokens pro Sekunde (tok/s) angegeben. Ein Token ist ein Wortbestandteil: Im Französischen entspricht er etwa zwei Dritteln eines Wortes. Die Speichergrößen sind in GB angegeben (1 GB = 1 024 MB, wie unter Linux angezeigt); die Speicherdurchsätze in GB/s sind die Herstellerangaben, in Dezimaleinheiten. Hier die auf der ATOM verwendeten Befehle:
Ein Hinweis zur Vorsicht: Der Build ist die Versionsnummer von llama.cpp, und die drei Geräte verwenden nicht denselben. Der Ryzen wurde im Mai 2026 mit den Builds b9187 oder b9193 gemessen, der Mac im August mit b10621, der ATOM im Oktober mit b11430.
Ein neuerer Build kann schneller sein. Um fair zu bleiben, geben wir für den Test mit 32 768 Tokens auch unsere Werte mit Build 7941 vom Februar 2026 an, der älter ist als der des Ryzen (für den Mac gibt es in diesem Format keine veröffentlichte Messung).
#Drei Geräte mit 128 GB: Was ist der Unterschied?
Profitiere von unserer Erfahrung und einem geführten Lernpfad, um die passenden Tools für deinen Mac auszuwählen und deine KI im Alltag zu nutzen.
- Lebenslanger Online-Zugang
- PDF + Dateien
- Erstattung binnen 30 Tagen
Der GB10 von NVIDIA vereint 20 Arm-Kerne und eine Blackwell-GPU mit 128 GB Unified Memory (von Prozessor und GPU gemeinsam genutzt), dessen Bandbreite mit 273 GB/s angegeben wird. Auch AMDs Ryzen AI Max+ 395 (Codename Strix Halo) teilt 128 GB zwischen Prozessor und GPU, mit theoretisch etwa 256 GB/s. Der M5 Max von Apple bietet bis zu 128 GB, mit 614 GB/s und einer GPU mit 40 Kernen.
| Rechner | Chip | Speicher | Bandbreite |
|---|---|---|---|
| AI TOP ATOM (GIGABYTE) | NVIDIA GB10: 20 Arm-Kerne und Blackwell-GPU | 128 GB LPDDR5x | 273 GB/s |
| Ryzen AI Max+ 395 (veröffentlichte Zahlen auf einem Framework Desktop) | AMD Strix Halo | 128 GB LPDDR5x | etwa 256 GB/s (theoretisch) |
| Mac M5 Max | Apple M5 Max: GPU mit 40 Kernen | bis zu 128 GB | 614 GB/s |
Um jedes Token zu schreiben, liest der Chip die aktiven Gewichte des Modells (die in diesem Moment genutzten Parameter) erneut aus dem Speicher: Das Schreiben hängt daher von der Speicherbandbreite ab, das Lesen, das viele Tokens gleichzeitig verarbeitet, von der Rechenleistung der GPU.
GB10 und Ryzen haben eine ähnliche Bandbreite – und entsprechend ähnliche Schreibgeschwindigkeiten. Der M5 Max bietet das 2,25-Fache der Bandbreite der ATOM (614 gegenüber 273 GB/s): Beim einzigen veröffentlichten dichten Modell, llama 7B, schreibt er etwa doppelt so schnell.
Unseres Wissens teilen sich alle GB10-Geräte mit 128 GB denselben Chip NVIDIA. Die Geschwindigkeiten in diesem Leitfaden sind daher die der Plattform. Was GIGABYTE zusätzlich beisteuert, sind das Ein-Liter-Gehäuse (1,2 kg), die Kühlung, die Verarbeitung und die Handelsvarianten.
Um zu überprüfen, dass unser Exemplar tatsächlich die Geschwindigkeiten der Plattform liefert, haben wir die vom llama.cpp-Projekt veröffentlichte Tabelle für den DGX Spark von NVIDIA, das Referenzgerät der Plattform (Build 7941, Februar 2026), nachgemessen. Über sechs Modelle und 60 Messpunkte liegen unsere Lesewerte im Median bei +0,3 % (von −1,8 % bis +2,3 %) und unsere Schreibwerte im Median bei −2,8 % (von −4,3 % bis −0,3 %): Beide Geräte liegen auf demselben Niveau.
#Wer liest am schnellsten?
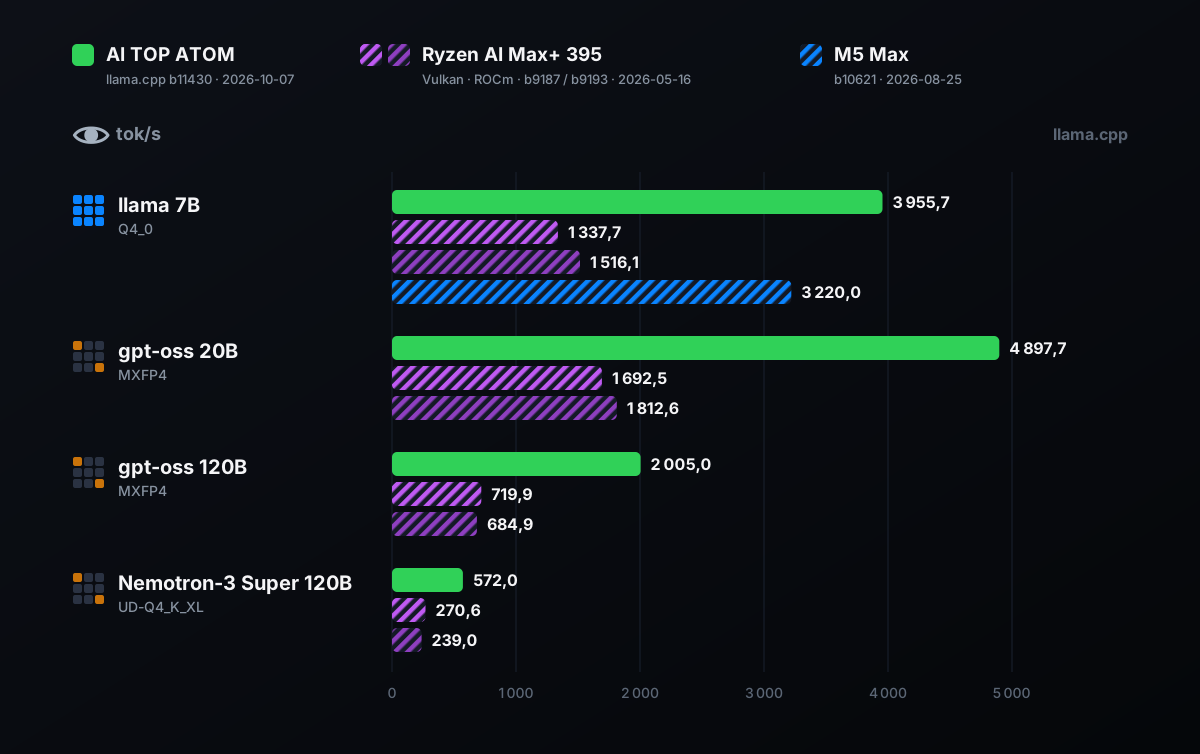
Das Einlesen ist die Stärke der ATOM. Die Tabelle enthält die vier Modelle, die wir exakt vergleichen konnten, also mit demselben Modell und derselben Komprimierung auf jedem Gerät. „llama 7B“ bezeichnet Llama 2 mit 7 Milliarden Parametern, das Referenzmodell dieser Veröffentlichungen: Es ist ein dichtes Modell (es nutzt bei jedem Token alle seine Parameter), während die drei anderen MoE-Modelle sind (sie aktivieren nur einen Teil davon).
| Modell | AI TOP ATOM | Ryzen, Vulkan | Ryzen, ROCm | Mac M5 Max | ATOM / bester Ryzen |
|---|---|---|---|---|---|
| llama 7B (Q4_0) | 3 955,7 | 1 337,7 | 1 516,1 | 3 220,0 | × 2,6 |
| gpt-oss 20B (MXFP4) | 4 897,7 | 1 692,5 | 1 812,6 | — | × 2,7 |
| gpt-oss 120B (MXFP4) | 2 005,0 | 719,9 | 684,9 | — | × 2,8 |
| Nemotron-3 Super 120B (UD-Q4_K_XL) | 572,0 | 270,6 | 239,0 | — | × 2,1 |
Bei diesen vier Modellen liest der ATOM 2,1- bis 2,8-mal schneller als der bessere der beiden Software-Stacks des Ryzen AI Max+ 395 (Vulkan und ROCm sind zwei Wege, die AMD-GPU rechnen zu lassen). Bei gpt-oss 120B liest er 2 005 Tokens pro Sekunde: Ein Prompt von 2 000 Tokens, also etwa 1 300 Wörtern, wird in einer Sekunde verarbeitet.
Gegenüber dem Mac haben wir nur einen veröffentlichten Vergleichspunkt im llama-bench-Format: das Referenzmodell der Diskussion Nr. 4167 von llama.cpp zu den Apple-Chips, llama 7B (Llama 2 mit 7 Milliarden Parametern) in Q4_0. Der ATOM liest dort 3 955,7 Tokens pro Sekunde, gegenüber 3 220,0 für den M5 Max: 23 % mehr.
Mit Ollama (einem Tool, das Modelle lokal ausführt) misst unser erster Leitfaden der Reihe bei einem Dokument von etwa 17 000 Tokens 1 816 tok/s auf gpt-oss 120B für den ATOM, gegenüber 1 388 für ein von einem Leser gemessenes MacBook Pro M5 Max, bei einem ähnlichen, aber nicht identischen Text (16 850 Tokens für den ATOM, 16 689 für den Mac): 31 % mehr.
Warum liest der ATOM so schnell? Lesen ist vor allem Rechenarbeit, und die Blackwell-GPU des GB10 verfügt über dedizierte Kerne für KI-Berechnungen (die „Tensor Cores“ von NVIDIA). Das ist das entscheidende Kriterium für einen Bericht von fünfzig Seiten, ein Code-Repository oder einen Agenten, der vor jeder Antwort seinen Verlauf erneut liest.
Zwei Hinweise zur Einordnung. Erstens unterscheiden sich die Builds (10621 für den Mac, 11430 für den ATOM): Betrachten Sie den Unterschied von 23 % als Größenordnung. Zweitens schwanken die beiden kleinsten Modelle (llama 7B und gpt-oss 20B) von einer Wiederholung zur nächsten um 3 bis 5 %, da dieser Test etwa eine Zehntelsekunde dauert. Zwei getrennte Messreihen ergeben dennoch Mittelwerte, die auf 1 % übereinstimmen: 3 955,7 und 3 920,2 für llama 7B, 4 897,7 und 4 905,2 für gpt-oss 20B.
#Wer schreibt am schnellsten?
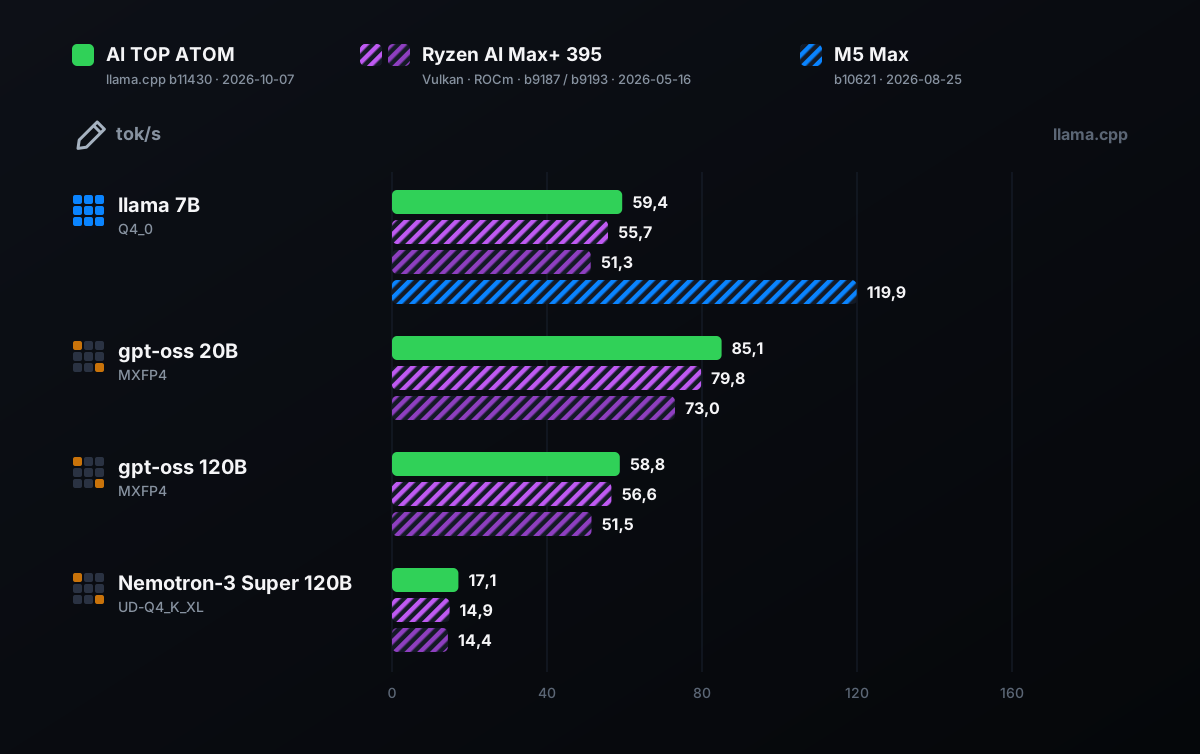
Das Schreiben ist das Tempo, in dem die Antwort angezeigt wird. Es folgt der Speicherbandbreite, die sich von Gerät zu Gerät unterscheidet.
| Modell | AI TOP ATOM | Ryzen, Vulkan | Ryzen, ROCm | Mac M5 Max | ATOM / bester Ryzen |
|---|---|---|---|---|---|
| llama 7B (Q4_0) | 59,4 | 55,7 | 51,3 | 119,9 | +7 % |
| gpt-oss 20B (MXFP4) | 85,1 | 79,8 | 73,0 | — | +7 % |
| gpt-oss 120B (MXFP4) | 58,8 | 56,6 | 51,5 | — | +4 % |
| Nemotron-3 Super 120B (UD-Q4_K_XL) | 17,1 | 14,9 | 14,4 | — | +15 % |
Gegenüber dem besten Software-Stack des Ryzen AI Max+ 395 schreibt der ATOM bei drei Modellen 4 bis 7 % schneller und bei Nemotron-3 Super 120B 15 % schneller. Das ist ein ähnliches Niveau: Beide Speicher haben eine vergleichbare Bandbreite, und die Builds unterscheiden sich.
Bei gpt-oss 120B, einem Modell mit 117 Milliarden Parametern, schreibt der ATOM 58,8 Tokens pro Sekunde über 128 Tokens (58,0 über 32 Tokens in unserem ersten Leitfaden), was für eine Unterhaltung sehr flüssig ist; der Ryzen schafft bestenfalls 56,6.
Der Mac M5 Max schreibt schneller, bei einem kleinen dichten Modell etwa doppelt so schnell (119,9 gegenüber 59,4 Tokens pro Sekunde), dank seines Speichers mit 614 GB/s, also dem 2,25-Fachen der ATOM.
Bei einem dichten Modell kann Software das Schreiben beschleunigen. Mit einem kleinen „Entwurfsmodell“, das Tokens vorschlägt, die das große Modell in einem Schritt bestätigt (spekulatives Dekodieren), steigt Llama 3.3 70B auf dem ATOM bei französischem Text von 4,7 auf 12 Tokens pro Sekunde (8 Wörter Vorlauf) und bei Code auf bis zu 18,7 (16 Wörter Vorlauf): 2,6- bis 4-mal so schnell (llama-server b11430, Entwurfsmodell Llama 3.2 1B, 6. und 7. Oktober 2026). Diese Technik gibt es auch auf den anderen Geräten; dort haben wir sie nicht gemessen.
#Was passiert bei einem langen Dokument?
Je länger der bereits vorhandene Text ist, desto langsamer wird die Fortsetzung. Der Test mit großem Kontext misst Lesen und Schreiben, wenn sich bereits 32 768 Tokens im Speicher befinden, also rund fünfzig Seiten. Die Tabelle vergleicht den ATOM mit dem Ryzen AI Max+ 395 bei den beiden gpt-oss-Modellen, mit zwei Builds für den ATOM. Unseres Wissens gibt es für den Mac keine veröffentlichte Messung im selben Format.

| Modell | Gerät und Software-Stack | Einlesen bei 32 768 | Schreiben bei 32 768 |
|---|---|---|---|
| gpt-oss 120B | AI TOP ATOM, Build 11430 | 1 832,4 | 42,2 |
| gpt-oss 120B | AI TOP ATOM, Build 7941 | 1 551,3 | 41,3 |
| gpt-oss 120B | Ryzen AI Max+ 395, ROCm | 653,1 | 36,3 |
| gpt-oss 120B | Ryzen AI Max+ 395, Vulkan | 307,5 | 43,0 |
| gpt-oss 20B | AI TOP ATOM, Build 11430 | 3 315,6 | 62,5 |
| gpt-oss 20B | AI TOP ATOM, Build 7941 | 2 708,0 | 60,7 |
| gpt-oss 20B | Ryzen AI Max+ 395, ROCm | 1 124,1 | 52,2 |
| gpt-oss 20B | Ryzen AI Max+ 395, Vulkan | 555,7 | 61,1 |
Mit gpt-oss 120B liest der ATOM bei 32 768 Tokens Kontext 1 832 Tokens pro Sekunde: 2,8-mal so schnell wie der Ryzen AI Max+ 395 mit ROCm (653) und 6-mal so schnell wie mit Vulkan (308). Mit Build 7941, der älter ist als der des Ryzen, beträgt der Vorsprung immer noch das 2,4- bzw. 5-Fache. Mit gpt-oss 20B und Build 11430 beträgt der Vorsprung das 2,9- bzw. 6,0-Fache.
Beim Schreiben bei 32 768 Tokens liegt der ATOM (42,2 tok/s mit gpt-oss 120B) auf dem Niveau des besten Software-Stacks des Ryzen (43,0 mit Vulkan) und vor dem anderen (36,3 mit ROCm). Das Ergebnis ist also einfach: Bei einem langen Dokument schreibt der AMD-Rechner mit seinem besten Software-Stack (43,0 mit Vulkan) genauso schnell, braucht aber 2,8- bis 6-mal so lange, um es zu lesen.
In der Praxis liest unser ATOM mit llama-server (dem Server von llama.cpp) ein Dokument von 30 000 Tokens mit gpt-oss 120B in 21,8 Sekunden und schreibt seine Antwort dann mit 42,8 Tokens pro Sekunde (Messung aus unserem ersten Leitfaden der Reihe).
#Und mit mehreren Nutzern?
Wenn mehrere Personen oder mehrere Agenten (KI-Programme, die selbstständig arbeiten) das Gerät gleichzeitig abfragen, bündelt ein Server wie vLLM ihre Anfragen und liest die Modellgewichte für alle Anfragen zusammen nur ein einziges Mal. Die Speicherbandbreite ist dann nicht mehr die einzige Bremse: Die Rechenleistung des GB10 übernimmt.
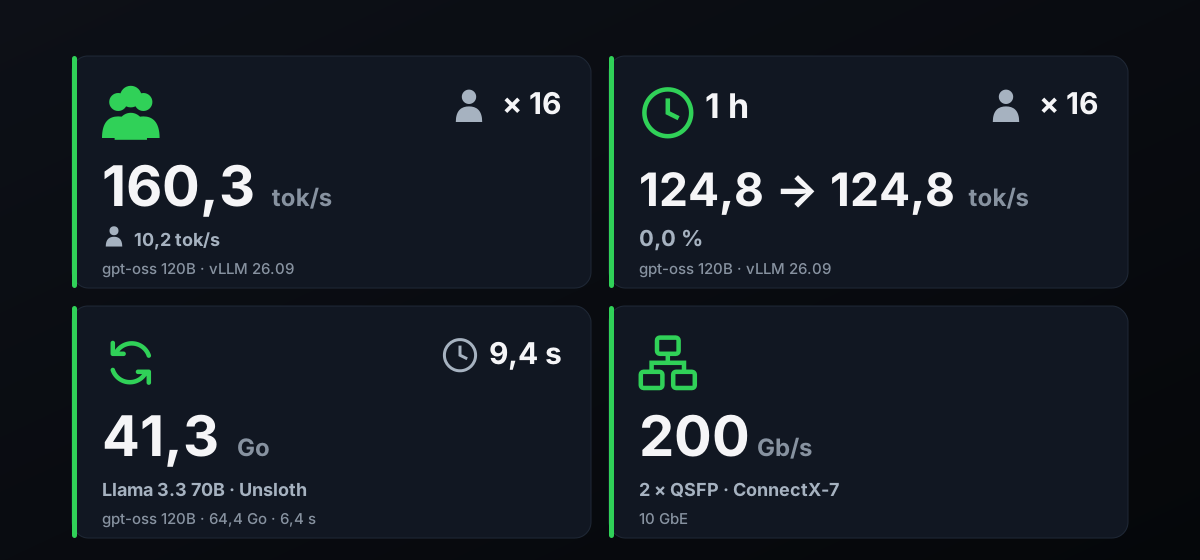
In unserem ersten Leitfaden steigt gpt-oss 120B von 35,6 tok/s für eine Person auf insgesamt 160,3 tok/s für 16 Personen, wobei jede noch 10,2 tok/s erhält. gpt-oss 20B steigt von 49,1 auf insgesamt 322,4 tok/s, mit 20,7 tok/s pro Person (vLLM 26.09, 6. Oktober 2026).
Die Dauerleistung zählt ebenso wie der Spitzenwert. Während 1 h mit 16 Nutzern (Anfragen mit 4 096 Tokens, Antworten mit 512) hielt gpt-oss 120B vom Anfang bis zum Ende insgesamt 124,8 Tokens pro Sekunde: zwischen 122,6 und 128,1 über die 14 Messabschnitte, also 0,0 % Abweichung, bei höchstens 77 °C GPU-Temperatur und ohne jede Drosselung.
Während 2 h mit 8 Nutzern auf Llama 3.3 70B in NVFP4 (einem komprimierten Format von NVIDIA) sank der Gesamtdurchsatz von 38,7 auf 38,5 Tokens pro Sekunde (−0,6 %).
StorageReview hat eine vergleichbare Last mit vLLM auf dem AMD-Gerät Ryzen AI Halo aus der Ryzen-AI-Max-Familie im Vergleich zu einem DGX Spark gemessen. Das AMD-Gerät lag in den meisten Szenarien mit hoher Parallelität 2- bis 4-mal zurück und bei einem leseintensiven Test mit gpt-oss 120B bis zu 8,8-mal. Der DGX Spark nutzt denselben Chip wie der ATOM; diese Ryzen-Zahlen stammen aus dem Test von StorageReview.
#Was ändert CUDA, insbesondere beim Training?
CUDA ist die Softwareplattform von NVIDIA für Berechnungen auf ihren GPUs. Auf dem ATOM liefen bei uns unter DGX OS 7.5.0 (CUDA 13.0, Treiber 580.159.03) ein für den Chip kompiliertes llama.cpp, vLLM im von NVIDIA bereitgestellten Container sowie Unsloth. Unseres Wissens werden viele KI-Tools zuerst für CUDA geschrieben: Das ist ein Vorteil, um Modelle bereitzustellen und zu trainieren.
Für das Training gibt NVIDIA eine Feinabstimmung von Modellen mit bis zu 70 Milliarden Parametern auf der Plattform an. Wir haben zwei Fälle mit Unsloth 2026.10.1 und der QLoRA-Methode (eine Feinabstimmung mit auf 4 Bit komprimierten Gewichten) gemessen, mit Sequenzen von 1 024 Tokens und 40 Schritten, von denen die ersten 10 zum Aufwärmen dienen.
Llama 3.3 70B benötigt in der Spitze 41,3 GB GPU-Speicher und 9,4 Sekunden pro Schritt. gpt-oss 120B benötigt 64,4 GB und 6,4 Sekunden pro Schritt. Zwei Modelle dieser Größe lassen sich also im Speicher der ATOM trainieren, mit Reserve.
Ein konkretes Beispiel: Ein leichtes Feintuning vom Typ LoRA von 85 Minuten mit Qwen3-8B (eine Epoche, 2 000 Beispiele) hat den Anteil der völlig fehlerfrei extrahierten Rechnungen von 26,0 % auf 95,0 % gesteigert, bei 200 nie zuvor gesehenen Dokumenten und strenger Bewertung. Das ist besser als gpt-oss 120B ohne Training (62,5 %). Die Rechnungen sind fiktiv und von uns selbst erzeugt. Unser Leitfaden dieser Reihe zum Fine-Tuning beschreibt die Methode im Detail.
Zwei QSFP-Ports (die Netzwerkkarte ConnectX-7, laut GIGABYTE 200 Gb/s) und ein 10-GbE-Port runden den Rechner ab. Laut GIGABYTE lassen sich bis zu vier GB10-Rechner zu einem Cluster verbinden; diesen Aufbau haben wir nicht getestet.
#Was kosten diese drei Rechner?
Bruttopreise inkl. MwSt., erhoben am 8. Oktober 2026 in Frankreich auf den Seiten der Händler. Die GB10-Preise ändern sich jede Woche: Prüfen Sie sie vor dem Kauf.
| Rechner | Konfiguration | Preis inklusive Mehrwertsteuer | Marchand |
|---|---|---|---|
| GMKtec EVO-X2 (Ryzen AI Max+ 395) | 128 GB, SSD 2 TB | 3 449,99 € | gmktec.fr |
| Minisforum MS-S1 MAX (Ryzen AI Max+ 395) | 128 GB, SSD 2 TB | 4 159,00 € | minisforumpc.fr |
| AI TOP ATOM ATAGB10-9001 | 128 GB, SSD 4 TB PCIe 4.0 | 6 346,27 € (am 8. Oktober ausverkauft) | offizieller AORUS-Shop (auf Amazon.fr vorrätig) |
| MSI EdgeXpert (GB10) | 128 GB, SSD 4 TB | 6 599,95 € (am 8. Oktober nicht vorrätig) | Materiel.net |
| AI TOP ATOM ATAGB10-9000 | 128 GB, SSD 4 TB PCIe 5.0 | 7 999,95 € (am 8. Oktober nicht vorrätig) | LDLC, Materiel.net |
| Mac Studio M5 Max (18 CPU-Kerne, 40 GPU-Kerne) | 128 GB, SSD 512 GB | 5 859 € | apple.com/fr |
| Mac Studio M5 Max (18 CPU-Kerne, 40 GPU-Kerne) | 128 GB, SSD 4 TB | 7 839 € (berechnet) | apple.com/fr, Speicheroptionen |
Der Ryzen AI Max+ 395 ist das günstigste Gerät. Bei gleichem Speicherplatz von 4 TB liegen die ATOM 9000 (SSD mit PCIe 5.0, die von uns gemessene Version) und ein Mac Studio M5 Max in derselben Preisspanne. Die ATOM 9001 mit einer SSD mit PCIe 4.0 ist das günstigste GB10-Gerät mit 128 GB in der Tabelle; nach unserem Kenntnisstand hat sie denselben Chip und denselben Speicher.
Die SSD wirkt sich vor allem auf die Ladezeit eines Modells aus, nicht auf seine Rechengeschwindigkeit; die SSD-Messwerte beziehen sich auf die Version 9000. Wir nennen auch den Preis eines Mac Studio M5 Max, da er denselben Chip verwendet wie die in den Veröffentlichungen gemessenen Geräte; seine Geschwindigkeit wurde in diesem Leitfaden nicht gemessen.
Die beiden ATOM unterscheiden sich durch ihr Ein-Liter-Gehäuse (1,2 kg) und durch die Entscheidungen von GIGABYTE: Kühlung, Verarbeitung, Modellvarianten.
#Was dieser Vergleich nicht aussagt
- Herkunft der Messwerte
- Die Werte des Ryzen AI Max+ 395 (ein Framework Desktop mit 128 GB) und des Mac M5 Max stammen aus Veröffentlichungen, mit Build und Datum; die Mini-PCs in der Preistabelle wurden nicht gemessen. Werten Sie Abweichungen unter 10 % als Gleichstand: Builds ändern sich, und zwei Exemplare desselben Modells unterscheiden sich um einige Prozent.
- Die MLX-Engine von Apple wurde nicht gemessen
- Auf dem Mac kann MLX andere Geschwindigkeiten liefern als llama.cpp oder Ollama. Unser Leitfaden MLX vs. llama.cpp erläutert diesen Unterschied im Detail.
- Nur ein gemeinsames Modell mit dem Mac
- Das für den M5 Max veröffentlichte llama-bench-Format deckt nur llama 7B ab. Für große Modelle haben wir nur die Ollama-Messung eines Lesers.
- Die Qualität der Antworten
- Dieser Leitfaden vergleicht Geschwindigkeiten, nicht die Qualität der Modelle.
- Mehrere Nutzer und Training auf den anderen Geräten
- Wir haben sie weder auf dem Ryzen noch auf dem Mac gemessen. Für den Ryzen zitieren wir StorageReview.
Aktualisierungen und Korrekturen: Diese Seite wird überarbeitet, wenn ein neuer Build von llama.cpp oder eine neue Veröffentlichung diese Ergebnisse verändert; jede Korrektur wird datiert.
#Für wen der ATOM die richtige Wahl ist
Das Folgende beruht auf unseren Messungen am ATOM und den oben zitierten veröffentlichten Zahlen.
- Die ATOM ist die richtige Wahl, wenn Sie lange Dokumente oder Code einlesen
- Er liest gpt-oss 120B mit 32 768 Tokens im Speicher 2,8-mal so schnell wie der Ryzen AI Max+ 395 und ein Dokument von 30 000 Tokens in 21,8 Sekunden.
- … wenn sich mehrere Personen oder Agenten das Gerät teilen
- Insgesamt 160,3 Tokens pro Sekunde für 16 Nutzer mit gpt-oss 120B; bei längeren Anfragen blieb der Durchsatz 1 Stunde lang ohne Einbruch bei 124,8 Tokens pro Sekunde.
- … wenn Sie Modelle trainieren oder anpassen
- Ein QLoRA mit 70 Milliarden Parametern passt in 41,3 GB. Ein LoRA mit Rechnungen dauerte 85 Minuten.
- … wenn Sie große MoE-Modelle in einem Ein-Liter-Gehäuse möchten
- gpt-oss 120B schreibt 58,8 Tokens pro Sekunde auf einem Gerät mit 1,2 kg.
- Ein Mac M5 Max ist besser geeignet, wenn Sie allein mit kleinen dichten Modellen schreiben
- Er schreibt bei llama 7B etwa doppelt so schnell (119,9 gegenüber 59,4 Tokens pro Sekunde).
- Ein Mini-PC mit Ryzen AI Max+ 395 ist besser geeignet, wenn das Budget entscheidet
- Beim Schreiben liegen die Werte bei MoE-Modellen nah beieinander, ab 3 449,99 €, doch das Einlesen ist 2,1- bis 2,8-mal langsamer.
Zusammengefasst: Wenn Ihre Arbeit darin besteht, lange Texte zu lesen, ist der ATOM laut unseren Vergleichen die richtige Wahl. Für die Bereitstellung für mehrere Personen oder für Training sind seine eigenen Messwerte solide: insgesamt 160,3 Tokens pro Sekunde für 16 Nutzer, ein QLoRA mit 70 Milliarden Parametern in 41,3 GB. Wenn Sie allein mit kleinen dichten Modellen schreiben, sehen Sie sich den Mac an. Wenn das Budget entscheidet, sehen Sie sich den Ryzen an.
#FAQ
Welches Gerät ist am schnellsten: der GB10, der Ryzen AI Max+ 395 oder der Mac M5 Max?+
Ist die AI TOP ATOM schneller als ein Mac M5 Max?+
Warum unterscheiden sich die Zahlen für dasselbe Gerät von Website zu Website?+
Wie vergleiche ich meinen eigenen Rechner mit diesen Zahlen?+
Ist der Ryzen AI Max+ 395 eine gute Wahl gegenüber dem GB10?+
Haben Sie Feedback, einen Fehler entdeckt oder möchten Sie etwas präzisieren? Geben Sie uns Bescheid – so wird der Guide für alle besser.