AI TOP ATOM vs. DGX Spark: Welche Unterschiede gibt es? wirklich?
Eine GIGABYTE AI TOP ATOM und ein DGX Spark von NVIDIA basieren auf demselben GB10-Chip und denselben 128 GB Speicher. Unsere Messungen weichen mit llama.cpp höchstens um 4,3 % von den für den DGX Spark veröffentlichten Werten ab, mit Ollama höchstens um 2 %. GIGABYTE bringt sein eigenes Gehäuse im selben Ein-Liter-Format wie die Founders Edition, seine Kühlung und seine sechs Varianten ein. Während 2 Stunden Dauerlast blieb die Geschwindigkeit stabil, ohne jegliche erzwungene Drosselung.
Der DGX Spark von NVIDIA und der AI TOP ATOM von GIGABYTE basieren auf demselben GB10-Chip. Was ändert sich wirklich? Auf unserem von GIGABYTE kostenlos bereitgestellten AI TOP ATOM haben wir drei veröffentlichte Messreihen für den DGX Spark wiederholt und anschließend sein Lastverhalten über 1 und 2 Stunden, seine Temperaturen und seine SSD gemessen sowie seine Anschlüsse überprüft. Es folgen die Preise nach Referenz und unsere Kaufempfehlungen.
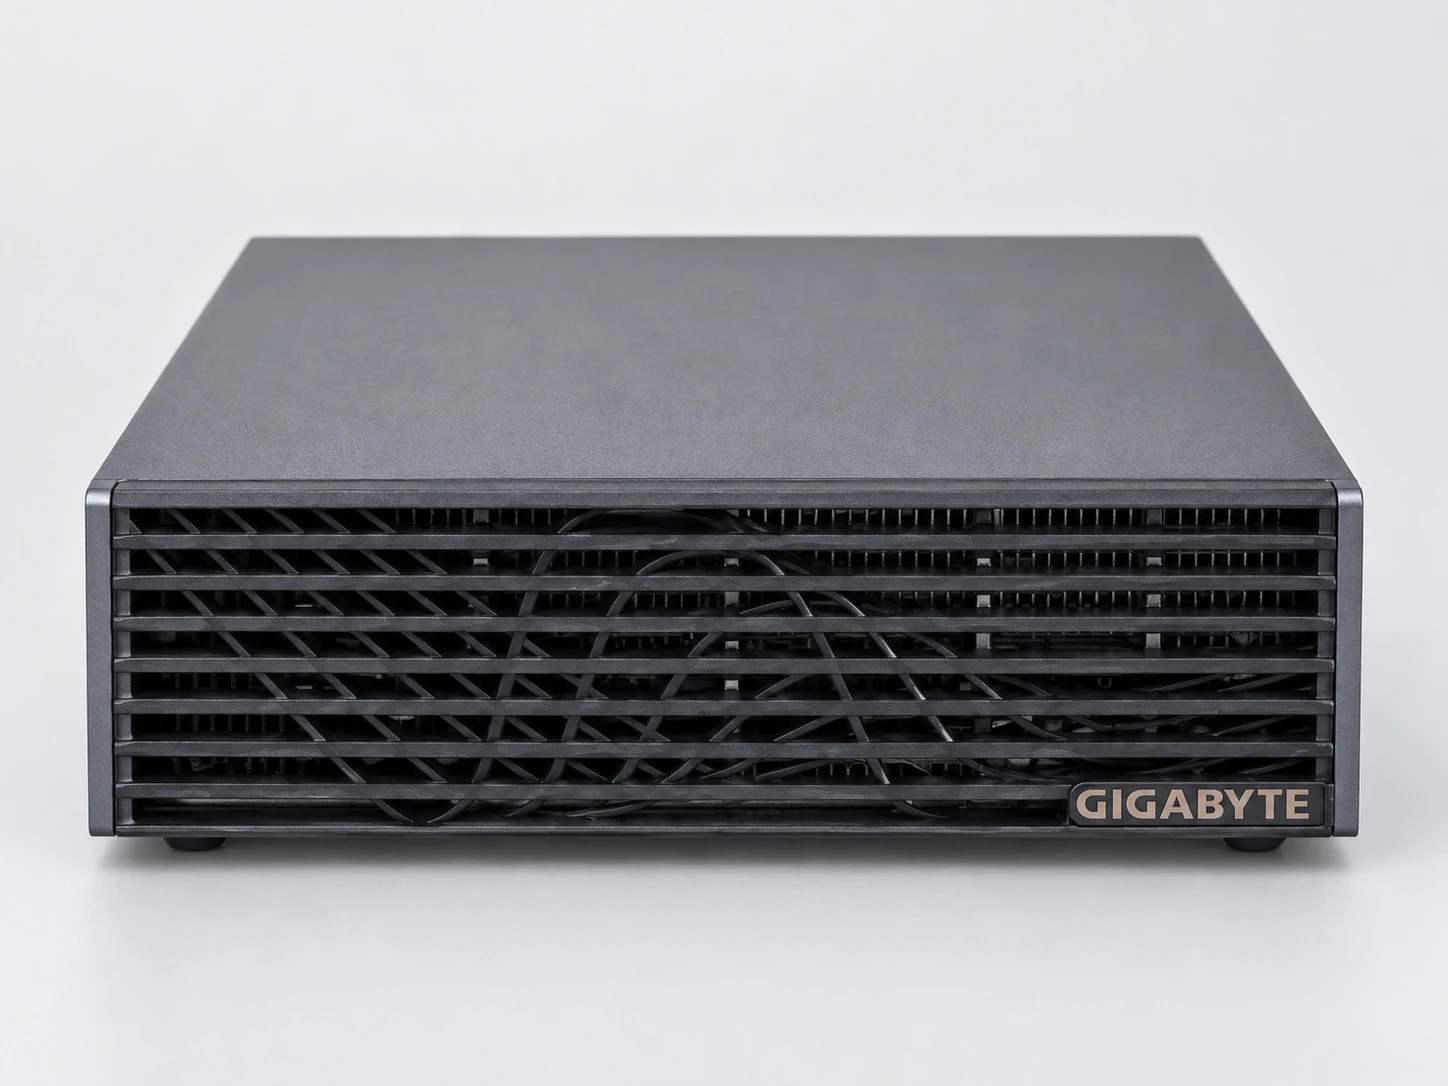
#Derselbe NVIDIA-GB10-Chip, GIGABYTE-Konstruktion
Der DGX Spark ist eine NVIDIA-Plattform. Sein GB10-Chip vereint 20 Arm-Kerne und eine GPU der Blackwell-Generation, die sich 128 GB Speicher mit einer angekündigten Bandbreite von 273 GB/s teilen. NVIDIA liefert außerdem das DGX-OS-System, den Treiber und CUDA. Der von NVIDIA verkaufte DGX Spark heißt Founders Edition. Andere Hersteller, darunter GIGABYTE, bieten ihre eigene Maschine auf derselben Grundlage an.
Diese Trennung strukturiert den gesamten Leitfaden. Was von NVIDIA stammt, findet sich auf allen GB10-Maschinen: Der nächste Abschnitt überprüft dies anhand von Messungen. Was von GIGABYTE stammt, wird am Gehäuse, an der Kühlung, am Speicher, an den Referenzen und an der Garantie beurteilt. StorageReview, eine US-amerikanische Website für Hardwaretests, schreibt, dass die Leistungsunterschiede bei KI eng beieinanderliegen, da alle diese Maschinen dieselbe GB10-Basis verwenden.
| Element | Bereitgestellt von | Auf unserem AI TOP ATOM |
|---|---|---|
| GB10-Chip: 20 Arm-Kerne, Blackwell-GPU | NVIDIA | Geschwindigkeiten weniger als 5 % unter den veröffentlichten Werten (nächster Abschnitt) |
| Vereinheitlichter Speicher mit 128 GB, 273 GB/s | NVIDIA (Plattform) | Das System erkennt 121,7 GB; ein Teil davon ist für den Start reserviert |
| DGX OS, Treiber, CUDA | NVIDIA | DGX OS 7.5.0, Treiber 580.159.03, CUDA 13.0 |
| Abmessungen von 150 × 150 × 50,5 mm und 1,2 kg | Dasselbe Format wie die Founders Edition | Mattschwarzes Gehäuse, Lamellenfront ohne Anschluss und Taste |
| Kühlung und Verarbeitung | GIGABYTE | Kühlkörper, Kupferplatten, Heatpipes und zwei Lüfter laut ServeTheHome |
| SSD: Kapazität und PCIe-Generation | GIGABYTE (je nach Referenz) | Samsung mit 4 TB, verifiziertes PCIe 5.0 (32 GT/s auf 4 Leitungen) |
| 240-W-Netzteil über USB-C | GIGABYTE (Adapter im Lieferumfang) | NVIDIA fordert die Verwendung des mitgelieferten Netzteils |
| Referenzen, Preise, Garantie | GIGABYTE und Händler | Siehe die Abschnitte zu Referenzen und Preisen |
#Dieselben Geschwindigkeiten wie beim DGX Spark: drei Überprüfungen
Um das ATOM mit den Referenzwerten des DGX Spark zu vergleichen, haben wir drei veröffentlichte Messungen für dieses Gerät mit demselben Tool wiederholt. Für llama.cpp und Ollama sind auch Version und Einstellungen identisch; für vLLM wurden Version und Befehl nicht veröffentlicht. Wenn unser ATOM dieselben Zahlen liefert, bietet es dieselbe Leistung wie die Referenz.
#Methode und Einheiten
Jede Geschwindigkeit von llama.cpp ist der Durchschnitt von 5 Wiederholungen mit einer Standardabweichung unter 3 % (die Standardabweichung misst die Streuung der Wiederholungen). Die Lesegeschwindigkeit ist die Geschwindigkeit, mit der die Maschine Ihren Text aufnimmt, bevor sie antwortet. Die Schreibgeschwindigkeit ist die Geschwindigkeit, mit der die Antwort angezeigt wird.
Beide werden in Token pro Sekunde (Tok/s) gemessen; ein Token ist ein Wortbestandteil, im Französischen ungefähr zwei Drittel eines Wortes. Speicher und Festplattendurchsatz werden in GB und GB/s angegeben, wie es Linux anzeigt: 1 GB = 1 024 MB.
Das Protokoll wurde vor der ersten Messung festgelegt. Jeder danach hinzugefügte Test wird in einem datierten Nachtrag beschrieben, der vor dem Test verfasst wurde. Die Methode, die datierte Liste der Nachträge und die Daten unserer Tabellen werden auf unserer Methodenseite veröffentlicht.
#Mit llama.cpp: bis auf 4,3 % genau
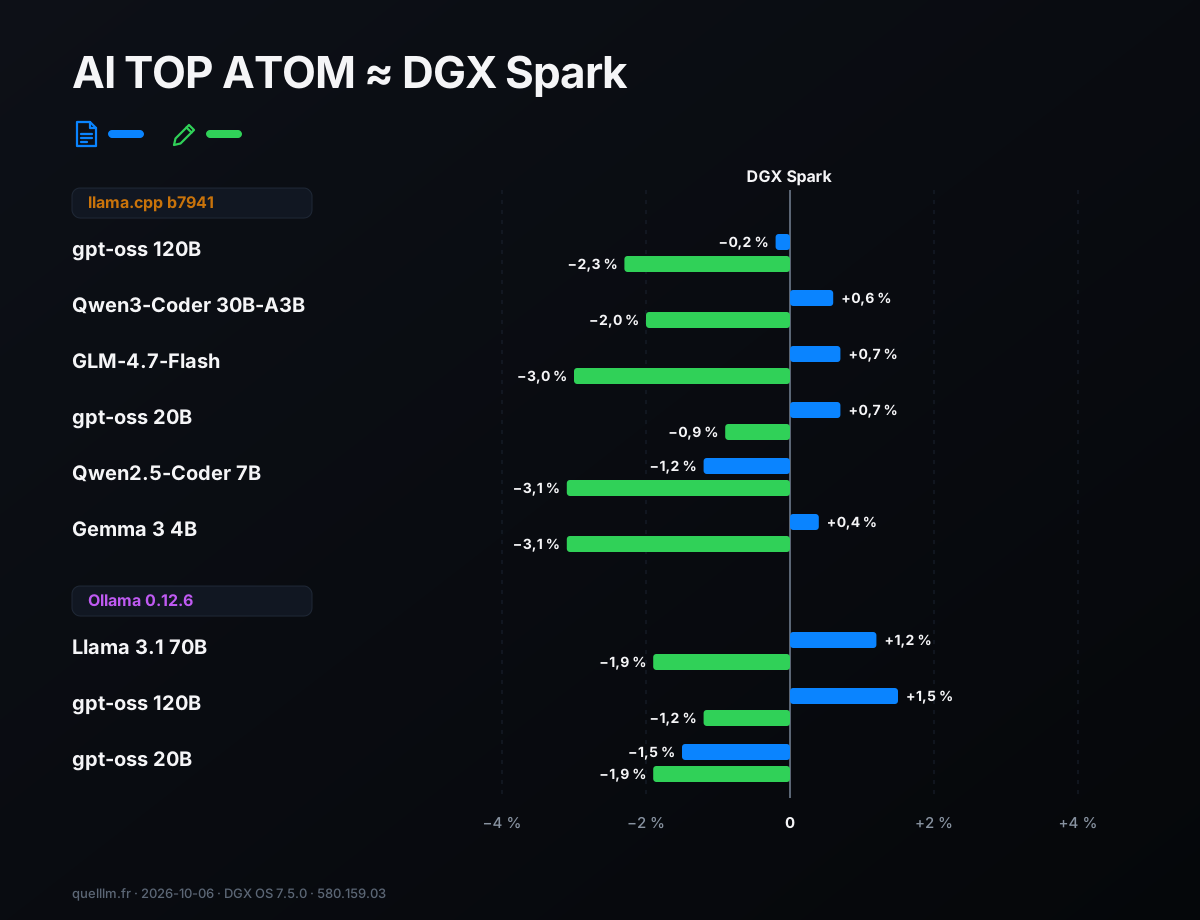
llama.cpp ist eine weit verbreitete Open-Source-Engine, um Modelle lokal auszuführen. Das Projekt veröffentlicht für den DGX Spark eine Referenztabelle auf Build 7941 (das ist die Versionsnummer der Software), im Februar 2026. Wir haben denselben Build kompiliert und denselben Befehl auf sechs Modellen und mit fünf Kontexttiefen ausgeführt, also 60 Messpunkte erfasst. Der Kontext ist der bereits im Speicher vorhandene Text: von 0 bis 32 768 Tokens.
Ergebnis: Die Lesegeschwindigkeit ist bis auf 2,3 % identisch, mit einer medianen Abweichung von +0,3 %. Die Schreibgeschwindigkeit bleibt auf demselben Niveau, mit einer medianen Abweichung von −2,8 % (höchstens 4,3 %). Für gpt-oss 120B ist das Lesen bei leerem Kontext gleich dem Referenzwert: 2 443,9 Tok/s auf beiden Seiten. Die Referenztabelle stammt von einem älteren Treiber (580.95.05) als unserer (580.159.03).
#Mit dem offiziellen Skript von Ollama: höchstens 2 % Abweichung
Ollama veröffentlichte im Oktober 2025 eigene Messungen für den DGX Spark, mit Version 0.12.6 und dem Treiber 580.95.05. Wir verwendeten dieselbe Version und dasselbe Skript, mit 10 Durchläufen und einer Temperatur von 0. Die drei veröffentlichten Modelle liefern beim Lesen wie beim Schreiben Ergebnisse mit einer Abweichung von höchstens 2 %.
| Modell | Lesen: wir / veröffentlicht | Abstand | Schreiben: wir / veröffentlicht | Abstand |
|---|---|---|---|---|
| gpt-oss 20B | 3 175,0 / 3 224 | −1,5 % | 57,18 / 58,27 | −1,9 % |
| gpt-oss 120B | 1 186,8 / 1 169 | +1,5 % | 40,65 / 41,14 | −1,2 % |
| Llama 3.1 70B | 1 933,6 / 1 911 | +1,2 % | 4,34 / 4,423 | −1,9 % |
#Mit vLLM: dieselbe Größenordnung, andere Engine
StorageReview hat den ATOM am 3. März 2026 mit vLLM gemessen, einem Server, der dafür ausgelegt ist, gleichzeitig mehreren Personen zu antworten, auf gpt-oss 120B. StorageReview veröffentlicht weder die vLLM-Version noch den exakten Befehl. Wir haben die drei Szenarien mit vLLM 26.09 für 1 und für 64 Benutzer erneut durchgeführt.
Unsere Durchsatzwerte liegen in derselben Größenordnung wie seine, je nach Szenario darüber oder darunter. Mit einem Benutzer erreichen wir in dem Szenario, in dem die Maschine 4.096 Tokens liest und 512 schreibt, insgesamt 304,4 Tokens pro Sekunde, gegenüber 304,6 bei StorageReview.
Mit 64 Nutzern erreichen wir im ausgewogenen Szenario (256 gelesene, 256 geschriebene Tokens) 695 Tokens pro Sekunde gegenüber 650. Da die vLLM-Version nicht dieselbe ist, stellen wir diese Zahlen als dieselbe Größenordnung und nicht als Vergleich der Maschinen dar. Während dieser Tests wurde keine Anfrage unterbrochen.
Zusammenfassung: Mit llama.cpp und Ollama, zwei lokal häufig genutzten Engines, liefert der ATOM bis auf weniger als 5 % genau dieselbe Leistung wie ein DGX Spark. Die Geschwindigkeit jedes Modells auf diesem Chip finden Sie in unserem ersten Leitfaden der Reihe.
#Was GIGABYTE beiträgt: Gehäuse, Kühlung, Referenzen
Der AI TOP ATOM misst 150 × 150 × 50,5 mm und wiegt 1,2 kg, also etwa einen Liter Volumen: Das ist das Format der Founders Edition. Das Gehäuse ist mattschwarz. Die Front besteht aus Lamellen mit einem Wellenmuster und besitzt weder Anschluss noch Taste: Alles wird an der Rückseite angeschlossen.
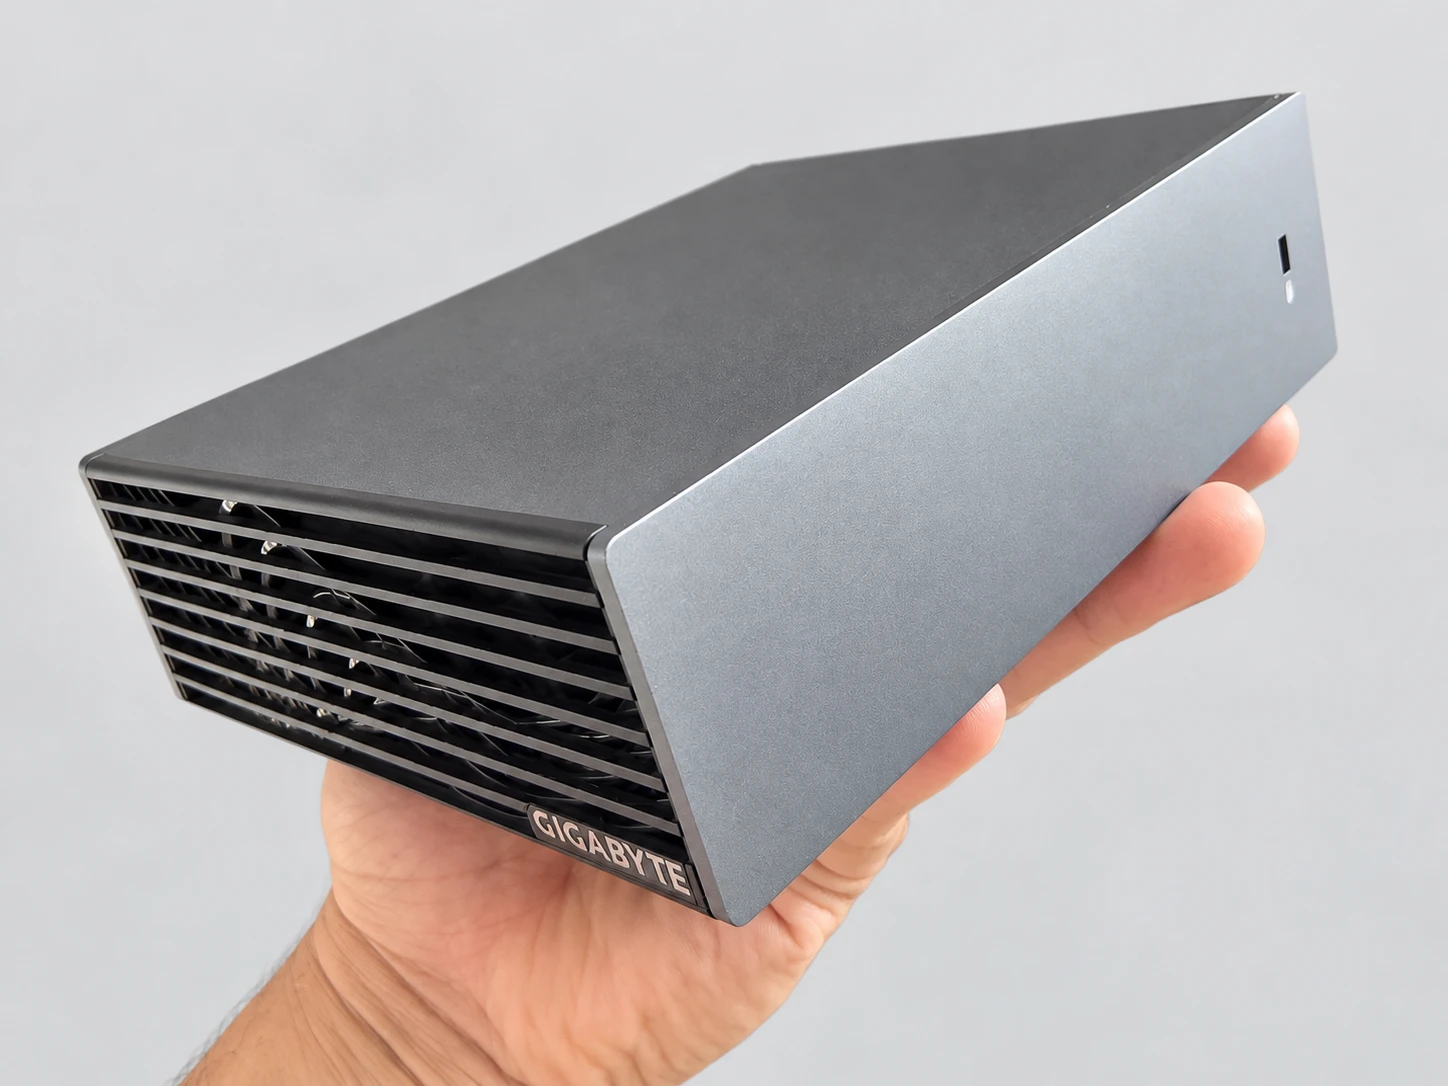
ServeTheHome hat das Gerät geöffnet. Die Website beschreibt einen großen Kühlkörper mit Kupferplatten auf den Chips und Heatpipes, gekühlt von zwei Delta-Lüftern. StorageReview hat im Januar 2026 fünf GB10-Geräte verglichen. Die GIGABYTE erreicht unter Spitzenlast maximal 87 bis 88 °C, ebenso wie die Founders Edition und das Dell-Gerät.
StorageReview zählt sie zu den besten Kühlungsprofilen, mit einem der höchsten GPU-Leistungsniveaus. Nach mehr als einer Stunde Aufheizen findet ServeTheHome den ATOM auf dem Niveau der DGX Spark von NVIDIA, mit einem leichten Vorteil in mehreren seiner KI-Tests.
Peter Falkingham, der seit Juli 2026 eine ATOM für ein universitäres Labor verwendet, beschreibt sie in seinem Test als nahezu lautlos.
#Sechs Varianten, mit einer SSD Ihrer Wahl
Auf der Produktseite von GIGABYTE sind sechs Referenzen aufgeführt, von ATAGB10-9000 bis ATAGB10-9005. Die Tabelle enthält diejenigen, die wir überprüfen konnten.
| Referenz | Speicher | SSD |
|---|---|---|
| ATAGB10-9000 (unser Gerät) | 128 GB | 4 TB mit PCIe 5.0 |
| ATAGB10-9001 | 128 GB | 4 TB mit PCIe 4.0 |
| ATAGB10-9002 | 128 GB | 1 TB über PCIe 4.0 |
| ATAGB10-9003 bis 9005 | 128 GB oder 64 GB | 2 TB oder 1 TB mit PCIe 4.0 (nicht für jede Variante überprüft) |
Bei der 9000 ist die SSD eine Samsung aus der PM9E1-Familie, laut StorageReview dasselbe Modell wie bei der Founders Edition. Es handelt sich um ein M.2-2242-Modul. Laut ServeTheHome ist dies die einzige Komponente, die der Benutzer austauschen kann.
#Stromversorgung, Lieferumfang und Garantie
Der 240-W-Adapter wird an den für die Stromversorgung reservierten USB-C-Anschluss angeschlossen. NVIDIA empfiehlt, die mitgelieferte Stromversorgung zu verwenden, um die optimale Leistung zu erzielen. Die Verpackung enthält die Maschine, den Adapter und das Netzkabel. Ein QSFP-Kabel zum Verbinden zweier Maschinen wird von GIGABYTE separat verkauft: 94,04 € inklusive Mehrwertsteuer im offiziellen AORUS-Shop (Stand: 8. Oktober 2026).
Zur Garantie gibt das GIGABYTE-Handbuch an, dass die Dauer auf der Produktwebsite oder dem Etikett angegeben ist. LDLC kündigt 5 Jahre Garantie auf die 9000 an (Stand: 8. Oktober 2026). Lesen Sie die Garantiedauer vor dem Kauf im Datenblatt des Händlers nach.
#Anschlüsse und Konnektivität
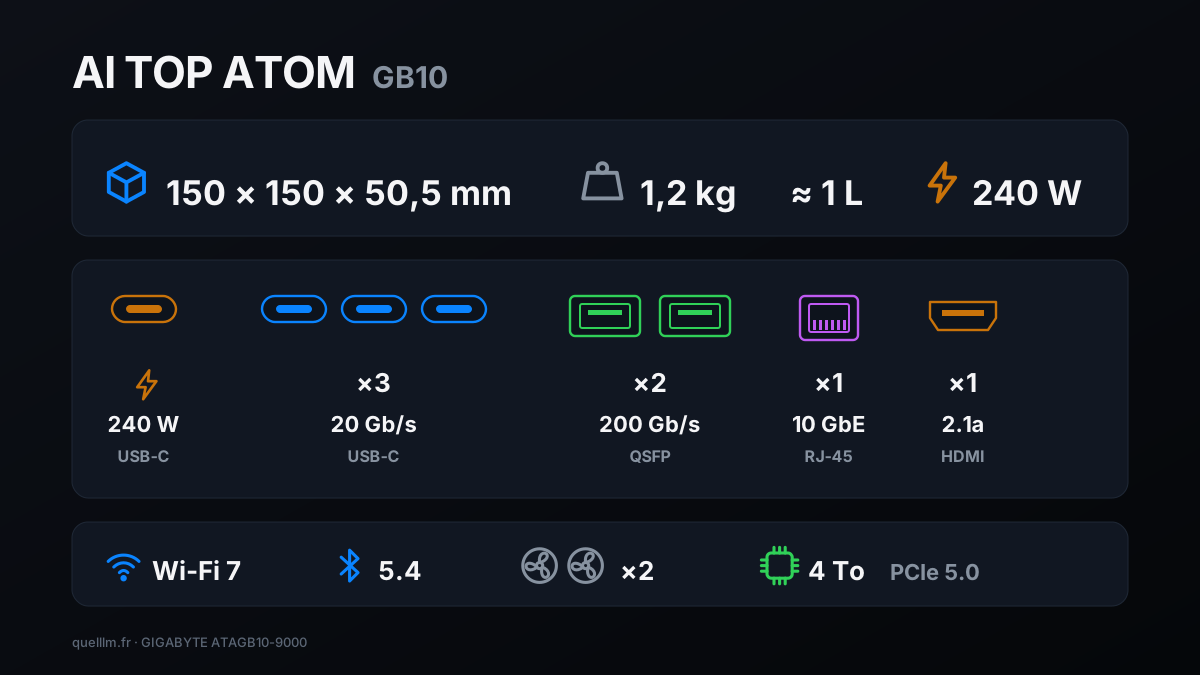
Die Liste übernimmt die Angaben von GIGABYTE, und die Angaben von NVIDIA zur Founders Edition nennen dieselben Anschlüsse. Bei unserem Gerät haben wir das kabelgebundene Netzwerk und die SSD-Verbindung überprüft und das WLAN-Modul identifiziert.
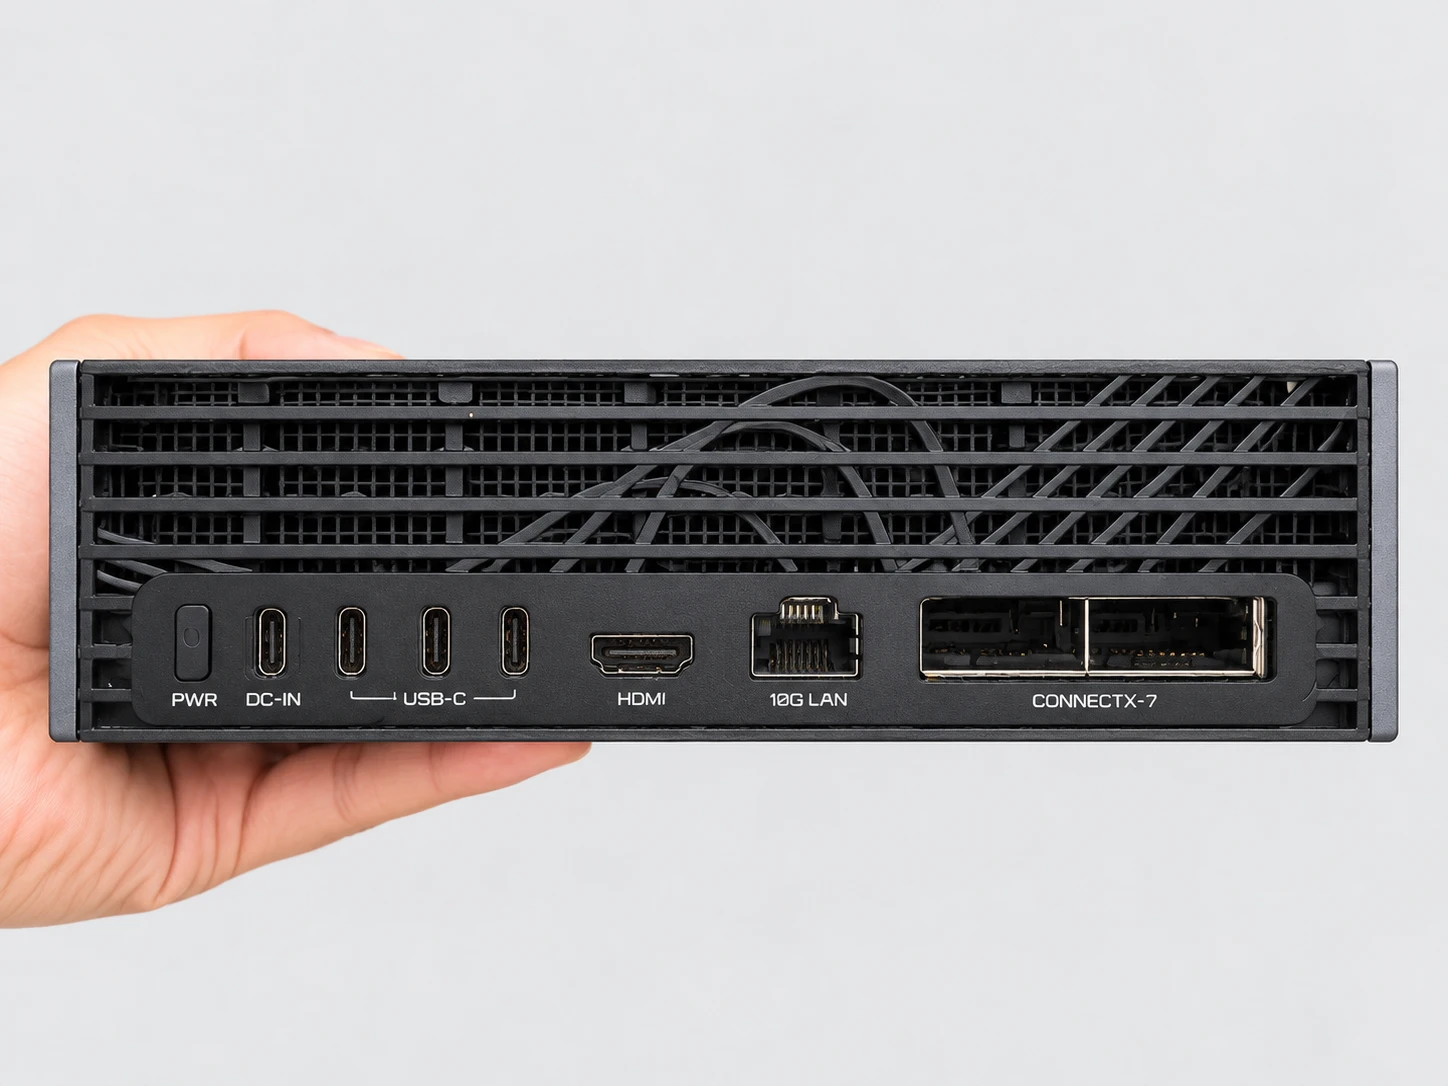
- Stromversorgung
- Ein USB-C-Anschluss ausschließlich für die Stromversorgung, mit dem mitgelieferten 240-W-Adapter.
- USB
- Drei USB-C-Anschlüsse mit 20 Gb/s (USB 3.2 Gen 2x2) für Laufwerke und Zubehör.
- Kabelgebundenes Netzwerk
- Eine RJ-45-Buchse mit 10 GbE. Auf unserem Gerät beträgt die ausgehandelte Verbindung 10 Gb/s.
- Hochgeschwindigkeitsnetzwerk
- Zwei QSFP-Anschlüsse (NVIDIA-ConnectX-7-Karte, 200 Gb/s) zum Verbinden mehrerer Maschinen. Wir haben diese Verbindung nicht getestet.
- Video
- Ein HDMI-2.1a-Ausgang mit Mehrkanalton.
- Kabellos
- Wi-Fi 7 und Bluetooth 5.4. Unser System erkennt einen MediaTek-Chip MT7925.
#Laststabilität: 1 Stunde und 2 Stunden am Stück
Ein kompaktes Gerät muss die Last bewältigen, ohne langsamer zu werden. Eine durch Wärme oder die Leistungsgrenze erzwungene Verlangsamung wird als Drosselung bezeichnet. Wir haben die ATOM mit vLLM 26.09 ohne Pause arbeiten lassen. Jede Sitzung ist in Abschnitte unterteilt: Ein Abschnitt ist ein Stapel von Anfragen, der direkt auf den vorherigen folgt. Währenddessen haben wir jede Sekunde den Takt der GPU, ihre Leistung, ihre Temperatur und die vom Treiber gemeldeten Gründe für die Drosselung aufgezeichnet.
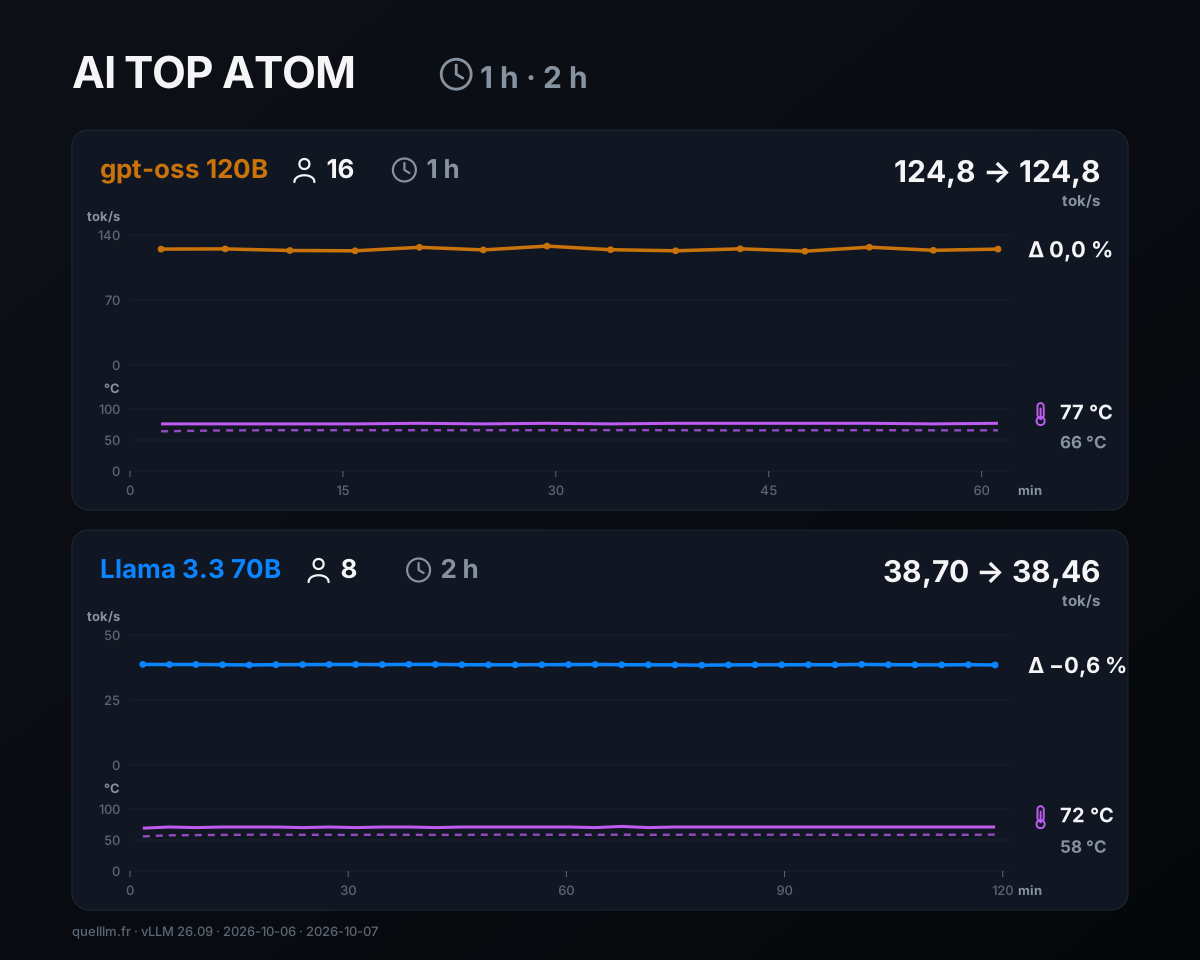
| Sitzung | Anfragen | Durchsatz: erster → letzter Abschnitt | Drift | GPU-Temperatur | Bridage |
|---|---|---|---|---|---|
| 1 h, gpt-oss 120B, 16 Benutzer, 14 Sequenzen | 896, kein Fehler | 124,8 → 124,8 (von 122,6 bis 128,1) | 0,0 % | 77 °C / 66 °C | Keine |
| 2 h, Llama 3.3 70B NVFP4, 8 Nutzer, 33 Abschnitte | 1 056, kein Fehler | 38,70 → 38,46 (von 38,40 bis 38,70) | −0,6 % | 72 °C / 58 °C | Keine |
Eine Stunde lang sendeten 16 Nutzer kontinuierlich Anfragen mit 4 096 Tokens und Antworten mit 512 Tokens. Die 14 Abschnitte mit jeweils 64 Anfragen erzielten einen nahezu identischen Gesamtdurchsatz von 122,6 bis 128,1 Tok/s, und sowohl der erste als auch der letzte erreichten 124,8 Tok/s. Jede Person sah ihre Antwort mit etwa 8 Tok/s geschrieben werden. Der Takt der GPU hatte während dieser Sitzung einen Median von 2 509 MHz.
Zwei Stunden lang arbeiteten 8 Nutzer mit Llama 3.3 70B im NVFP4-Format, einem komprimierten Format von NVIDIA, mit 1 024 gelesenen und 256 geschriebenen Tokens pro Anfrage. Der Gesamtdurchsatz blieb über 33 Abschnitte mit jeweils 32 Anfragen zwischen 38,40 und 38,70 Tok/s.
Die Drift beträgt −0,6 % zwischen dem ersten und dem letzten Abschnitt und −0,2 %, wenn man die Mediane der ersten fünf und der letzten fünf vergleicht. Jede Person sah ihre Antwort mit etwa 5,1 Tok/s geschrieben werden, und das erste Wort kam nach 2,8 s (Median). Der Takt der GPU hatte einen Median von 2 528 MHz.
Der Treiber meldete während der beiden Sitzungen keinen Grund für eine Drosselung: Der erfasste Wert blieb Sekunde für Sekunde bei null. Die GPU erreichte mit 16 Benutzern höchstens 77 °C und mit 8 Benutzern 72 °C. Der wärmste Sensorbereich des Systems erreichte während der ersten Sitzung 87 °C und während der zweiten 80 °C.
Während der zweiten Sitzung erreichte die SSD maximal 49 °C. Die Firmware benennt diese Bereiche nicht; wir ordnen sie daher nicht dem Prozessor zu. Zum Vergleich: StorageReview verzeichnete bei der Founders Edition, dem Dell-System und der GIGABYTE unter Lastspitzen maximal 87 bis 88 °C.
#Im Leerlauf
Nach 20 Minuten im Leerlauf haben wir die Maschine 30 Minuten lang aufgezeichnet. Die GPU verbraucht durchschnittlich 10,4 W (von 10,2 bis 11,0 W) und bleibt zwischen 35 und 36 °C. Der wärmste Bereich der Systemsensoren erreicht höchstens 46 °C, und die SSD bleibt zwischen 34 und 35 °C. Es wurde kein Grund für eine Drosselung gemeldet.
Die angegebene Leistung ist die des GPU, wie von seinen Sensoren erfasst; sie stellt nicht den Gesamtverbrauch des Geräts dar. Die Umgebungstemperatur wurde nicht aufgezeichnet. Die Sitzung von einer Stunde fand am frühen Abend statt und die Sitzung von 2 Stunden nachts, als der Raum wahrscheinlich kühler war.
#Die SSD: 13 GB/s beim Lesen, 1,28 Millionen IOPS
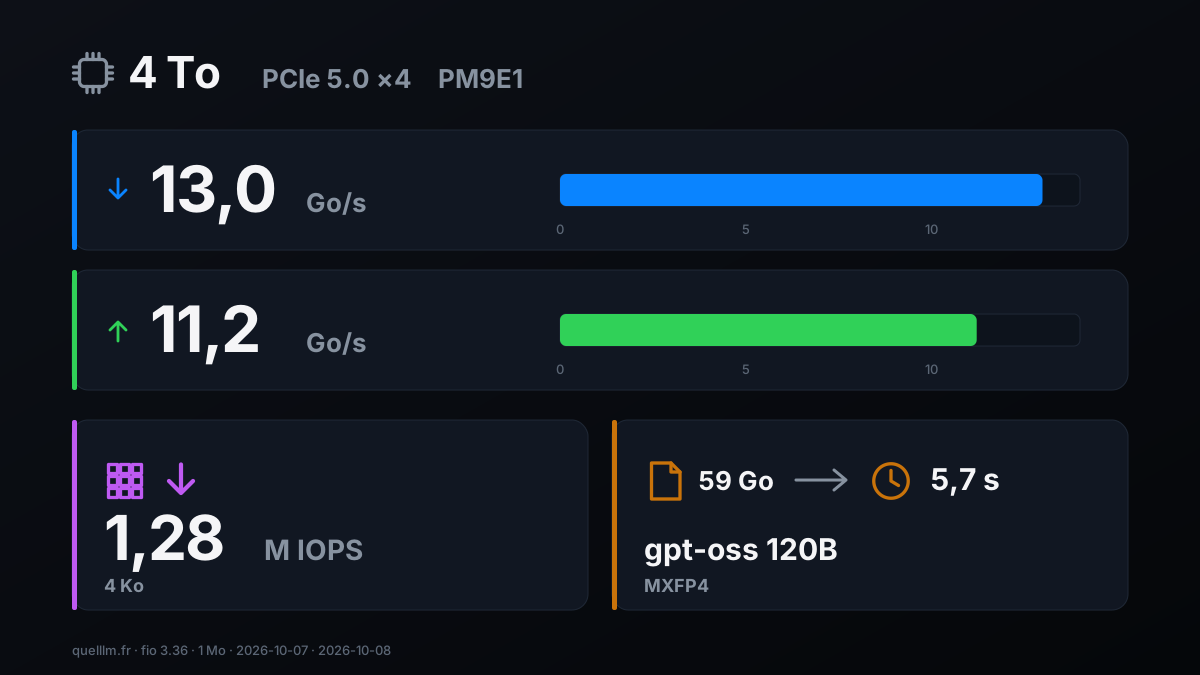
Die Variante 9000 enthält eine Samsung MZALC4T0HBL1-SSD mit 4 TB aus der PM9E1-Familie. Das System bestätigt eine PCIe-5.0-Verbindung: 32 GT/s auf 4 Leitungen. PCIe ist die Verbindung zwischen SSD und Chip; Version 5.0 ist doppelt so schnell wie 4.0.
Wir haben dies mit fio 3.36 auf einer 64-GB-Datei gemessen, die vor dem Lesen vollständig beschrieben wurde, mit direktem Zugriff, also ohne den Systemcache zu verwenden. Die IOPS geben die Anzahl der Lese- oder Schreibvorgänge pro Sekunde an.
| Test | Ergebnis |
|---|---|
| Sequentielles Lesen, Blöcke von 1 MB, 1 Aufgabe | 13,0 GB/s (12,99 mit io_uring, 13,37 mit libaio, zwei Methoden für den Zugriff auf die Linux-Festplatte) |
| Zufälliges Lesen, 4-KB-Blöcke, 4 Aufgaben | 1,28 Millionen IOPS mit io_uring, 1,19 Millionen mit libaio (etwa 4,9 GB/s mit io_uring) |
| Sequenzielles Burst-Schreiben, 1-MB-Blöcke, neue 32-GB-Datei, Laufwerk im Leerlauf | 11,2 GB/s |
| Datei von gpt-oss 120B wird gelesen (59 GB) | 5,7 s |
StorageReview veröffentlichte mit einem anderen Tool (gdsio) und demselben SSD-Modell 11,0 bis 11,6 GB/s beim Lesen und 12,2 GB/s beim Schreiben. Unsere Werte liegen in derselben Größenordnung, beim Lesen etwas höher. In der Praxis wird ein großes Modell in wenigen Sekunden geladen: Die Datei von gpt-oss 120B mit 59 GB wurde in 5,7 s gelesen.
Bei der 9000 finden Sie die 4-TB-SSD der Founders Edition wieder: Es handelt sich um dasselbe Modell, sie unterscheidet den ATOM daher nicht von der Referenz NVIDIA. Zwischen den GIGABYTE-Referenzen besteht jedoch ein Unterschied: Die 9000 hat eine SSD mit PCIe 5.0, die 9001 und 9002 eine mit PCIe 4.0. Die SSD-Messungen beziehen sich auf die Referenz 9000.
#64 oder 128 GB?
Am 2. Oktober 2026 kündigte NVIDIA einen DGX Spark mit 64 GB für Modelle mit bis zu 100 Milliarden Parametern an, der ab dem 23. Oktober bei Acer, ASUS, Dell, GIGABYTE, HP und MSI ab 4 999 Dollar erhältlich sein sollte. GIGABYTE bestätigte am 5. Oktober eine AI TOP ATOM mit 64 GB im selben Design. Die Verfügbarkeit in Frankreich ist derzeit nicht bestätigt. Wir haben sie nicht gemessen.
Unsere Messwerte aus dem ersten Leitfaden der Reihe ermöglichen eine Berechnung. Die Modelle bis Qwen3-Coder 30B-A3B belegen mit 32 768 Kontext-Tokens weniger als 35 GB und würden in 64 GB passen. Llama 3.3 70B (51 GB) läge an der Grenze. gpt-oss 120B (62 GB) und größere Modelle würden nicht hineinpassen. Bei gleicher Bandbreite, was noch zu überprüfen ist, sollten die Geschwindigkeiten ähnlich sein.
Um ein Modell mit mehr als 100 Milliarden Parametern auf einem einzigen Gerät auszuführen, ist die Version mit 128 GB erforderlich. Die sechs Referenzen auf der GIGABYTE-Seite ermöglichen die Auswahl von Arbeitsspeicher und SSD.
#Preis je Referenz (erfasst am 8. Oktober 2026)
Die GB10-Preise ändern sich jede Woche: Prüfen Sie sie vor dem Kauf. Das haben wir am 8. Oktober 2026 in Frankreich inklusive Mehrwertsteuer festgestellt. Vergleichen Sie stets dieselbe Referenz: Die 9001 (PCIe 4.0) und die 9000 (PCIe 5.0) sind nicht dieselbe Maschine.
| Marchand | Referenz | Preis inklusive Mehrwertsteuer | Angezeigte Verfügbarkeit |
|---|---|---|---|
| Offizieller AORUS-Shop | 9001 (4 TB mit PCIe 4.0) | 6 346,27 € | Ausverkauft |
| Amazon.fr, verkauft von Amazon UK | 9001 (4 TB mit PCIe 4.0) | Variabler Preis, auf Amazon.fr nachzulesen | 1 Exemplar |
| LDLC | 9000 (4 TB mit PCIe 5.0) | 7 999,95 € | Rupture |
| Rue du Commerce, Drittanbieter | 9000 (4 TB mit PCIe 5.0) | Ab 7.999,95 € (3 Angebote) | Je nach Händler |
| Senetic.fr | 9000 (4 TB mit PCIe 5.0) | 9 022,08 € | 5 Einheiten |
Materiel.net zeigte für die 9000 denselben Preis wie LDLC, ebenfalls nicht lieferbar. Zum Vergleich: Am selben Tag wurde die MSI EdgeXpert, eine weitere GB10-Maschine, bei Materiel.net für 6.599,95 € angezeigt und war ebenfalls nicht lieferbar; die DGX Spark von PNY wurde dort nicht mehr angeboten, ebenso wenig bei LDLC. Ein angezeigter Preis für eine nicht verfügbare Maschine ist kein Kaufpreis: Achten Sie auch auf die Verfügbarkeit.
#Was wir nicht gemessen haben
- Der Vergleich mit dem DGX Spark
- Der Vergleich stützt sich auf die für den DGX Spark veröffentlichten Messungen, die auf dem ATOM mit den angegebenen Softwareversionen wiederholt wurden.
- Das Geräusch
- Die auf dieser Seite zitierte Einschätzung der Lautstärke stammt aus dem Test von Peter Falkingham.
- Der Verbrauch des gesamten Geräts
- Die Leistungsangaben auf dieser Seite beziehen sich ausschließlich auf die GPU. Ein kommender Leitfaden der Reihe behandelt den Verbrauch.
- Die Raumtemperatur
- Die veröffentlichten Temperaturen stammen von den in die Maschine integrierten Sensoren.
- Die Verbindung zwischen zwei Geräten
- Die beiden QSFP-Anschlüsse (200 Gb/s) wurden nicht getestet.
- Die anderen Referenzen und die 64-GB-Version
- Die Messungen beziehen sich auf das Referenzmodell ATAGB10-9000 mit 128 GB.
Diese Seite wird aktualisiert, wenn eine neue Version von DGX OS, der Firmware oder unseren Tools diese Ergebnisse verändert; jede Korrektur wird datiert.
#Für wen die AI TOP ATOM die richtige Wahl ist
Das Folgende stammt aus unseren Messungen des Modells 9000 und unseren Preisaufnahmen vom 8. Oktober 2026.
- Sie möchten die Referenzleistung des GB10 in einem eleganten Gehäuse
- Die 9000 erreicht bis auf höchstens 4,3 % die für den DGX Spark veröffentlichten Geschwindigkeiten, mit einer 4-TB-SSD über PCIe 5.0, die mit 13 GB/s beim Lesen gemessen wurde.
- … Sie das Gerät auf Ihrem Schreibtisch behalten
- Sie passt in einen Liter, wiegt 1,2 kg und hat eine klare Front. Im Leerlauf verbraucht die GPU etwa 10 W.
- … Sie bedienen ein Team oder KI-Agenten
- Eine Stunde mit 16 Nutzern auf gpt-oss 120B, anschließend zwei Stunden mit 8 Nutzern auf Llama 3.3 70B: Die Geschwindigkeit blieb stabil (Drift von 0,0 % und −0,6 %), ohne jegliche Drosselung.
- … Sie möchten weniger bezahlen, ohne den Chip zu wechseln
- Die 9001 mit einer 4-TB-SSD über PCIe 4.0 wurde am 8. Oktober 2026 im offiziellen AORUS-Shop für 6.346,27 € als ausverkauft angezeigt und war auf Amazon.fr auf Lager. Sie hat denselben Chip und dieselben 128 GB; die Erhebungen auf dieser Seite beziehen sich auf das Modell 9000.
- … Ihre Modelle belegen mit ihrem Kontext weniger als 35 GB
- Die für den 23. Oktober 2026 angekündigte Version mit 64 GB sollte ausreichen (Berechnung aus unserem ersten Leitfaden, für diese Version nicht gemessen). Warten Sie auf ihre Verfügbarkeit und ihren Preis.
- … Sie mehrere Geräte verbinden möchten
- Die beiden QSFP-Anschlüsse (200 Gb/s) sind für diesen Zweck vorgesehen. GIGABYTE verkauft das Kabel separat.
#FAQ
Ist die AI TOP ATOM genauso schnell wie ein DGX Spark von NVIDIA?+
Was ändert sich konkret zwischen einer ATOM und einer Founders Edition?+
Wird die AI TOP ATOM langsamer, wenn sie lange arbeitet?+
Welche Referenz sollten Sie wählen: 9000, 9001 oder 9002?+
Sollten Sie auf die 64-GB-Version warten?+
Haben Sie Feedback, einen Fehler entdeckt oder möchten Sie etwas präzisieren? Geben Sie uns Bescheid – so wird der Guide für alle besser.