Lokales Fine-Tuning auf GB10: Messwerte und Methode
Auf einem GIGABYTE AI TOP ATOM (Chip NVIDIA GB10, 128 GB) kann ein kleines, für eine bestimmte Aufgabe trainiertes Modell ein sehr großes Modell bei dieser Aufgabe übertreffen. Nach 85 Minuten LoRA extrahiert Qwen3-8B die Daten aus 95 % von 200 fiktiven, zuvor nie gesehenen Rechnungen ohne jeden Fehler, gegenüber 62,5 % bei gpt-oss 120B und 26 % ohne Training. Auch das QLoRA mit Unsloth passt in den Speicher: 41 GB für ein 70B, 64 GB für gpt-oss 120B. Das Training hat auf GPU-Seite 1,5 Cent Strom gekostet.
Beim Fine-Tuning wird ein vorhandenes Modell weitertrainiert, damit es eine bestimmte Aufgabe zuverlässig löst. Mit 128 GB Unified Memory erledigt ein GB10-Rechner das bei Ihnen vor Ort, ohne dass Sie einen Server mieten oder Ihre Daten einem Onlinedienst anvertrauen müssen. Dieser Leitfaden begleitet einen vollständigen Anwendungsfall, gemessen auf einem AI TOP ATOM, den GIGABYTE kostenlos zur Verfügung gestellt hat: Rechnungsdaten als JSON extrahieren. Außerdem enthält er die Messwerte für QLoRA (dieselbe Methode mit einem auf 4 Bit komprimierten Modell) mit Unsloth bis hin zu gpt-oss 120B sowie die Befehle unserer Versuche.
#Der reale Fall: Rechnungen lesen und JSON erzeugen
Die Aufgabe ist in einem kleinen Unternehmen alltäglich: Aus dem Text einer Rechnung, eines Angebots oder einer Gutschrift soll das Modell ein JSON zurückgeben, also einen strukturierten Datensatz, den eine Software lesen kann. Dieser Datensatz umfasst 31 bewertete Felder: Dokumenttyp, Nummer, Datumsangaben, Aussteller, Kunde, Produktzeilen, Rabatt, Summen, MwSt., Anzahlung, IBAN. Wir haben diese Aufgabe gewählt, weil sich die Antwort Feld für Feld überprüfen lässt, ohne dass ein anderes Modell urteilen muss.
Die Dokumente sind fiktiv. Ein kleines Programm hat 12 Layouts erzeugt, also 12 Rechnungsformen, mit erfundenen Firmennamen. Sein Zufall wird durch einen festen „Seed“ gesteuert: Bei jeder Ausführung erzeugt es wieder dieselben Dokumente. Das Training verwendet 2 000 Dokumente mit 10 Layouts.
Die Evaluierung verwendet 200 nie gesehene Dokumente: 100 mit denselben 10 Layouts und 100 mit 2 Layouts, die im Training nicht vorkommen. Diese letzten 100 zeigen, ob das Modell die Aufgabe verstanden oder sich nur Formen gemerkt hat.
Das Modell erhält den Text des Dokuments, weder ein Bild noch eine PDF-Datei. Hier sehen Sie einen Auszug aus der Antwort des trainierten Modells auf das erste Testdokument, eine fiktive Gutschrift mit vier Positionen.
#Die Methode: LoRA, eine Epoche, 85 Minuten
Profitiere von unserer Erfahrung und einem geführten Lernpfad, um deinen lokalen Assistenten zu erstellen und deine KI im Alltag zu nutzen.
- Lebenslanger Online-Zugang
- PDF + Dateien
- Erstattung binnen 30 Tagen
Der Rechner ist ein GIGABYTE AI TOP ATOM, Modellnummer ATAGB10-9000: Chip NVIDIA GB10, 128 GB Unified Memory, 4-TB-SSD mit PCIe 5.0, unter DGX OS 7.5.0 (Treiber 580.159.03, CUDA 13.0). Die Software: der PyTorch-Container von NVIDIA (Version 26.03, mit PyTorch 2.11), PEFT 0.21.2 für LoRA, Unsloth 2026.10.1 für QLoRA und für die Bereitstellung der vLLM-Container 26.09 von NVIDIA (vLLM 0.29.0). Unser erster Leitfaden der Reihe beschreibt den Rechner und die Geschwindigkeit von 13 Modellen im Detail.
LoRA (Low-Rank Adaptation) lässt das ursprüngliche Modell unverändert und trainiert kleine Matrizen, die seinen Schichten hinzugefügt werden. Das Ergebnis ist ein Adapter, eine kleine Datei, die zusammen mit dem Modell geladen wird. Hier werden 43,6 Millionen Parameter trainiert, gegenüber 8 Milliarden bei Qwen3-8B.
Drei Begriffe tauchen in diesem Leitfaden immer wieder auf. Ein Trainingsschritt verarbeitet einen Batch von 4 Dokumenten. Eine Epoche ist ein vollständiger Durchlauf über die 2.000 Dokumente. Der Loss misst die Abweichung zwischen der vom Modell geschriebenen und der erwarteten Antwort: Je niedriger er ist, desto besser.
- Modell
- Qwen3-8B in bf16, einem 16-Bit-Zahlenformat, ohne Komprimierung.
- LoRA
- Rang 16, Alpha 32 (ein Skalierungsfaktor), Dropout 0,05 (bei jedem Schritt wird ein kleiner Teil der Werte zufällig ignoriert, um Overfitting zu begrenzen), auf den 7 Projektionen jeder Schicht, also ihren 7 Gewichtsmatrizen: q, k, v, o, gate, up, down. Der Rang legt die Größe der hinzugefügten Matrizen fest.
- Dauer
- 1 Epoche: 500 Schritte mit je 4 Dokumenten.
- Lernrate
- 1e-4, also 0,0001, mit schrittweisem Anstieg über 30 Schritte und anschließendem Kosinus-Abfall.
- Lots
- Wir sortieren die 2 000 Dokumente nach Länge, bilden die Batches und mischen dann deren Reihenfolge mit einem festen Seed. Ein Batch enthält Dokumente ähnlicher Länge: Es gibt weniger unnötiges Padding, sodass das Training schneller läuft.
- Perte
- Nur anhand der JSON-Antwort berechnet. Prompt und Dokument sind maskiert: Das Modell lernt, die Antwort zu schreiben, nicht das Dokument abzuschreiben.
- Länge
- Bis zu 2.304 Tokens. Das längste Dokument umfasst 2.204, der Durchschnitt liegt bei 1.143: Keines wird abgeschnitten.
- Speicher
- Gradient Checkpointing ist aktiv: Das Modell berechnet bestimmte Ergebnisse neu, statt alle im Speicher zu halten.
Diese Einstellungen wurden in einem Nachtrag zu unserem Protokoll vom 7. Oktober 2026 festgelegt, vor jeder Bewertung anhand der 200 Testdokumente. Das Protokoll wurde vor der ersten Messung festgeschrieben; die Methode, die datierte Liste der Nachträge und die Daten unserer Tabellen sind auf unserer Methodenseite veröffentlicht. Die Speicherangaben in diesem Leitfaden erfolgen in GB, wie Linux sie anzeigt: 1 GB = 1.024 MB.
Alles läuft im PyTorch-Container von NVIDIA (Version 26.03). Darin erhält eine Python-Umgebung die Bibliotheken transformers und PEFT. Die unten stehenden Pfade sind vereinfacht; die Optionen entsprechen denen unserer Tests.
#Die Ergebnisse: 95 % perfekte Dokumente
Die Bewertung vergleicht Feld für Feld den vom Modell geschriebenen Wert nach einer Normalisierung mit dem erwarteten Wert. Ein Dokument gilt als „perfekt“, wenn alle seine Felder exakt sind. Die drei Modelle erhalten dieselbe Anweisung, bei Temperatur 0 (der Einstellung, die die Antworten am stabilsten macht), über vLLM 26.09, mit 16 Dokumenten gleichzeitig. Bei Qwen3-8B ist der Denkmodus deaktiviert. Bei gpt-oss 120B ist der Reasoning-Aufwand auf „niedrig“ eingestellt.
| Modell | Exakte Felder | Perfekte Dokumente | Perfekt, bekannte Layouts | Perfekt, neue Layouts | Dauer für 200 Dokumente |
|---|---|---|---|---|---|
| Qwen3-8B ohne Training | 84,8 % | 26,0 % | 27 % | 25 % | 686 s |
| gpt-oss 120B ohne Training | 97,5 % | 62,5 % | 58 % | 67 % | 991 s |
| Qwen3-8B + LoRA (85 min) | 99,2 % | 95,0 % | 96 % | 94 % | 524 s |
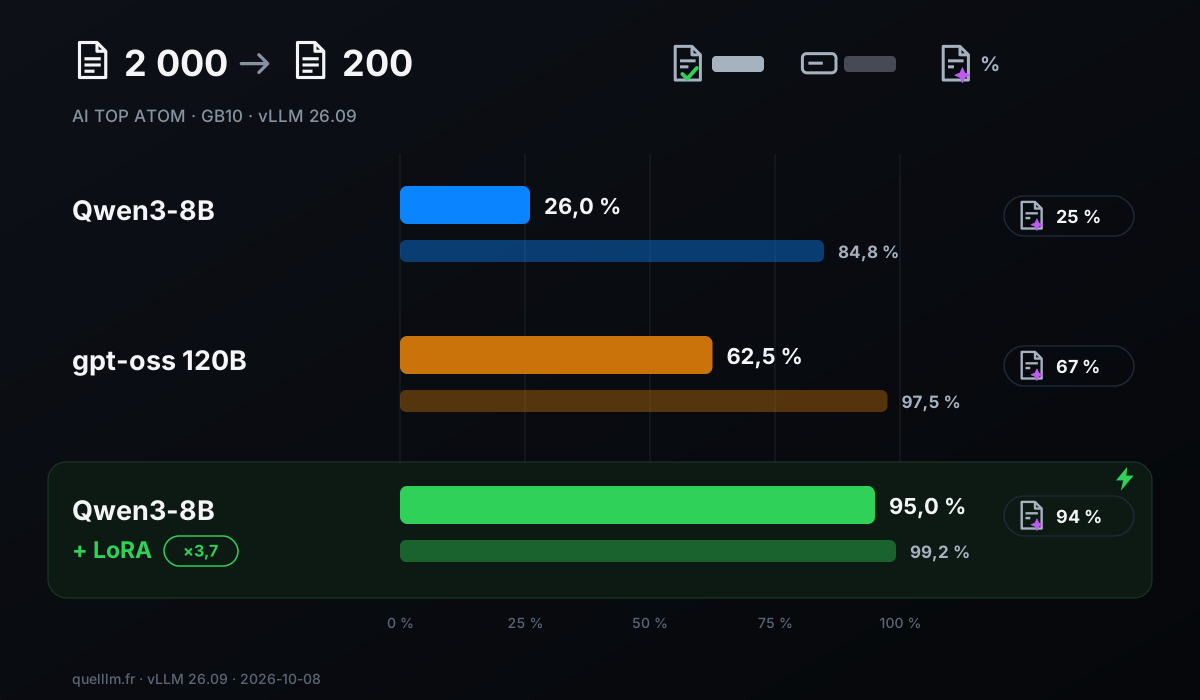
Das trainierte Modell erreicht 95,0 % perfekte Dokumente, gegenüber 26,0 % beim selben Modell ohne Training: 69 Punkte mehr, also 3,7-mal so viele fehlerfreie Dokumente. Es übertrifft gpt-oss 120B (62,5 %), ein Modell mit 117 Milliarden Parametern. Es ist auch das schnellste: 524 Sekunden für die 200 Dokumente, gegenüber 991 Sekunden für gpt-oss 120B und 686 Sekunden für Qwen3-8B ohne Training. Auch seine Antworten sind kürzer: 98 847 geschriebene Tokens gegenüber 160 702 bei gpt-oss 120B.
Bei den 100 Dokumenten mit nie gesehenen Layouts erreicht das trainierte Modell weiterhin 94 % perfekte Dokumente und 98,5 % exakte Felder, gegenüber 96 % und 99,9 % bei bekannten Layouts. Der Abstand beträgt bei den perfekten Dokumenten 2 Punkte (96 % gegenüber 94 %): Der Adapter beschränkt sich nicht auf die im Training gesehenen Formen.
Die Aufschlüsselung nach Feldern zeigt, was das Training korrigiert hat. Alle 31 Felder sind in mindestens 97,5 % der Dokumente korrekt, 18 davon in 100 % der Dokumente. Ohne Training sind 10 Felder in 49,5 % bis 61,5 % der Fälle korrekt: die Beträge (Rabatt, Summen, MwSt., Anzahlung, Zahlbetrag) und die Positionen (Menge, Einzelpreis, MwSt.-Satz, Betrag). Nach dem Training sind diese 10 Felder zu 98 % bis 100 % korrekt.
Die drei Modelle liefern in 100 % der Fälle gültiges JSON und finden in 100 % der Dokumente die richtige Zeilenanzahl. Der Unterschied liegt also in den Feldwerten, nicht in der Form der Antwort.
#Was es kostet: Zeit, Speicher, Strom
| Messung | Wert |
|---|---|
| Dauer des Trainings | 5.090 s, also 85 min (10,2 s pro Schritt) |
| Von PyTorch gemessene GPU-Speicherspitze | 33,3 GB |
| GPU-Leistung, Durchschnitt und Spitze | 53,0 W und 62,7 W |
| GPU-Temperatur, Durchschnitt und Maximum | 65 °C und 77 °C |
| Von der GPU gemeldete Drosselung | keiner der 5 206 Messwerte |
| GPU-Energie für das Training (87 Minuten Messung, einschließlich Laden) | 76,7 Wh |
| Kosten zum EDF-Tarif Tarif Bleu Base (20,01 Cent pro kWh inkl. Steuern) | 1,5 Cent |
| GPU-Energie zum Lesen der 200 Testdokumente mit dem trainierten Modell | etwa 6 Wh |
Diese Zahlen betreffen nur die GPU, wie sie der Chip selbst meldet. Laut NVIDIA ist die von nvidia-smi angezeigte Leistung die der GPU allein. Prozessor, Speicher, SSD und Netzteil sind nicht eingerechnet. Der Tarif entspricht der Option Base von EDF für 6 kVA gemäß der ab dem 1. August 2026 geltenden Preisliste; die Grundgebühr ist nicht eingerechnet.
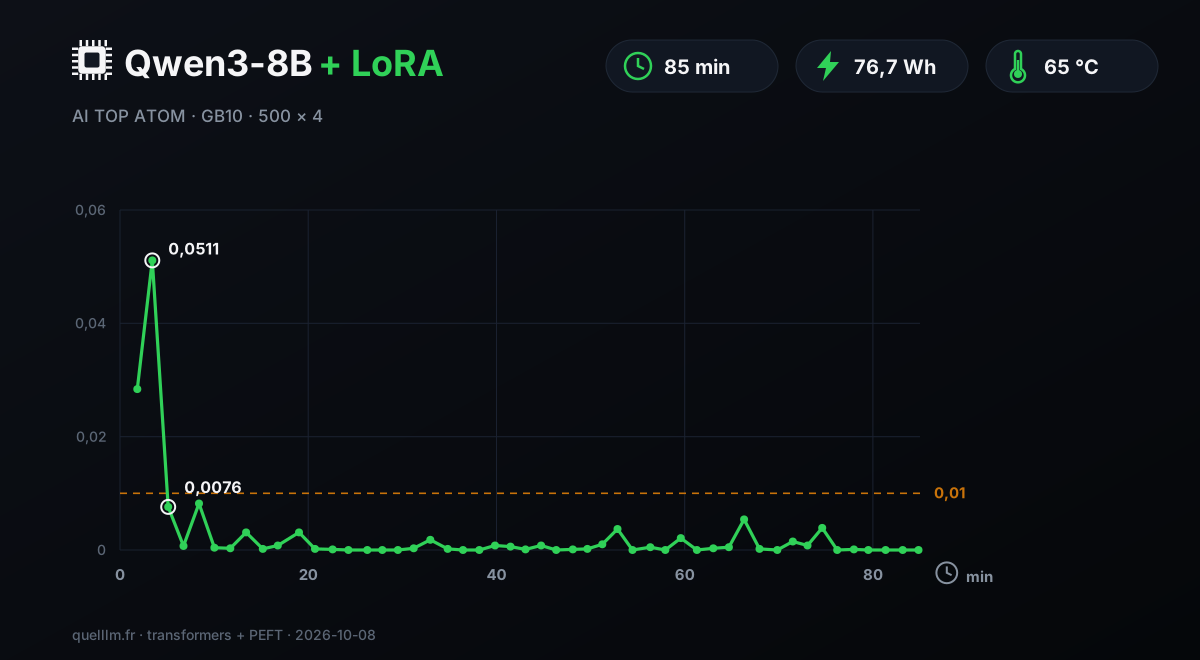
Jeder Punkt der Kurve stammt aus einem einzigen Batch mit 4 Dokumenten: Die Werte schwanken daher von Messung zu Messung. Der Loss fällt ab Schritt 30, nach 5 Minuten Training, unter 0,01, und keine spätere Messung liegt über 0,0082. Eine einzige Epoche reichte in diesem Fall aus, um 95 % perfekte Dokumente zu erreichen.
#QLoRA mit Unsloth: ein 70B und gpt-oss 120B auf demselben Rechner
QLoRA komprimiert die Modellgewichte auf 4 Bit, was den Speicherbedarf des Modells stark verringert, und trainiert darauf einen LoRA-Adapter. So lässt sich ein großes Modell spezialisieren, ohne den Rechner zu wechseln. Wir haben Unsloth verwendet, ein freies Tool, das laut seinem Herausgeber das Fine-Tuning schlanker und schneller macht.
NVIDIA veröffentlicht einen offiziellen Leitfaden für Unsloth auf DGX Spark in einem PyTorch-Container von NVIDIA (Version 25.11) und bietet außerdem eine offizielle PyTorch-Umgebung für das Fine-Tuning von Modellen mit 1 bis 70 Milliarden Parametern. Unsloth gibt für ein 4-Bit-QLoRA von gpt-oss 120B etwa 68 GB Speicher an; unsere Messung ergibt einen Spitzenwert von 64,4 GB, also dieselbe Größenordnung.
Wir haben Geschwindigkeit und Speicher bei zwei Modellen gemessen: Llama 3.3 70B und gpt-oss 120B, beide im von Unsloth veröffentlichten 4-Bit-Format. Jeder Durchlauf umfasst 40 Schritte, und die ersten 10, die dem Anlaufen dienen, fließen nicht in den Durchschnitt ein.
Die Sequenzen umfassen 1.024 Tokens, bei einer Batch-Größe von 1 und einem LoRA mit Rang 16. Diese Schritte, ausgeführt mit dem Referenztext unseres Protokolls, messen Durchsatz und Speicher; sie erzeugen kein brauchbares Modell.
| Modell | Chargement | Speicher des Modells | GPU-Speicherspitze | Sekunden pro Schritt | Tokens pro Sekunde | Trainierte Parameter |
|---|---|---|---|---|---|---|
| Llama 3.3 70B (4-Bit-QLoRA) | 247 s | 37,6 GB | 41,3 GB | 9,39 | 109 | 207 Millionen (7 Projektionen) |
| gpt-oss 120B (4-Bit-QLoRA) | 397 s | 58,5 GB | 64,4 GB | 6,35 | 161 | 11,9 Millionen (4 Attention-Projektionen) |
| Qwen3-8B (LoRA bf16) | — | — | 63,4 GB | 5,42 | 756 | 43,6 Millionen (7 Projektionen) |
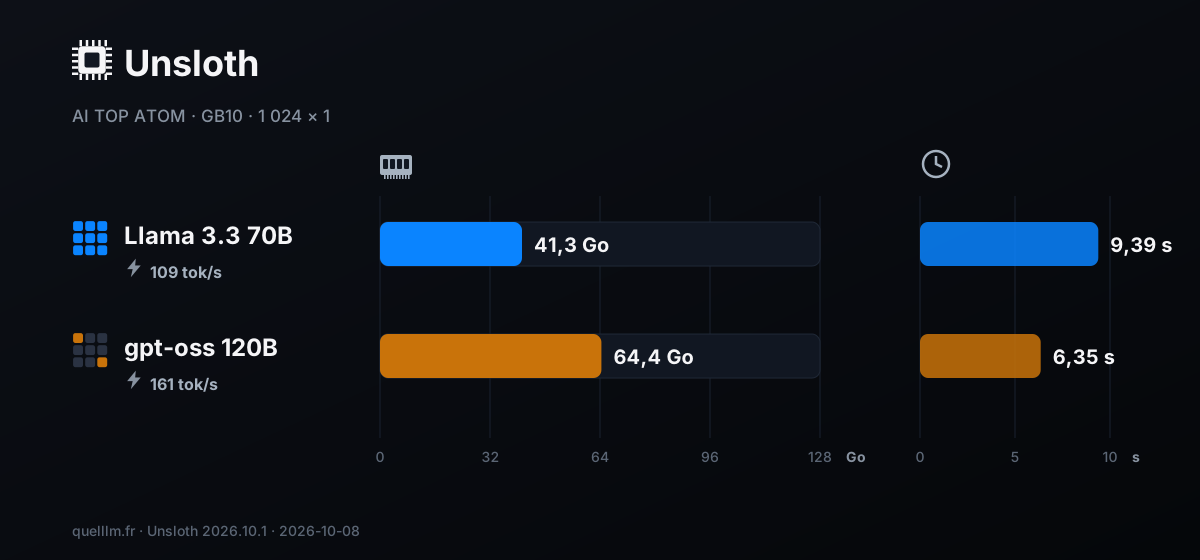
Das 70B trainiert mit einem Spitzenwert von 41,3 GB, etwa einem Drittel der 121,7 GB, die das System sieht; gpt-oss 120B benötigt 64,4 GB. In beiden Fällen bleibt Platz für andere Dienste. Bemerkenswert: gpt-oss 120B kommt pro Schritt schneller voran als das 70B (6,35 s gegenüber 9,39 s), obwohl es größer ist.
Es ist ein MoE-Modell, eine „Mischung aus Experten“: Pro Token nutzt es nur 5,1 seiner 117 Milliarden Parameter. Wir trainieren darin nur die 4 Attention-Matrizen (q, k, v, o), also 11,9 Millionen Parameter. Das 70B erhält ein LoRA auf seinen 7 Projektionen, also 207 Millionen trainierte Parameter.
Zur Planung hier eine Berechnung auf Grundlage unserer Messungen. 1 000 Schritte mit 1 024 Tokens, also rund eine Million Tokens, würden mit dem 70B 2 h 36 min und mit gpt-oss 120B 1 h 46 min dauern. Überprüfen Sie diese Zeiten anhand Ihres Datensatzes. Das QLoRA des 70B belegte die GPU 10,8 Minuten, einschließlich des Ladens des Modells, bei 8,9 Wh auf GPU-Seite.
Unsloth 2026.10.1 ist in derselben Python-Umgebung wie oben installiert, im selben PyTorch-Container. Für die schrittweise Installation folgen Sie der offiziellen Anleitung von NVIDIA und der Dokumentation von Unsloth, die am Ende der Seite verlinkt sind.
#Das trainierte Modell mit vLLM bereitstellen
vLLM ist ein freier Server, der darauf ausgelegt ist, mehrere Personen gleichzeitig zu bedienen; wir nutzen ihn in dem von NVIDIA bereitgestellten Container. Er lädt das Originalmodell und fügt anschließend den Adapter hinzu. Die API stellt dann zwei Namen bereit: Qwen3-8B, ohne Adapter, und factures, mit Adapter. Wir haben beide auf demselben Server evaluiert, was den Vergleich fair macht.
Bei 16 gleichzeitig gesendeten Dokumenten sind die 200 Rechnungen in 524 Sekunden verarbeitet. In diesem Tempo dauern 1.000 Rechnungen etwa 44 Minuten: Das ist eine Berechnung auf Basis unserer Messung. Der Port ist an die lokale Adresse 127.0.0.1 gebunden. Um den Dienst für Ihr Netzwerk zu öffnen, fügen Sie einen API-Schlüssel hinzu; der Leitfaden zu vLLM in der Produktion beschreibt diesen Schritt im Detail.
#Diesen Fall bei Ihnen in fünf Schritten nachstellen
- 01Bereiten Sie die Beispiele vorStellen Sie Paare zusammen: den Text eines Dokuments und die erwartete JSON-Antwort. Schreiben Sie einen einzigen Prompt, denselben für Training und Evaluierung. Wir haben 2.000 Beispiele verwendet; einen Mindestwert haben wir nicht gemessen.
- 02Halten Sie einen Testdatensatz zurückLegen Sie Dokumente beiseite, die Sie dem Modell nie zeigen. Ergänzen Sie einige Layouts, die im Training nicht vorkommen, um herauszufinden, ob das Modell generalisiert.
- 03Trainieren Sie eine EpocheSortieren Sie die Beispiele nach Länge, bilden Sie die Batches, berechnen Sie den Loss nur für die Antwort und beobachten Sie die Loss-Kurve.
- 04Bewerten Sie vorher und nachherBewerten Sie das Ausgangsmodell und das trainierte Modell mit demselben Prompt, Feld für Feld. Bewerten Sie auch ein großes Modell ohne Training: Das ist der nützlichste Vergleich.
- 05Stellen Sie das Modell mit vLLM bereitLaden Sie den Adapter mit der Option enable-lora und binden Sie Ihre Software an die API an.
#Fine-Tuning, RAG oder ein besserer Prompt: Was sollten Sie wählen?
Beginnen Sie mit dem Prompt: Das ist kostenlos und sofort möglich. Wenn das Modell Fakten in Ihren Dokumenten wiederfinden soll, eignet sich ein RAG besser: ein Assistent, der zuerst in Ihren Dateien sucht, bevor er antwortet.
Fine-Tuning ist das richtige Werkzeug, wenn sich die Aufgabe wiederholt, das Ausgabeformat stabil bleiben muss und Sie über Beispiele verfügen. Das Auslesen von Rechnungen erfüllt diese drei Bedingungen. Die beiden Ansätze lassen sich auf derselben Maschine kombinieren; ein anderer Leitfaden der Reihe zeigt einen vollständigen RAG-Assistenten.
#Die Grenzen unserer Messungen
- Fiktive Dokumente
- Unsere Rechnungen werden von einem Skript mit 12 Layouts erzeugt. Echte, gescannte oder fotografierte Dokumente erfordern zunächst eine Texterkennung (OCR) und können zu anderen Ergebnissen führen.
- Ein einziger Trainingslauf
- Wir haben einen einzigen Adapter trainiert und jedes Modell einmal bei Temperatur 0 bewertet. Weder die Schwankung zwischen einzelnen Trainingsläufen haben wir gemessen noch einen Vergleich mit einem längeren Training angestellt.
- gpt-oss 120B
- Es wird mit niedrigem Reasoning-Aufwand bewertet. Eine andere Einstellung kann seine Punktzahl verändern.
- QLoRA
- Die QLoRA-Messungen beziehen sich auf Geschwindigkeit und Speicher über 40 Schritte. Die Qualität trainierter 70B- oder 120B-Modelle haben wir nicht bewertet.
- Energie
- Sie bezieht sich allein auf die GPU.
- Außerhalb des Umfangs
- Wir haben weder das Training aller Parameter eines Modells noch den Einsatz mehrerer miteinander verbundener Rechner gemessen.
Aktualisierungen und Korrekturen: Diese Seite wird überarbeitet, falls eine neue Version von Unsloth, vLLM oder DGX OS diese Ergebnisse ändert; jede Korrektur wird datiert.
#Für wen der ATOM die richtige Wahl ist
- Ein KMU oder eine Kanzlei, das bzw. die ein kleines Modell auf die eigenen Dokumente spezialisieren möchte
- 85 Minuten und 1,5 Cent Strom auf GPU-Seite, um bei unserem Satz fiktiver Rechnungen von 26 % auf 95 % perfekte Rechnungen zu kommen, ohne ein einziges Dokument an Dritte zu senden.
- Ein Entwickler oder ein Datenteam, der bzw. das Prototypen baut
- Qwen3-8B mit LoRA, ein 70B oder gpt-oss 120B mit QLoRA: Alle drei passen auf denselben Rechner, mit Spitzenwerten von 33 bis 64 GB GPU-Speicher.
- Ein Team, das an einem Ort trainieren, evaluieren und bereitstellen möchte
- Derselbe Rechner hat den Adapter trainiert, drei Modelle bewertet und die Antworten mit vLLM bereitgestellt.
- Ein Büro ohne Serverraum
- Ein Gehäuse mit einem Liter Volumen (150 × 150 × 50,5 mm, 1,2 kg), das über ein USB-C-Netzteil mit 240 W versorgt wird.
Trennen wir zwischen Plattform und Hersteller. Der Chip NVIDIA GB10, seine 128 GB Unified Memory mit 273 GB/s, CUDA und DGX OS 7.5.0 bestimmen den Großteil der Trainingsgeschwindigkeiten. Bei der Inferenz weichen unsere Messwerte höchstens um 4,3 % von den für den DGX Spark veröffentlichten Werten ab; die Trainingsläufe dieses Leitfadens wurden auf dem AI TOP ATOM durchgeführt.
GIGABYTE liefert das Gehäuse und dessen Kühlung mit zwei Lüftern. Während der 87 Minuten Aufzeichnung des Trainings, bei durchschnittlich 53 W auf GPU-Seite, lag die Temperatur im Durchschnitt bei 65 °C und höchstens bei 77 °C, ohne dass eine Drosselung gemeldet wurde.
Preise erfasst am 8. Oktober 2026 für den ATAGB10-9001 (128 GB, SSD mit 4 TB und PCIe 4.0): 6.346,27 € inkl. MwSt. im offiziellen AORUS-Shop, wo er ausverkauft war; bei Amazon.fr war er auf Lager. Gemessen haben wir das Modell ATAGB10-9000, dessen SSD mit PCIe 5.0 arbeitet. Die GB10-Preise ändern sich jede Woche: Prüfen Sie sie vor dem Kauf.
#FAQ
Wie lange dauert das Fine-Tuning eines Modells mit 8 Milliarden Parametern auf einer GB10?+
Lässt sich ein 70B-Modell oder gpt-oss 120B auf 128 GB per Fine-Tuning anpassen?+
Kann ein kleines trainiertes Modell ein großes Modell wirklich übertreffen?+
Was kostet der Strom für ein Fine-Tuning?+
Wie verwenden Sie den Adapter nach Abschluss des Trainings?+
Benötigen Sie für das Fine-Tuning die ATOM-Version mit 128 GB?+
Haben Sie Feedback, einen Fehler entdeckt oder möchten Sie etwas präzisieren? Geben Sie uns Bescheid – so wird der Guide für alle besser.