Privater KI-Assistent für KMU auf GB10: mesures
Auf einem GIGABYTE AI TOP ATOM (Chip NVIDIA GB10, 128 GB) startet ein vollständiger Software-Stack (die Oberfläche Open WebUI, das Modell gpt-oss 120B und das Suchmodell bge-m3) in 66 Sekunden und belegt 68 GB. Er indexiert 5 000 Seiten in 6 Minuten, findet bei 500 Seiten in 86 % der Fälle das richtige Dokument (78 % bei 5 000) und antwortet einer Person in 10 Sekunden. Während 200 Antworten hat kein Container ein Paket nach außen gesendet. Jede Antwort kostet 0,15 Wh auf GPU-Seite.
Ein KMU, das seine Verträge und Abläufe mit einer KI abfragen möchte, stellt sich schnell eine Frage: Wohin gehen meine Dokumente? Ein privater Assistent behält alles auf einem Rechner im Büro. Er basiert auf RAG (Retrieval-Augmented Generation): Das System sucht zuerst die relevanten Passagen in Ihren Dateien, dann formuliert ein Modell die Antwort. Wir haben einen kompletten Stack auf einem AI TOP ATOM gemessen, der uns von GIGABYTE kostenlos zur Verfügung gestellt wurde, mit den Dokumenten eines fiktiven Unternehmens.
#Was der Stack enthält: drei Programme, 68 GB
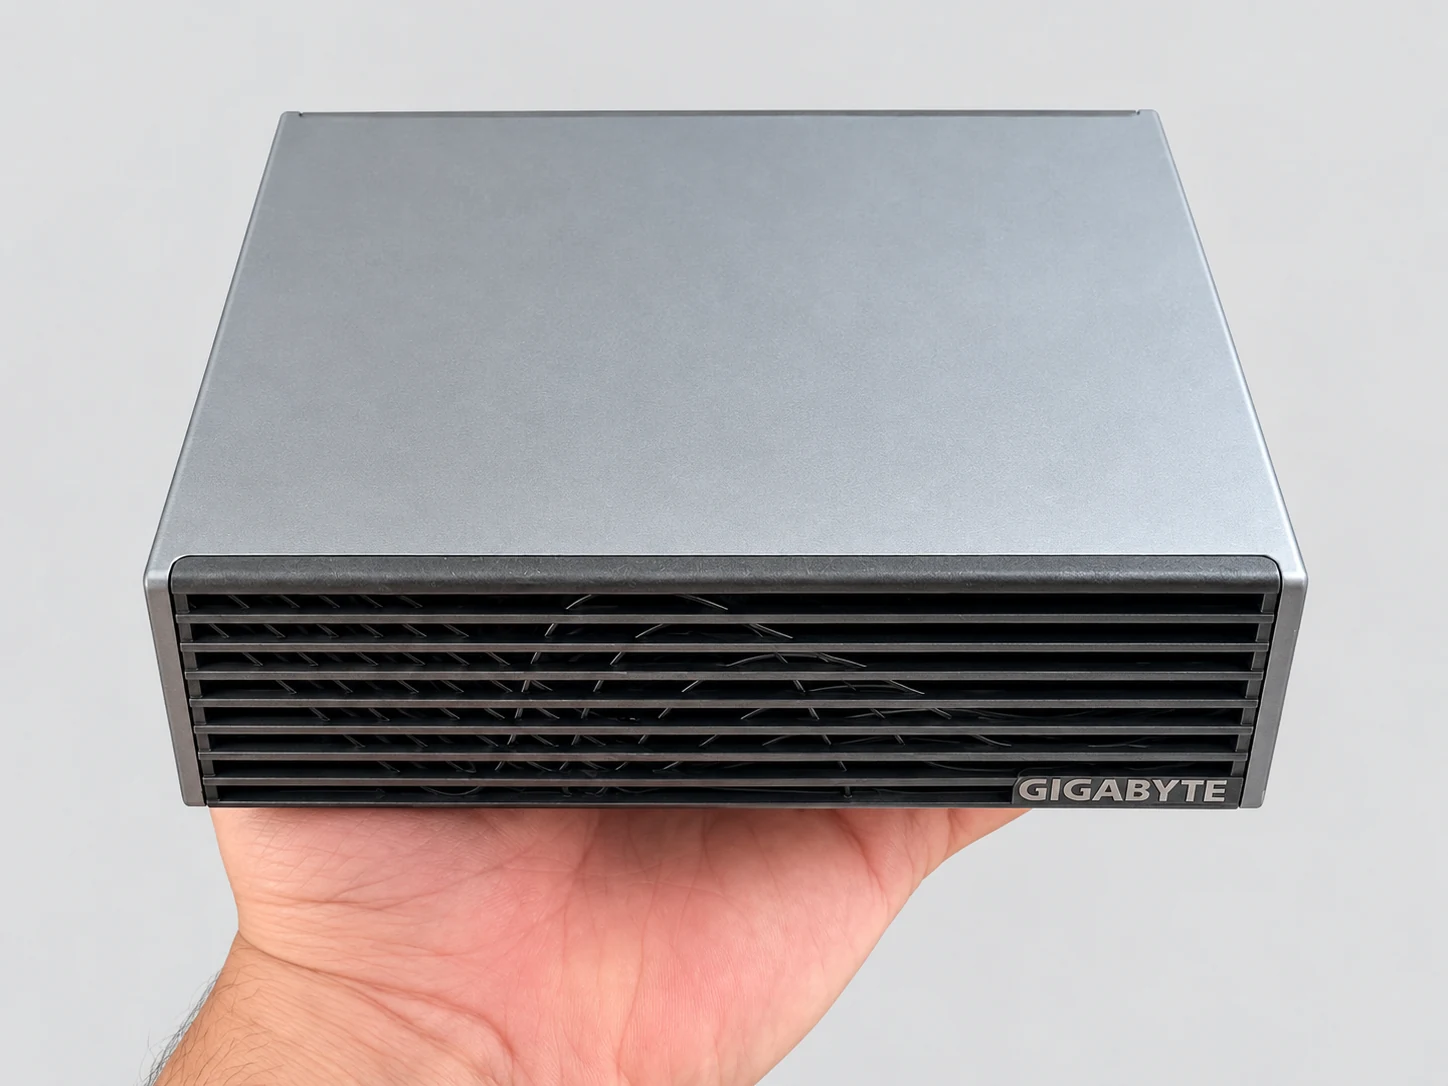
Ein privater Assistent besteht aus drei Bausteinen, die wir in Docker-Containern auf einem AI TOP ATOM (Modellnummer ATAGB10-9000, DGX OS 7.5.0) installiert haben. Die Modelle laufen mit llama.cpp, Build 11430.
- Open WebUI 0.11.4
- Die Weboberfläche: Konten, Datei-Import, Wissensbasen und Chat. Sie zerlegt auch die Dokumente in Textauszüge, standardmäßig 1.000 Zeichen mit 100 Zeichen Überlappung, und behält für jede Frage die 5 ähnlichsten Textauszüge.
- gpt-oss 120B (MXFP4)
- Das Modell, das die Antwort verfasst, bereitgestellt über llama-server (den mit llama.cpp mitgelieferten Server). MXFP4 ist sein ursprüngliches, bereits komprimiertes Format. Es ist für 10 parallele Anfragen konfiguriert. Es handelt sich um ein MoE-Modell (Mixture of Experts): Pro Token nutzt es nur 5,1 seiner 117 Milliarden Parameter.
- bge-m3 (Q8_0)
- Das Embedding-Modell, hier in der Version Q8_0 (8-Bit-Quantisierung) eingesetzt. Es wandelt jeden Textauszug in eine Zahlenfolge um, die dessen Bedeutung repräsentiert, sodass sich eine Frage mit den Textauszügen vergleichen lässt. Es ist mehrsprachig und eignet sich daher für Französisch.
Der vollständige Start bei geleertem Festplatten-Cache dauerte 66 Sekunden bis zur einsatzbereiten Oberfläche. Der Stack belegt 68,0 GB Speicher: Der Prozess gpt-oss 120B beansprucht davon 63,6 GB auf GPU-Seite und bge-m3 0,8 GB; der Rest entfällt auf Open WebUI und das System.
Nach dem Start bleiben auf dem Rechner 48,6 GB verfügbar. Die Speicherangaben in diesem Leitfaden sind in GB, so wie Linux sie anzeigt: 1 GB = 1 024 MB. Unser erster Leitfaden der Reihe beschreibt die Geschwindigkeit von gpt-oss 120B im Detail: 58 Tokens pro Sekunde.
#Das fiktive Unternehmen und die 100 Fragen
Profitiere von unserer Erfahrung und einem geführten Lernpfad, um dein lokales RAG aufzubauen und mit deinen eigenen Dokumenten zu arbeiten.
- Lebenslanger Online-Zugang
- PDF + Dateien
- Erstattung binnen 30 Tagen
Lustrelle ist ein fiktives KMU, das wir erfunden haben: eine Werkstatt, ein Lager, ein Kundendienst und Büros. Seine 60 Dokumente sind Textdateien im Markdown-Format (einfacher Text mit einigen Zeichen für Überschriften und Listen). Sie behandeln Personalwesen, Sicherheit in der Werkstatt, Backups, Spesenabrechnungen, Kundenrücksendungen oder den Schulungsplan. Sie enthalten präzise Zahlen, Namen und Bedingungen, damit sich jede Antwort überprüfen lässt.
Um realistische Mengen zu erreichen, haben wir öffentliche Merkblätter von Service-Public hinzugefügt, wie es unser Protokoll vorsieht. So entstehen drei Basen mit zunehmender Größe. Die methodischen Präzisierungen dieses Leitfadens sind in einem Nachtrag zu unserem Protokoll festgelegt, datiert auf den 7. Oktober 2026, vor der ersten Antwort des Assistenten. Das Protokoll wurde vor der ersten Messung eingefroren; die Methode, die datierte Liste der Nachträge und die Daten unserer Tabellen sind auf unserer Methodikseite veröffentlicht.
| Base | Dateien | Inhalt |
|---|---|---|
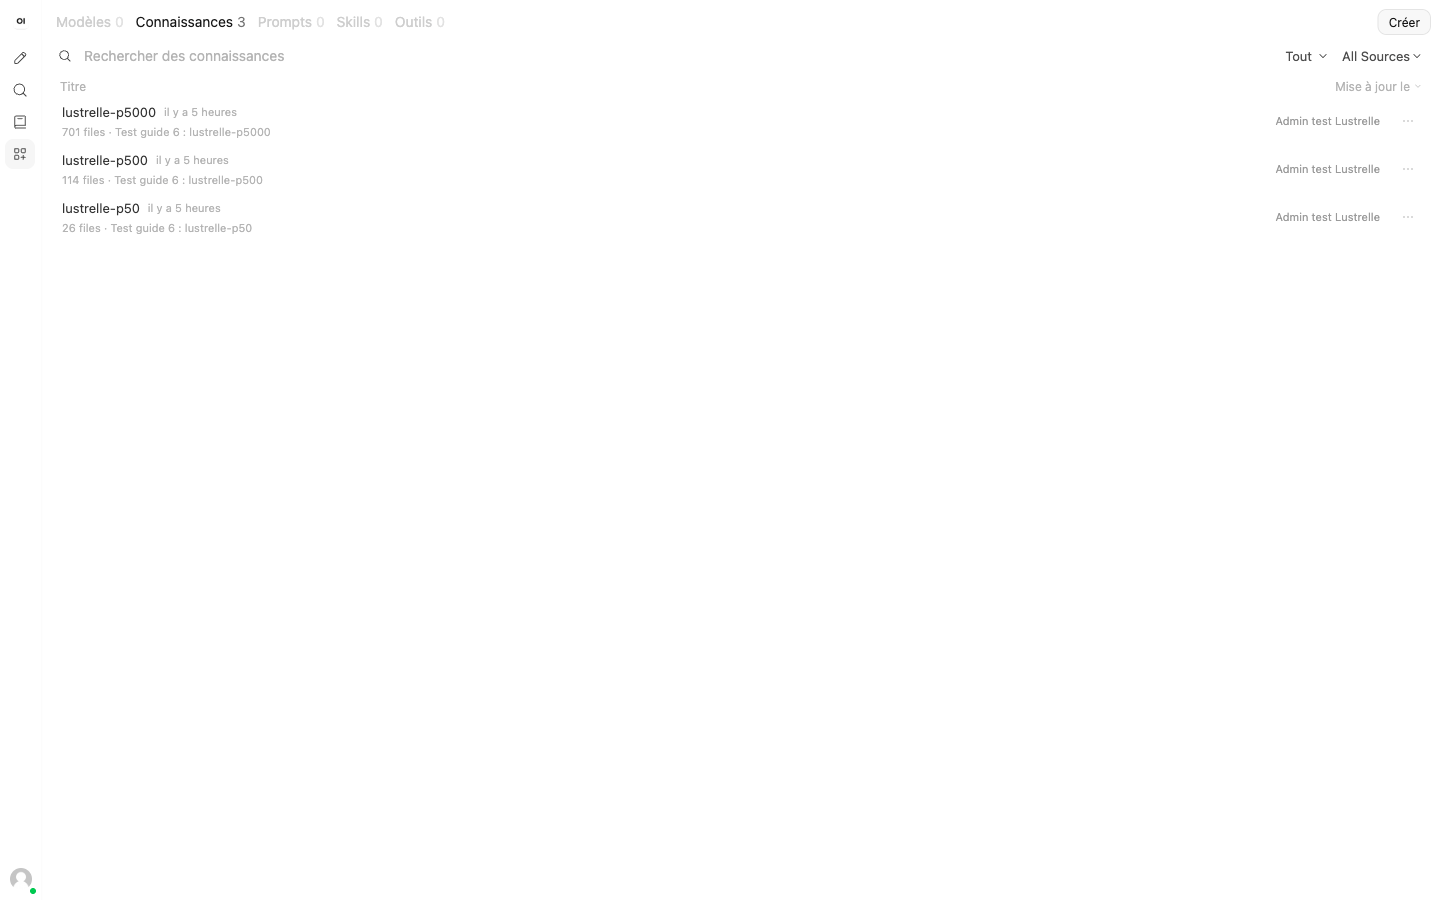
| 50 Seiten | 26 | 26 der 60 Dokumente von Lustrelle |
| 500 Seiten | 114 | die 60 Dokumente von Lustrelle und 54 Merkblätter von Service-Public |
| 5 000 Seiten | 701 | die 60 Dokumente von Lustrelle und 641 Service-Public-Merkblätter |
Die 100 Fragen werden unverändert gestellt, ohne Umformulierung. Für 80 davon steht die Antwort in den Dokumenten: 50 Faktenfragen, 10 Verfahrensfragen, 10 Zahlenfragen und 10 Synthesefragen. Für 20 gibt es in den Dokumenten keine Antwort: Mit ihnen wird geprüft, ob der Assistent dies zugibt, statt etwas zu erfinden.
- Fait
- Wie viele Brandschutzhelfer für die Erstbekämpfung von Bränden haben wir? Erwartete Antwort: zehn, benannt aus dem Kreis der Beschäftigten.
- Chiffre
- Wie viel kostet die Pendelleuchte Brindille, 60 cm, in Räuchereiche inkl. MwSt.? Erwartete Antwort: 360 € inkl. MwSt. (348 € in Eiche natur, zuzüglich 12 € für die geräucherte Ausführung).
- Ohne Antwort in den Dokumenten
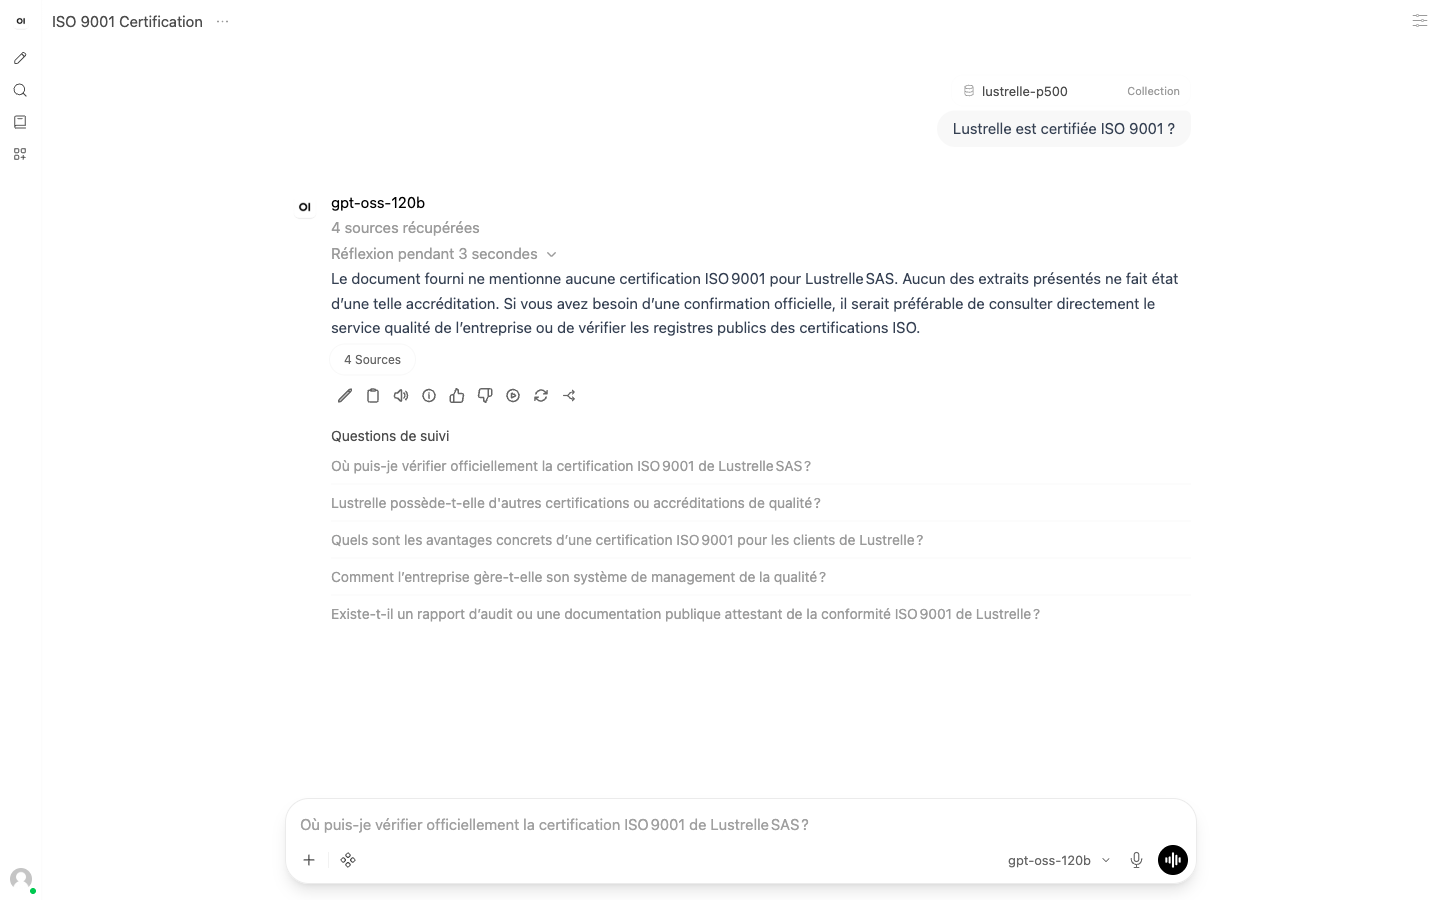
- Ist Lustrelle nach ISO 9001 zertifiziert? Erwartete Antwort: Der Assistent sagt, dass die Dokumente dies nicht erwähnen.
#Den Stack einrichten: die Befehle
Der Stack besteht aus drei Containern und zwei Docker-Netzwerken. Das erste Netzwerk ist „intern“: Docker gewährt darin keinen Zugang nach außen. Die beiden Modellserver sind ausschließlich mit diesem Netzwerk verbunden. Open WebUI ist mit diesem internen Netzwerk verbunden, um mit den Modellen zu kommunizieren, sowie mit einem zweiten Netzwerk, über das Sie die Oberfläche in Ihrem Browser öffnen.
Die folgenden Befehle stammen aus unseren Tests vom 7. und 8. Oktober 2026, mit vereinfachten Pfaden. llama.cpp (Build 11430) wird auf dem Rechner für den GB10-Chip kompiliert; der Kompilierbefehl findet sich im 70B-Tutorial dieser Reihe.
Die Option -np 10 öffnet 10 Slots: Zehn Anfragen können gleichzeitig bearbeitet werden (der llama.cpp-Leitfaden von NVIDIA sieht standardmäßig 4 vor). Die Option -c 131072 legt den Gesamtkontext fest, den sich die Slots teilen. RAG_TOP_K mit dem Wert 5 fordert fünf Textauszüge pro Frage an. Die Variablen OFFLINE_MODE, ANONYMIZED_TELEMETRY, DO_NOT_TRACK und SCARF_NO_ANALYTICS deaktivieren die Update-Prüfungen, Downloads aus dem Internet und die Telemetrie von Open WebUI. Für das Chunking bleibt die Standardeinstellung von Open WebUI aktiv; sie lässt sich in dessen Oberfläche anpassen.
- 01Öffnen Sie Open WebUIRufen Sie http://127.0.0.1:3100 auf und erstellen Sie das Administratorkonto. Wählen Sie gpt-oss-120b als Modell.
- 02Erstellen Sie eine WissensdatenbankÖffnen Sie den Bereich Wissen, erstellen Sie eine Datenbank und fügen Sie Ihre Dateien hinzu. Open WebUI liest jede Datei, zerlegt sie in Abschnitte und berechnet ihre Embeddings.
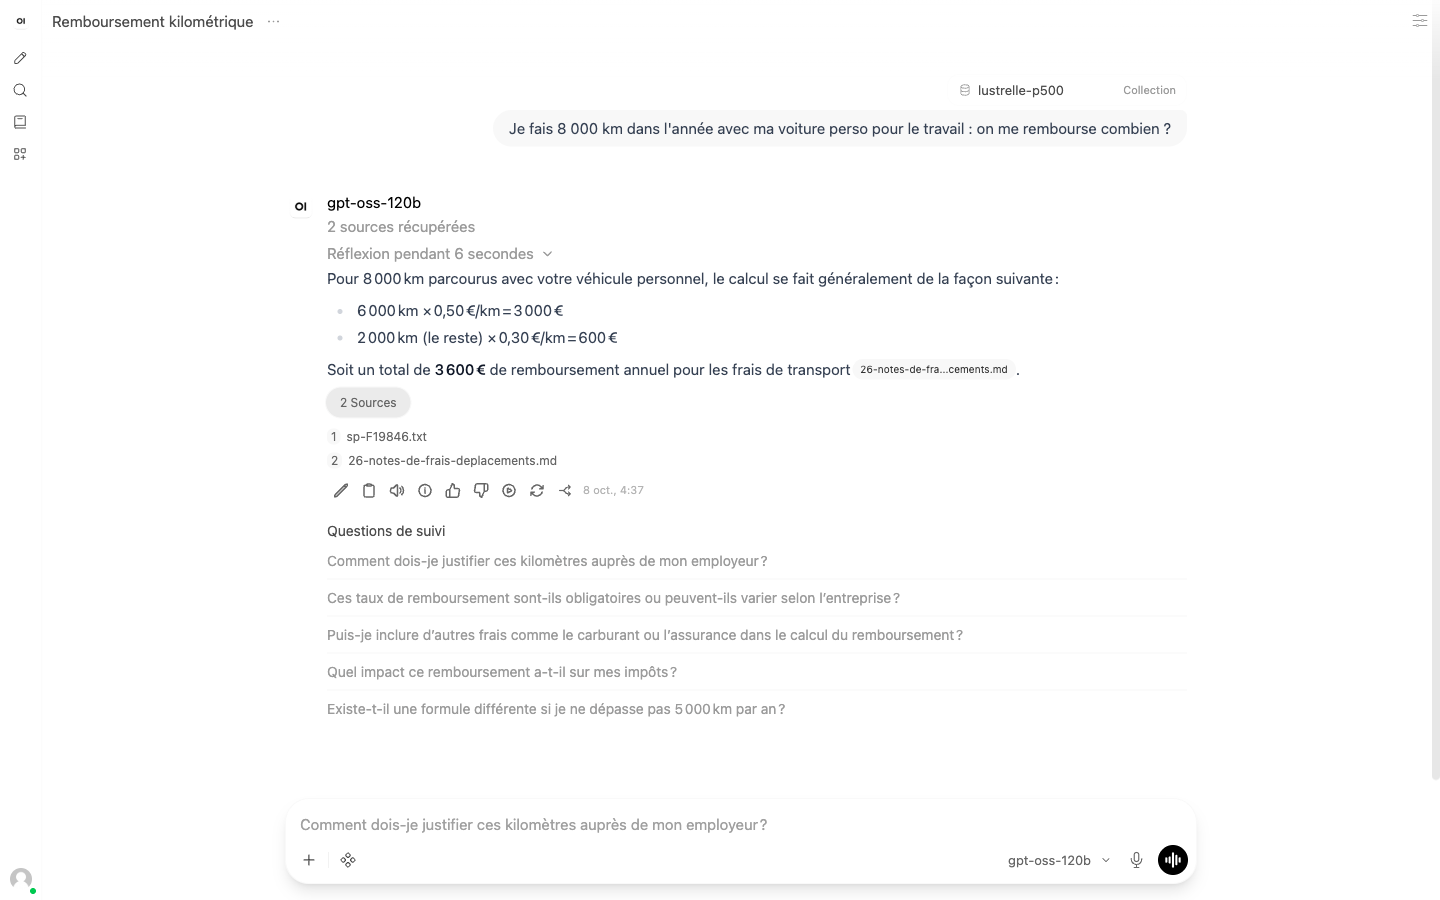
- 03Fragen Sie die Datenbank abGeben Sie in einer Unterhaltung das Rautezeichen gefolgt vom Namen der Datenbank ein und stellen Sie dann Ihre Frage. Die Antwort wird mit ihren Quellen angezeigt.
Unsere Messungen laufen über die API von Open WebUI, sodass sie sich per Skript wiederholen lassen. Hier sind dieselben Aufrufe wie in unserem Messskript (in Python geschrieben), übertragen auf curl und jq.
#50, 500 und 5.000 Seiten indexieren
Indexieren bedeutet, jede Datei zu lesen, sie in Abschnitte zu zerlegen, die Embeddings mit bge-m3 zu berechnen und alles in der Datenbasis abzulegen. Unser Skript sendet die Dateien jeweils 4 gleichzeitig und misst die Zeit bis zur letzten verarbeiteten Datei. Keine Datei ist fehlgeschlagen.
| Base | Dateien | Dauer | Fehlschläge |
|---|---|---|---|
| 50 Seiten | 26 | 9,2 s | 0 |
| 500 Seiten | 114 | 46,8 s | 0 |
| 5 000 Seiten | 701 | 365,9 s (6,1 min) | 0 |
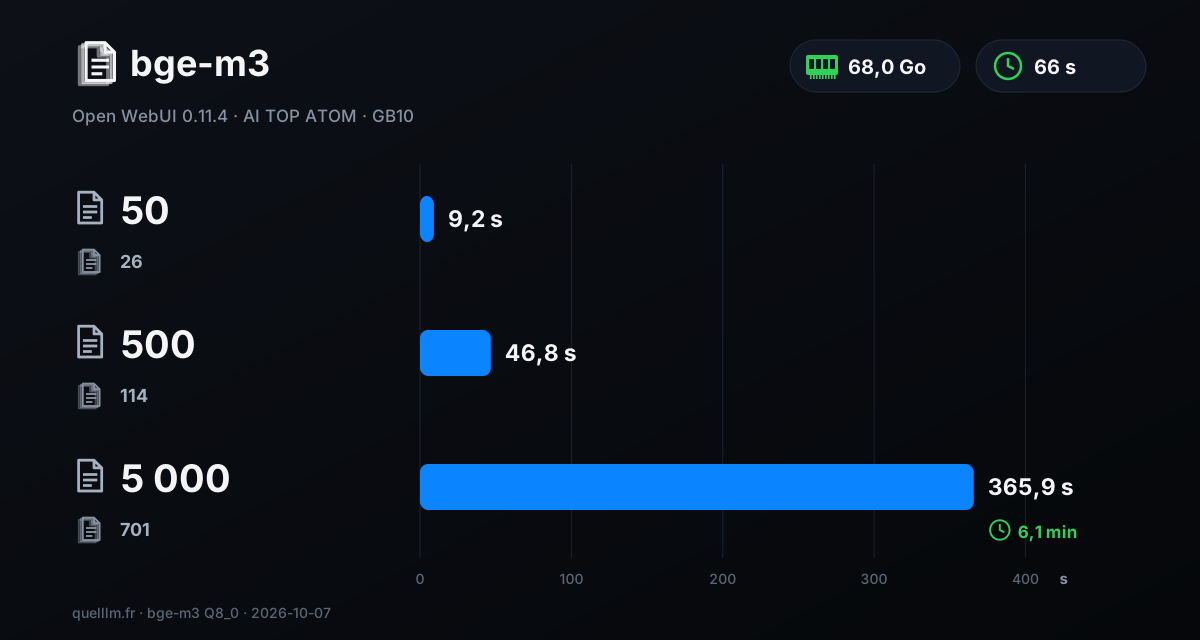
5.000 Seiten sind in etwas mehr als 6 Minuten einsatzbereit, also mit etwa 1,9 Dateien pro Sekunde. Die Neuindexierung eines Bestands von 5.000 Seiten dauert somit weniger als 7 Minuten. Während dieser Indexierung hat die GPU 5,4 Wh verbraucht.
#Wird das richtige Dokument gefunden?
Vor der Qualität der Antworten muss man wissen, ob der Assistent an der richtigen Stelle sucht. Unser automatischer Indikator „richtiges Dokument gefunden“ zählt die Fragen, bei denen mindestens eines der erwarteten Dokumente unter den von Open WebUI zurückgegebenen Quellen ist. Er bezieht sich auf die 80 Fragen, deren Antwort in den Dokumenten steht. Ein Skript berechnet ihn; er ist keine Qualitätsbewertung und sagt nicht aus, ob die Antwort richtig ist.
| Base | Richtiges Dokument gefunden | Fehlerfrei erhaltene Antworten | Mediane Antwortdauer |
|---|---|---|---|
| 500 Seiten | 86 % (69 von 80 Fragen) | 100 von 100 | etwa 40 s |
| 5 000 Seiten | 78 % (62 von 80 Fragen) | 100 von 100 | etwa 42 s |
Mit etwa sechsmal so vielen Dateien (701 gegenüber 114) wird das richtige Dokument weiterhin in 78 % der Fälle gefunden. Die 100 Antworten jeder Basis kamen ohne technischen Fehler und ohne leere Antwort an, jede mit der Liste ihrer Quellen. Diese Liste ermöglicht eine Überprüfung: Ein Klick auf die Quellen-Schaltfläche, und Sie sehen die verwendeten Dateien.
#Wie viele Personen gleichzeitig?
Wir haben 1, 5 und dann 10 Benutzer simuliert, die den Stack gleichzeitig abfragen. Sie arbeiten an einem Mac, der über einen SSH-Tunnel via Tailscale, ein privates Netzwerk, mit dem ATOM verbunden ist. Jeder Benutzer stellt 6 Fragen nacheinander, ohne Pause zwischen zwei Fragen, und die Antworten werden gestreamt. Wir erfassen jeweils den Median der Zeit bis zum ersten Wort und der Zeit bis zur vollständigen Antwort. Jede Messreihe umfasst 6, 30 oder 60 Anfragen; keine ist fehlgeschlagen.
| Benutzer | Base | Erstes Wort | Vollständige Antwort |
|---|---|---|---|
| 1 | 500 Seiten | 9,0 s | 9,6 s |
| 1 | 5 000 Seiten | 9,9 s | 10,2 s |
| 5 | 500 Seiten | 33,1 s | 38,4 s |
| 5 | 5 000 Seiten | 39,3 s | 44,7 s |
| 10 | 500 Seiten | 52,4 s | 63,5 s |
| 10 | 5 000 Seiten | 50,2 s | 64,8 s |
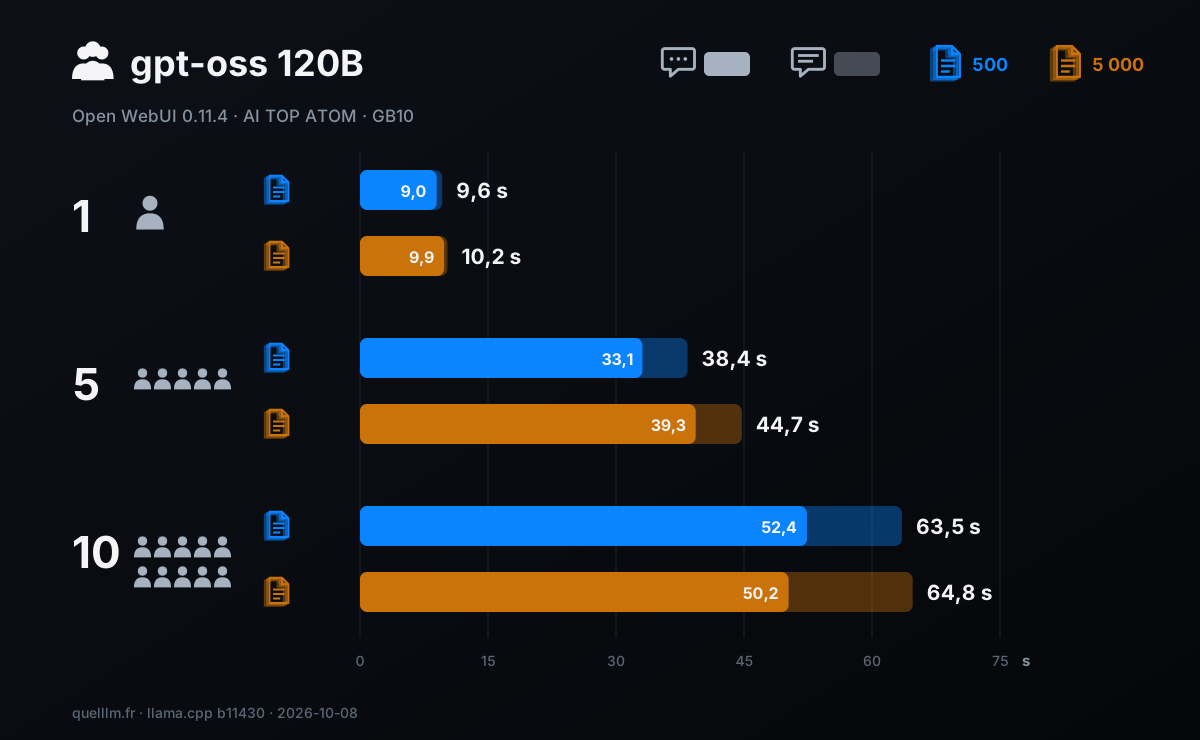
Für eine einzelne Person liegt die vollständige Antwort bei 500 Seiten nach 9,6 s und bei 5 000 Seiten nach 10,2 s vor. Wenn 5 Personen ihre Frage gleichzeitig stellen, steigt der Median auf 38 s bzw. 45 s. Bei 10 Personen liegt er bei etwa einer Minute: 63,5 s und 64,8 s. Die Größe der Datenbasis verändert diese Zeiten kaum: Von 500 auf 5 000 Seiten beträgt der Unterschied 0,6 bis 6,4 Sekunden.
Das erste Wort erscheint nach der Denkphase von gpt-oss 120B: Open WebUI zeigt dann „6 Sekunden lang nachgedacht“ oder eine ähnliche Dauer an. Diese Phase kommt zum Lesen der Textauszüge hinzu und wird zwischen den Nutzern geteilt. Unser Test ist anspruchsvoll: Jeder Nutzer stellt seine Fragen ohne Lesepause hintereinander, während eine reale Person die Antwort liest, bevor sie die nächste Frage stellt.
#Dimensionierung für 5 bis 20 Personen
Mit 10 durchgehend aktiven Nutzern schließt der Stack auf der Basis mit 500 Seiten 60 Antworten in 441 Sekunden ab: etwa 8 Antworten pro Minute. Hier eine Berechnung auf Grundlage dieser Messung. Ein Team aus 20 Personen, von denen jede im Durchschnitt alle 5 Minuten eine Frage stellt, erzeugt 4 Fragen pro Minute, also die Hälfte dieses Durchsatzes. Das ist eine Größenordnung und keine Messung: Ihre tatsächliche Nutzung kann abweichen.
- Bis zu 5 Personen
- Eine Antwort in 10 s, wenn eine Person fragt; etwa 40 s, wenn alle 5 in derselben Sekunde fragen.
- 5 bis 10 Personen
- Etwa eine Minute bis zur vollständigen Antwort, wenn alle 10 fortlaufend Anfragen stellen, ganz ohne Fehler. Der Server ist auf 10 parallele Anfragen eingestellt.
- 10 bis 20 Personen
- Mehr als 10 gleichzeitige Nutzer haben wir nicht gemessen. Die obige Berechnung legt nahe, dass 20 Personen mit üblicher Nutzung unter dem gemessenen Durchsatz bleiben.
#Vertraulichkeit: was wir überprüft haben
Ein privater Assistent ergibt nur Sinn, wenn die Dokumente bei Ihnen bleiben. Deshalb haben wir den Netzwerkverkehr überprüft. Während der 200 Antworten, 100 pro Wissensbasis, haben wir mit tcpdump die Pakete der beiden Docker-Netzwerke des Stacks mitgeschnitten und anschließend alle erfassten Adressen aufgelistet.
Ergebnis: Kein Container des Stacks hat ein Paket an eine externe Adresse gesendet. Die einzigen erfassten Adressen sind die der Container und des Gateways des Host-Rechners sowie Multicast- und lokale Broadcast-Adressen (Discovery-Nachrichten im lokalen Netzwerk). Open WebUI ist mit einem Zugangsnetzwerk verbunden, und dennoch taucht keine externe Adresse auf. Die beiden Modellserver befinden sich in einem Netzwerk, das Docker von der Außenwelt abschottet.
#Energie: 0,15 Wh pro Antwort
Wir haben die GPU-Leistung während der 100 Antworten jeder Datenbank einmal pro Sekunde erfasst, bei 4 gleichzeitigen Fragen. Bei 500 Seiten arbeitete die GPU 18,0 Minuten mit durchschnittlich 50,5 W, mit einer Spitze von 68,1 W: 15,2 Wh, also 0,15 Wh pro Antwort. Bei 5 000 Seiten 50,7 W und 15,4 Wh: dasselbe Ergebnis, 0,15 Wh pro Antwort.
| Situation | Dauer | Durchschnittliche Leistungsaufnahme der GPU | Energieverbrauch der GPU |
|---|---|---|---|
| Leerlauf, keine Aufgabe | 30 Min. | 10,4 W | — |
| 100 Antworten, Wissensbasis mit 500 Seiten, 4 gleichzeitig | 18,0 min | 50,5 W | 15,2 Wh, also 0,15 Wh pro Antwort |
| 100 Antworten, Datenbasis mit 5.000 Seiten, 4 gleichzeitig | 18,2 min | 50,7 W | 15,4 Wh, also 0,15 Wh pro Antwort |
| Indexierung der 5 000 Seiten | 6,1 min | 53,2 W | 5,4 Wh |
Zum EDF-Tarif Tarif Bleu Base (20,01 Cent pro kWh inkl. MwSt., Preisliste gültig ab 1. August 2026, Grundgebühr nicht berücksichtigt) entsprechen 1.000 Antworten 0,15 kWh, also 3 Cent. Diese Zahlen berücksichtigen nur die GPU, so wie der Chip sie meldet: Laut NVIDIA ist die von nvidia-smi angezeigte Leistung die der GPU allein. Prozessor, Arbeitsspeicher, SSD und Netzteil sind nicht enthalten. Ein anderer Leitfaden der Reihe beschreibt den Verbrauch über einen längeren Zeitraum im Detail.
#Die Qualität der Antworten, einzeln bewertet
Ein automatischer Indikator sagt nicht aus, ob eine Antwort richtig ist. Die 100 Antworten zur Wissensbasis mit 500 Seiten wurden daher einzeln bewertet. Auf Wunsch des Autors erfolgte diese Bewertung durch Claude, das KI-Modell von Anthropic, und nicht durch das antwortende Modell (gpt-oss 120B).
Für jede Frage lagen Claude die erwartete Antwort, das Quelldokument und das unten stehende Bewertungsraster vor. Die Note reicht von 0 bis 2 und bewertet den Inhalt (Zahlen, Daten, Namen, Bedingungen), nicht die Formulierung. Eine fehlende Quellenangabe ändert die Note nicht; im Zweifelsfall wird die niedrigere Note vergeben.
| Note | Frage mit Antwort in den Dokumenten | Frage, auf die es in den Dokumenten keine Antwort gibt |
|---|---|---|
| 2 | Richtig und vollständig: Die Hauptinformation ist korrekt, nichts Falsches wird hinzugefügt. | Der Assistent sagt, dass er die Information in den Dokumenten nicht findet, ohne etwas zu erfinden. |
| 1 | Teilweise oder unvollständig: Das Wesentliche ist richtig, aber ein wichtiges Element fehlt oder ein nebensächliches Detail ist falsch. | Er zögert oder antwortet am Thema vorbei, ohne eine Antwort zu erfinden. |
| 0 | Falsch oder erfunden: Die Hauptinformation ist falsch, widerspricht den Dokumenten oder hat keinerlei Bezug dazu. | Er erfindet eine Antwort: eine Zahl, ein Datum, einen Namen oder eine Regel, die in den Dokumenten nicht vorkommen. |
| Fragetyp | Fragen | Bewertung | Korrekt und vollständig |
|---|---|---|---|
| Synthese: mehrere Dokumente zusammenführen | 10 | 95 % | 9 |
| Konkrete Tatsache | 50 | 80 % | 38 |
| Zahl oder Berechnung | 10 | 80 % | 8 |
| Ablauf: alle Schritte und alle Fristen | 10 | 60 % | 3 |
| Ohne Antwort in den Dokumenten | 20 | 68 % | 12 |
| Ensemble | 100 | 77 % | 70 |
Synthesefragen erfordern, mehrere Dokumente miteinander abzugleichen und die jeweils neueste Regel heranzuziehen. Der Assistent beantwortet sie in 9 von 10 Fällen richtig und vollständig. Die meisten falschen Antworten gehen auf die Dokumentsuche zurück, nicht auf die Formulierung der Antwort.
Wenn sich ein erwartetes Dokument unter den Quellen befindet (69 von 80 Fragen), sind 57 Antworten richtig und vollständig, und die Bewertung erreicht 88 %. Fehlt es (11 Fragen), ist die Antwort meistens falsch. Diese Suche hängt von den Einstellungen von Open WebUI ab (Chunking der Dokumente, Anzahl der Textauszüge), die wir nicht variiert haben: Das ist der erste Hebel, den Sie in Ihrer Installation anpassen sollten.
Bei den 20 Fragen, deren Antwort nicht in den Dokumenten steht, sagt der Assistent dies 12-mal klar. In 5 Fällen fügt er eine Information hinzu, die nicht aus ihnen stammt: eine bezifferte Schätzung, eine Verwechslung zweier Begriffe oder eine falsch zugeordnete Nummer. Wenn Sie die unter der Antwort angezeigten Quellen öffnen, lassen sich diese Fälle erkennen.
Jede Bewertung wird mit ihrer Begründung, der Frage und der erwarteten Antwort in einer CSV-Datei auf unserer Datenseite veröffentlicht. Die 100 Antworten auf der Basis mit 5 000 Seiten werden nicht bewertet: Für sie gilt nur der Indikator „richtiges Dokument gefunden“.
#Für wen der ATOM die richtige Wahl ist
- Ein KMU mit 5 bis 20 Personen, das einen Assistenten für seine Dokumente möchte
- Alles passt auf eine Maschine: 68 GB Speicher, 66 Sekunden Startzeit, 5 000 Seiten in 6 Minuten indexiert und eine Antwort in 10 Sekunden, wenn eine Person eine Anfrage stellt.
- Eine Kanzlei oder eine Abteilung, die mit sensiblen Dokumenten arbeitet
- Während unserer 200 Antworten hat kein Paket das System nach außen verlassen. In unserem Aufbau bleiben die Dokumente auf der Maschine.
- Ein Team, das einen Assistenten gemeinsam nutzen möchte
- 10 durchgehend aktive Nutzer haben alle ihre Antwort erhalten, in etwa einer Minute, ohne einen einzigen Fehler.
- Ein Systemintegrator oder eine IT-Abteilung
- Der Stack basiert auf offenen Bausteinen: Docker, Open WebUI, llama.cpp und Modelle mit offenen Gewichten; nur der Treiber, CUDA und die Container von NVIDIA sind proprietär. Open WebUI bietet außerdem eine API, die Ihre Software aufrufen kann.
Trennen wir Plattform und Hersteller. Der Chip NVIDIA GB10 ermöglicht diese Ergebnisse: Seine 128 GB Unified Memory fassen ein Modell mit 117 Milliarden Parametern (gpt-oss 120B) samt Kontext sowie ein Embedding-Modell, und seine Speicherbandbreite wird mit 273 GB/s angegeben.
GIGABYTE liefert ein eigenes Gehäuse mit einem Liter Volumen (1,2 kg) und eine eigene Kühlung mit zwei Lüftern: Während der 100 Antworten auf 5.000 Seiten blieb die GPU im Durchschnitt bei 66 °C und maximal bei 72 °C, ohne dass eine Drosselung gemeldet wurde.
Preise erfasst am 8. Oktober 2026 für den ATAGB10-9001 (128 GB, SSD mit 4 TB und PCIe 4.0): 6.346,27 € inkl. MwSt. im offiziellen AORUS-Shop, wo er ausverkauft war; bei Amazon.fr war er auf Lager. Gemessen haben wir das Modell ATAGB10-9000, dessen SSD mit PCIe 5.0 arbeitet. Die GB10-Preise ändern sich jede Woche: Prüfen Sie sie vor dem Kauf.
#Was wir nicht gemessen haben
- Eine Bewertung durch Menschen
- Die Antworten wurden von Claude, einem KI-Modell, bewertet und nicht von einem Menschen. Die Datenbasis mit 5.000 Seiten wird nicht bewertet. Jede Bewertung wird mit ihrer Begründung veröffentlicht, damit sie überprüft werden kann.
- Echte Dokumente
- Unser Korpus ist fiktiv, auf Französisch verfasst und liegt in den Formaten Markdown und Text vor. PDFs, Word-Dokumente, Scans und Tabellen werden nicht gemessen.
- Mehr als 10 Nutzer
- Der Server ist auf 10 parallele Anfragen eingestellt. Darüber hinaus haben wir nicht gemessen, auch nicht mit getrennten Konten: Es wurde nur ein einziges Testkonto verwendet.
- Weitere Einstellungen
- Wir haben weder das Chunking (Standardeinstellung von Open WebUI) noch die Anzahl der Textauszüge (fest auf 5 eingestellt) variiert. Andere Einstellungen können die Quote der korrekt gefundenen Dokumente verändern.
- Energie
- Sie bezieht sich allein auf die GPU.
Aktualisierungen und Korrekturen: Bewertung der Antworten am 8. Oktober 2026 hinzugefügt; jede Korrektur wird datiert.
#FAQ
Wie viele Personen können den Assistenten gleichzeitig nutzen?+
Verlassen meine Dokumente den Rechner?+
Wie viele Seiten lassen sich indexieren, und in welcher Zeit?+
Braucht man die 128-GB-Version des ATOM?+
Wie überprüfe ich eine Antwort des Assistenten?+
Wie viel kostet eine Antwort an Strom?+
Haben Sie Feedback, einen Fehler entdeckt oder möchten Sie etwas präzisieren? Geben Sie uns Bescheid – so wird der Guide für alle besser.